Mô hình
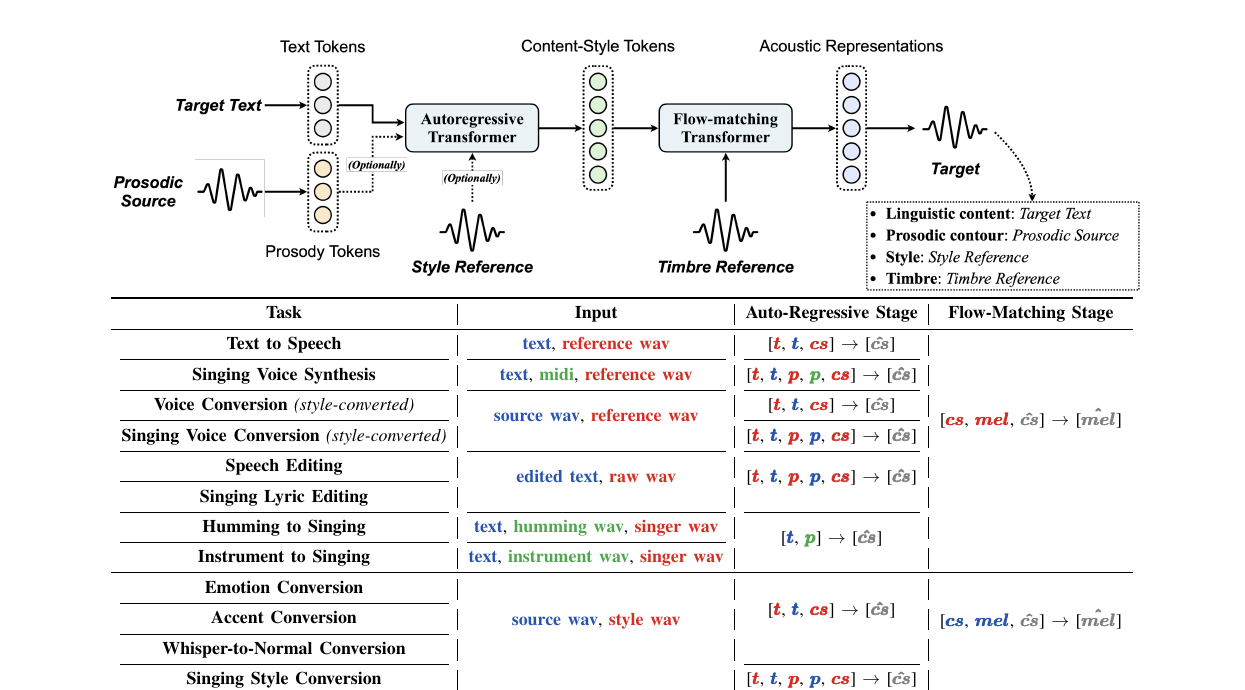
Vevo2: Tổ chức lại giọng hát dựa trên ba điều kiện: nội dung, âm sắc và nhịp điệu.
Ghi chú tổng hợp/kỹ thuật
Ghi chú tổng hợp/kỹ thuật
TỔNG HỢP GIỌNG HÁT / GHI CHÚ KỸ THUẬT
SoulX-Singer tiếp nhận lời ca và MIDI như một bản nhạc tường minh. Vevo2 được dẫn dắt bằng tham chiếu: token nội dung-phong cách và token ngữ điệu được trích xuất từ âm thanh mẫu trước khi mô hình âm học tạo dựng dạng sóng đích. Hai hướng này không nên dùng chung một hợp đồng đầu vào.
Nếu một dòng token đồng thời mang âm vị, cao độ, nhịp điệu và âm sắc, việc thay thế một yếu tố sẽ làm xáo trộn các yếu tố còn lại. Hướng Vevo giảm sự liên kết đó bằng các bộ lượng tử hóa riêng biệt. Với biến ẩn âm học z, token nội dung-phong cách c và token ngữ điệu r, flow matching học:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
Quá trình suy luận tích phân trường vận tốc có điều kiện, sau đó vocoder tái tạo âm thanh. Việc phân tách giúp tăng khả năng điều khiển, nhưng nhạc đệm, đuôi vang của căn phòng và lỗi thời gian trong tham chiếu vẫn có thể lọt vào các token.
Vevo2 phù hợp để chuyển phong cách hát và ngữ điệu từ một tham chiếu. Mô hình không cung cấp từng thời điểm bắt đầu, kết thúc, velocity của nốt MIDI và liên kết giữa lời với âm tiết dưới dạng một hợp đồng chỉnh sửa nghiêm ngặt như nhau. SoulX-Singer vẫn là hướng MIDI trực tiếp; Vevo2 là cấu hình tương ứng được dẫn dắt bằng tham chiếu.
Các biểu diễn nội dung, ngữ điệu và âm sắc của Vevo2 vẫn có thể rò rỉ sang nhau, trong khi tiếng vang, bè phụ và nhạc đệm làm nhiễu lời nhắc. Độ tương đồng giọng nói mô tả hành vi của mô hình; nó không cấp quyền sử dụng danh tính của ca sĩ. Tư liệu tham chiếu và đầu ra cần được cho phép, đồng thời phải công bố rõ đó là nội dung tổng hợp.
Vevo2 là hướng giọng hát zero-shot của Amphion. Mô hình không đọc MIDI như một bản nhạc chính xác; nó tách các biểu diễn nội dung, âm sắc, phong cách và ngữ điệu, rồi kết hợp lại âm thanh lời nhắc với các điều kiện nội dung. Hướng này gần với các công cụ SoulX/YingMusic được điều kiện hóa bằng bản nhạc nhưng không thể dùng thay thế cho nhau.
Các hệ thống chuyển đổi và sinh trước đây thường gói người nói, cảm xúc và nhịp điệu vào một biểu diễn ẩn. Vevo dùng lượng tử hóa và sinh theo cấp bậc để giảm sự liên kết. Khả năng zero-shot đến từ dữ liệu và cách mã hóa lời nhắc; một tham chiếu ngắn bất kỳ không bảo đảm danh tính, lời ca và giai điệu ổn định.
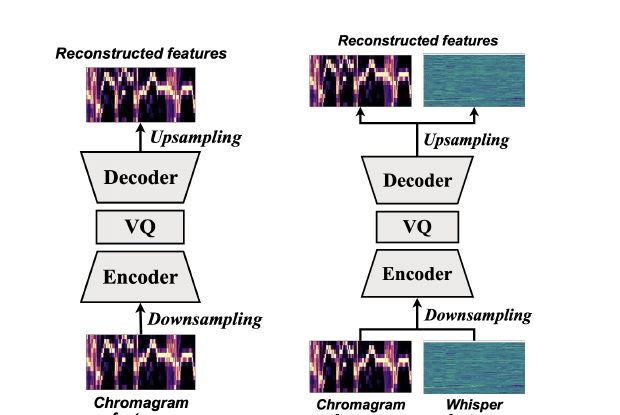
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentbiểu diễn nội dungq_prosodybiểu diễn ngữ điệue_timbreembedding âm sắcTokenizer nội dung giữ lại lời ca và cách phát âm, tokenizer ngữ điệu mang nhịp điệu và đường nét, còn embedding âm sắc cung cấp dấu hiệu nhận dạng. Bộ sinh kết hợp lại ba yếu tố; phân tách biểu diễn là mục tiêu chứ không phải sự bảo đảm.
Hướng được dẫn dắt bằng lời nhắc của Vevo2 không phải là bám theo bản nhạc MIDI. Trước khi so sánh với SoulX/YingMusic, cần xác định mục tiêu là chuyển phong cách dựa trên lời nhắc hay tạo nốt có thể chỉnh sửa với trường độ chính xác.
Có thể theo dõi bài báo, mã nguồn và trọng số qua mã nguồn Amphion Vevo2 / trọng số Vevo2 / bài báo Vevo2.
Mỗi hàng giữ nguyên kiến trúc, chỉ số hoặc định nghĩa tác vụ của nguồn tương ứng; các kết quả không dùng chung giao thức vẫn được tách riêng.
| Mô hình | Kiến trúc hoặc bằng chứng | Phạm vi |
|---|---|---|
| Vevo2 | nội dung cùng lời nhắc zero-shot về phong cách/âm sắc | phân tách, danh tính và biến thiên lấy mẫu |
| SoulX-Singer | giọng hát được dẫn dắt bằng tham chiếu | âm sắc và lời ca trong cùng lời nhắc |
| YingMusic-Singer-Plus | lời ca cùng giai điệu/bản nhạc | nốt, trường độ và khả năng chỉnh sửa |
Hãy lấy mẫu nhiều lần từ cùng một lời nhắc và kiểm tra riêng độ rõ của lời ca, đường nét cao độ, nhịp điệu và âm sắc. Chỉ chọn một kết quả đẹp sẽ che giấu biến thiên; nhạc đệm, bè phụ và tiếng vang khiến việc phân tách khó hơn.
Khi so sánh các hệ thống được dẫn dắt bằng bản nhạc, cần cố định mục tiêu: Vevo2 phù hợp với chuyển phong cách/âm sắc dựa trên lời nhắc, còn các mô hình MIDI/lời ca phù hợp với nốt có thể chỉnh sửa và trường độ chính xác. Chúng không dùng chung một giá trị độ chính xác.
Phân tách biểu diễn không đồng nghĩa với xóa danh tính. Đặc điểm của nguồn và đích có thể rò rỉ, và đầu ra không được bảo đảm là ẩn danh.
Lời nhắc giọng hát phải được cho phép và âm thanh tạo sinh cần được công bố rõ ràng. Độ tương đồng không cho phép mạo danh.
Tên mô hình, con số và giới hạn được truy nguyên từ các bài báo, kho mã hoặc thẻ mô hình dưới đây.