Modell
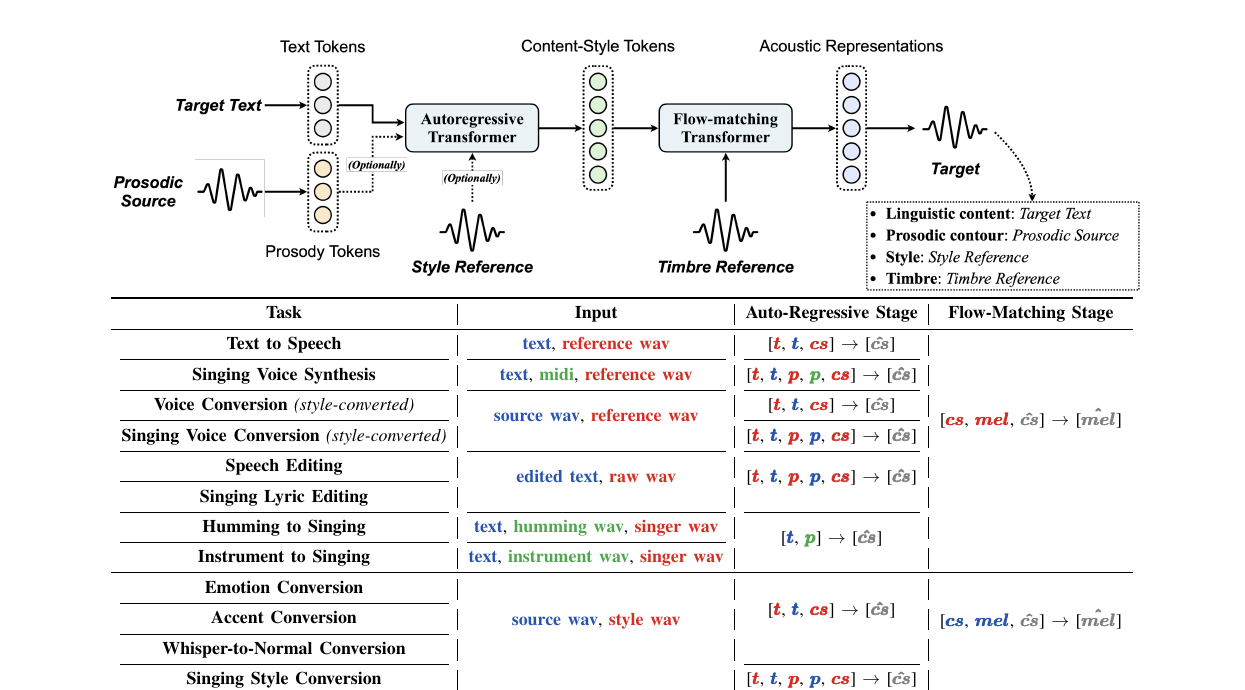
Vevo2: Reorganisation des Gesangs basierend auf drei Bedingungen: Inhalt, Klangfarbe und Rhythmus.
Gesangssynthese/technische Anmerkungen
Gesangssynthese/technische Anmerkungen
© 2026 TelkNet. Alle Rechte vorbehalten.
GESANGSSYNTHESE / TECHNISCHE NOTIZ
SoulX-Singer übernimmt Liedtext und MIDI als explizite Partitur. Vevo2 wird von einer Referenz gesteuert: Inhalt-Stil- und Prosodie-Token werden aus einem Audiobeispiel extrahiert, bevor ein akustisches Modell die Zielwellenform erzeugt. Beide Wege sollten nicht denselben Eingabevertrag verwenden.
Wenn ein Tokenstrom Phoneme, Tonhöhe, Rhythmus und Timbre zugleich trägt, stört der Austausch eines Faktors auch die anderen. Der Vevo-Ansatz verringert diese Kopplung durch getrennte Quantisierer. Für die akustische Latentvariable z, die Inhalt-Stil-Token c und die Prosodie-Token r lernt Flow Matching:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
Bei der Inferenz wird das bedingte Geschwindigkeitsfeld integriert und ein Vocoder rekonstruiert das Audiosignal. Die Trennung verbessert die Steuerbarkeit, doch Begleitung, Raumfahnen und Timingfehler in der Referenz können weiterhin in die Token gelangen.
Vevo2 eignet sich dafür, Gesangsstil und Prosodie aus einer Referenz zu übernehmen. Es stellt nicht jeden MIDI-Einsatz, jedes Ende, jede Anschlagsstärke und jede Zuordnung von Textsilben als gleichermaßen strengen Bearbeitungsvertrag bereit. SoulX-Singer bleibt der direkte MIDI-Weg; Vevo2 ist das entsprechende referenzgesteuerte Profil.
Die Repräsentationen für Inhalt, Prosodie und Timbre in Vevo2 können weiterhin ineinander übergehen, während Hall, Begleitstimmen und Instrumentalbegleitung den Prompt verunreinigen. Stimmähnlichkeit beschreibt das Modellverhalten; sie erteilt keine Erlaubnis, die Identität einer Sängerin oder eines Sängers zu verwenden. Referenzen und Ausgaben benötigen eine Genehmigung und eine klare Kennzeichnung als synthetisch.
Vevo2 ist Amphions Weg für Zero-Shot-Gesang. MIDI wird nicht als exakte Partitur gelesen; stattdessen trennt das System Repräsentationen für Inhalt, Timbre, Stil und Prosodie und kombiniert Prompt-Audio mit Inhaltsbedingungen. Es steht neben partiturkonditionierten SoulX/YingMusic-Werkzeugen, ist aber nicht mit ihnen austauschbar.
Frühere Konvertierungs- und Generierungssysteme bündelten Sprecher, Emotion und Rhythmus häufig in einer einzigen Latentvariablen. Vevo verwendet hierarchische Quantisierung und Generierung, um die Kopplung zu verringern. Die Zero-Shot-Fähigkeit entsteht aus Daten und Prompt-Codierung; eine beliebige kurze Referenz garantiert keine stabile Identität, keinen stabilen Liedtext und keine stabile Melodie.
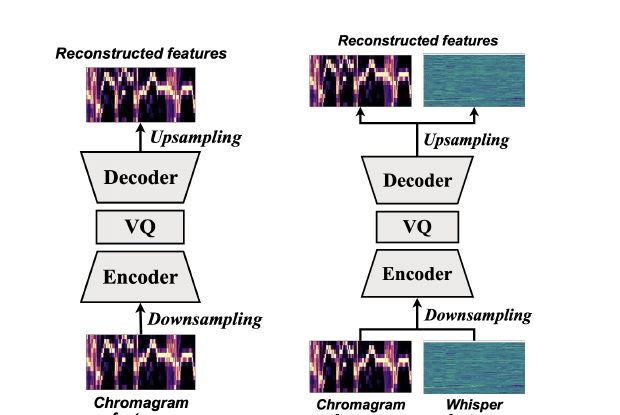
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentInhaltsrepräsentationq_prosodyProsodierepräsentatione_timbreTimbre-EinbettungEin Inhalts-Tokenizer bewahrt Liedtext und Artikulation, ein Prosodie-Tokenizer trägt Rhythmus und Kontur und eine Timbre-Einbettung liefert Identitätshinweise. Der Generator setzt sie wieder zusammen; Entkopplung ist ein Ziel und keine Garantie.
Der promptgesteuerte Weg von Vevo2 folgt keiner MIDI-Partitur. Vor einem Vergleich mit SoulX/YingMusic muss feststehen, ob promptbasierter Stiltransfer oder bearbeitbare Noten und eine exakte Dauer das Ziel sind.
Veröffentlichung, Code und Gewichte lassen sich über Amphion-Vevo2-Quellcode / Vevo2-Gewichte / Vevo2-Veröffentlichung nachverfolgen.
Jede Zeile behält ihre ursprüngliche Architektur, Metrik oder Aufgabendefinition bei; Ergebnisse ohne gemeinsames Protokoll bleiben getrennt.
| Modell | Architektur oder Beleg | Geltungsbereich |
|---|---|---|
| Vevo2 | Inhalt plus Zero-Shot-Stil-/Timbre-Prompt | Entkopplung, Identität und Stichprobenvarianz |
| SoulX-Singer | referenzgesteuerter Gesang | Timbre und Liedtext unter demselben Prompt |
| YingMusic-Singer-Plus | Liedtext plus Melodie/Partitur | Noten, Dauer und Bearbeitbarkeit |
Aus demselben Prompt sollte wiederholt gesampelt werden, um Textverständlichkeit, Tonhöhenkontur, Rhythmus und Timbre getrennt zu prüfen. Das Auswählen eines einzigen Ergebnisses verdeckt die Varianz; Begleitung, Begleitstimmen und Hall erschweren die Entkopplung.
Beim Vergleich partiturgesteuerter Systeme muss das Ziel feststehen: Vevo2 eignet sich für promptbasierten Stil-/Timbretransfer, während MIDI-/Textmodelle bearbeitbare Noten und eine exakte Dauer bieten. Beide Wege besitzen keinen gemeinsamen einzelnen Genauigkeitswert.
Die Entkopplung von Repräsentationen entfernt keine Identität. Eigenschaften von Quelle und Ziel können ineinander übergehen, und die Anonymität der Ausgabe ist nicht garantiert.
Gesangs-Prompts erfordern eine Erlaubnis, und erzeugtes Audio muss klar gekennzeichnet werden. Ähnlichkeit berechtigt nicht zur Identitätsvortäuschung.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die folgenden Veröffentlichungen, Repositories oder Modellkarten zurückführen.