Modèle
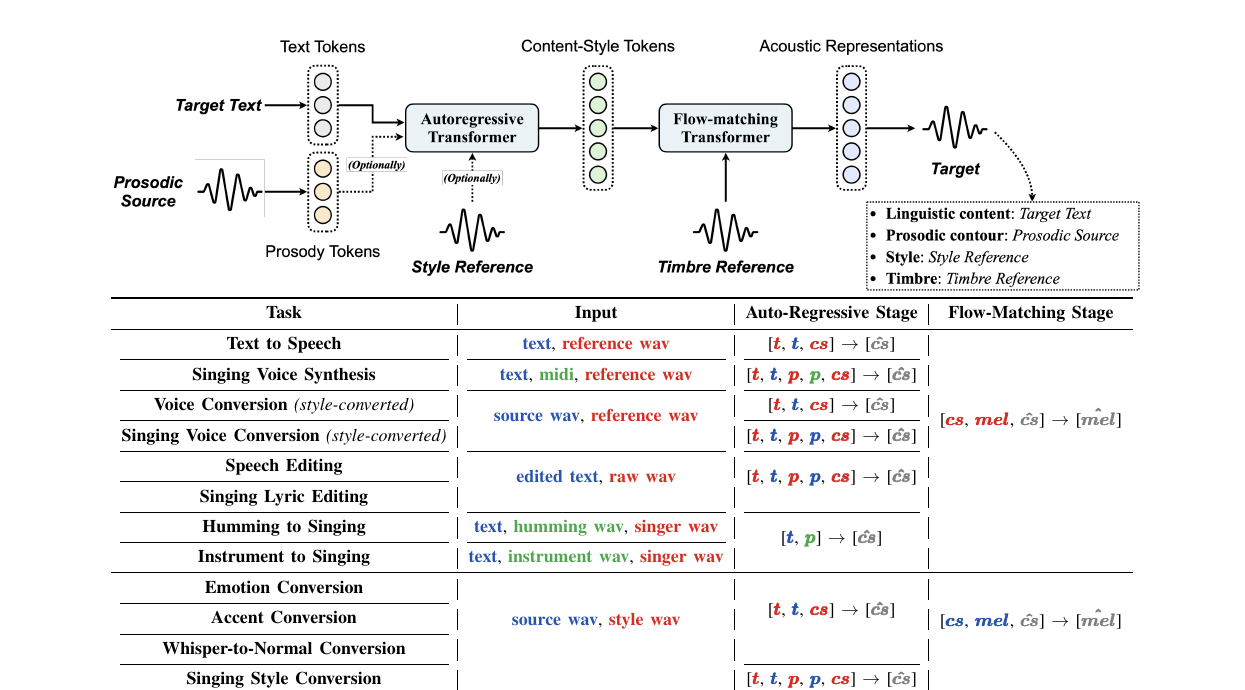
Vevo2 : Réorganisation du chant basée sur trois conditions : contenu, timbre et rythme.
Synthèse chantée/notes techniques Article
Synthèse chantée/notes techniques Article
SYNTHÈSE DU CHANT / NOTE TECHNIQUE
SoulX-Singer accepte les paroles et le MIDI comme partition explicite. Vevo2 est piloté par une référence : les tokens de contenu-style et de prosodie sont extraits d’un exemple audio avant qu’un modèle acoustique ne construise la forme d’onde cible. Ces deux voies ne doivent pas partager un même contrat d’entrée.
Si un même flux de tokens porte les phonèmes, la hauteur, le rythme et le timbre, le remplacement d’un facteur perturbe les autres. La voie Vevo réduit ce couplage au moyen de quantificateurs distincts. Pour la variable latente acoustique z, les tokens de contenu-style c et les tokens de prosodie r, le flow matching apprend :
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
L’inférence intègre le champ de vitesse conditionnel et un vocodeur reconstruit l’audio. La séparation améliore le contrôle, mais l’accompagnement, les queues de réverbération et les erreurs de synchronisation de la référence peuvent encore entrer dans les tokens.
Vevo2 convient au transfert du style vocal et de la prosodie depuis une référence. Il n’expose pas chaque début, fin, vélocité MIDI et alignement entre paroles et syllabes comme un contrat d’édition tout aussi strict. SoulX-Singer reste la voie MIDI directe ; Vevo2 est le profil correspondant piloté par une référence.
Les représentations de contenu, de prosodie et de timbre de Vevo2 peuvent encore se contaminer, tandis que la réverbération, les chœurs et l’accompagnement altèrent le prompt. La similarité vocale décrit le comportement du modèle ; elle n’accorde aucune autorisation d’utiliser l’identité d’une chanteuse ou d’un chanteur. Les références et les sorties nécessitent une autorisation ainsi qu’une mention claire de leur nature synthétique.
Vevo2 est la voie de chant zero-shot d’Amphion. Il ne lit pas le MIDI comme une partition exacte ; il sépare les représentations de contenu, de timbre, de style et de prosodie, puis recombine l’audio du prompt avec les conditions de contenu. Il est voisin des outils SoulX/YingMusic conditionnés par une partition, sans être interchangeable avec eux.
Les anciens systèmes de conversion et de génération regroupaient souvent locuteur, émotion et rythme dans une même variable latente. Vevo emploie une quantification et une génération hiérarchiques pour réduire ce couplage. La capacité zero-shot provient des données et de l’encodage du prompt ; une référence courte quelconque ne garantit pas la stabilité de l’identité, des paroles et de la mélodie.
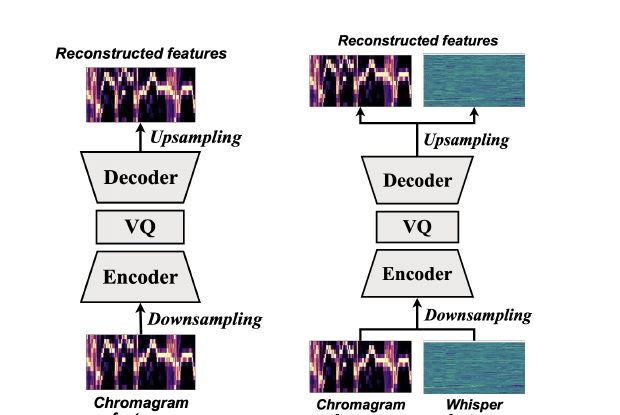
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentreprésentation du contenuq_prosodyreprésentation de la prosodiee_timbreembedding de timbreUn tokenizer de contenu préserve les paroles et l’articulation, un tokenizer de prosodie porte le rythme et le contour, et un embedding de timbre fournit des indices d’identité. Le générateur les recombine ; le découplage est un objectif, pas une garantie.
La voie de Vevo2 pilotée par un prompt ne suit pas une partition MIDI. Avant toute comparaison avec SoulX/YingMusic, il faut déterminer si l’objectif est un transfert de style par prompt ou des notes modifiables assorties d’une durée exacte.
L’article, le code et les poids sont accessibles via Code source d’Amphion Vevo2 / Poids de Vevo2 / Article Vevo2.
Chaque ligne conserve son architecture, sa métrique ou sa définition de tâche d’origine ; les résultats dépourvus de protocole commun restent séparés.
| Modèle | Architecture ou élément probant | Périmètre |
|---|---|---|
| Vevo2 | contenu plus prompt zero-shot de style/timbre | découplage, identité et variance d’échantillonnage |
| SoulX-Singer | chant piloté par une référence | timbre et paroles avec le même prompt |
| YingMusic-Singer-Plus | paroles plus mélodie/partition | notes, durée et capacité d’édition |
Il faut échantillonner plusieurs fois à partir du même prompt et examiner séparément la clarté des paroles, le contour de hauteur, le rythme et le timbre. Ne retenir qu’un seul résultat masque la variance ; l’accompagnement, les chœurs et la réverbération compliquent le découplage.
Lors de la comparaison de systèmes pilotés par une partition, la cible doit être fixée : Vevo2 convient au transfert de style/timbre à partir d’un prompt, tandis que les modèles MIDI/paroles conviennent aux notes modifiables et à la durée exacte. Ils n’ont pas de valeur de précision unique en commun.
Le découplage des représentations ne supprime pas l’identité. Les traits de la source et de la cible peuvent se contaminer, et l’anonymat de la sortie n’est pas garanti.
Les prompts de chant nécessitent une autorisation et l’audio généré doit être clairement signalé. La similarité n’autorise pas l’usurpation d’identité.
Les noms des modèles, les chiffres et les limites renvoient aux articles, dépôts ou cartes de modèle ci-dessous.