মডেল
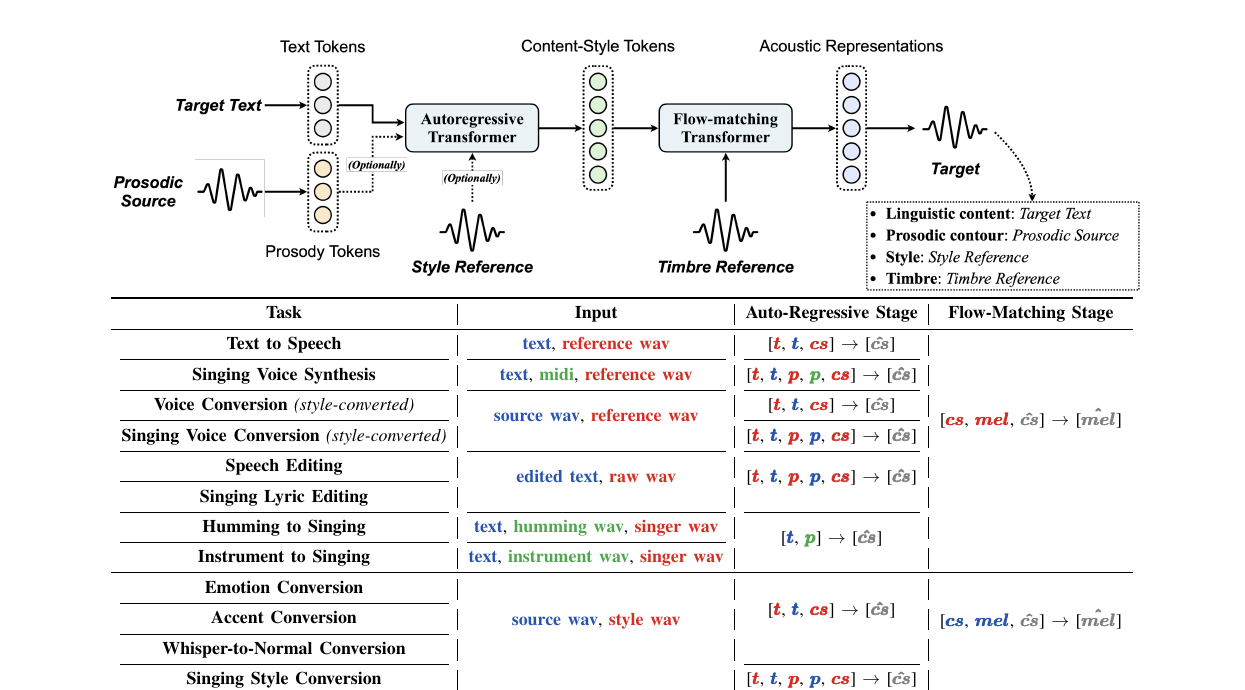
Vevo2: তিনটি শর্তের উপর ভিত্তি করে গান গাওয়া পুনর্গঠন: বিষয়বস্তু, কাঠবাদাম এবং তাল।
গান সংশ্লেষণ/প্রযুক্তিগত নোট
গান সংশ্লেষণ/প্রযুক্তিগত নোট
© 2026 টেলকনেট। সর্বস্বত্ব সংরক্ষিত।
গায়ন সংশ্লেষণ / কারিগরি নোট
SoulX-Singer স্পষ্ট স্বরলিপি হিসেবে গানের কথা ও MIDI গ্রহণ করে। Vevo2 রেফারেন্স-চালিত: একটি অ্যাকুস্টিক মডেল লক্ষ্য তরঙ্গরূপ তৈরির আগে উদাহরণ অডিও থেকে বিষয়বস্তু-স্টাইল ও স্বরছন্দের token বের করা হয়। এই দুই পথের ইনপুট চুক্তি এক হওয়া উচিত নয়।
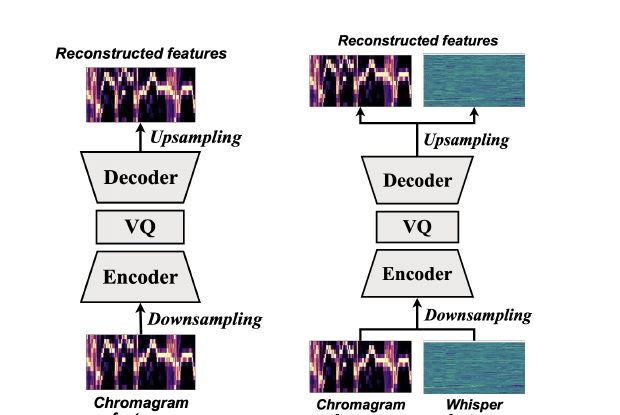
একটি token স্ট্রিমে ধ্বনি, সুরের উচ্চতা, ছন্দ ও কণ্ঠবর্ণ একসঙ্গে থাকলে একটি উপাদান বদলাতে গিয়ে অন্যগুলোও বিঘ্নিত হয়। আলাদা কোয়ান্টাইজার ব্যবহার করে Vevo পদ্ধতি এই সংযোগ কমায়। অ্যাকুস্টিক ল্যাটেন্ট z, বিষয়বস্তু-স্টাইল token c এবং স্বরছন্দ token r-এর জন্য flow matching শেখে:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
ইনফারেন্স শর্তাধীন বেগ ক্ষেত্রের সমাকলন করে এবং একটি vocoder অডিও পুনর্গঠন করে। পৃথকীকরণ নিয়ন্ত্রণ বাড়ায়, তবে রেফারেন্সের সঙ্গত, কক্ষের রিভার্ব টেল ও সময়গত ত্রুটি এখনও token-এ ঢুকে যেতে পারে।
Vevo2 একটি রেফারেন্স থেকে গায়নশৈলী ও স্বরছন্দ বহন করার জন্য উপযোগী। এটি প্রতিটি MIDI সূচনা, সমাপ্তি, velocity এবং গানের কথা-পদের মিলকে সমান কঠোর সম্পাদনা চুক্তি হিসেবে প্রকাশ করে না। SoulX-Singer সরাসরি MIDI পথ হিসেবেই থাকে; Vevo2 হলো সংশ্লিষ্ট রেফারেন্স-চালিত প্রোফাইল।
Vevo2-এর বিষয়বস্তু, স্বরছন্দ ও কণ্ঠবর্ণের উপস্থাপন এখনও একে অন্যের মধ্যে ফাঁস হতে পারে, আর রিভার্ব, সহগান ও সঙ্গত prompt-কে দূষিত করতে পারে। কণ্ঠসাদৃশ্য মডেলের আচরণ বর্ণনা করে; এটি কোনো গায়কের পরিচয় ব্যবহারের অনুমতি দেয় না। রেফারেন্স ও আউটপুটের জন্য অনুমোদন এবং সংশ্লেষিত হওয়ার স্পষ্ট ঘোষণা প্রয়োজন।
Vevo2 হলো Amphion-এর zero-shot গায়ন পদ্ধতি। এটি MIDI-কে নির্ভুল স্বরলিপি হিসেবে পড়ে না; বিষয়বস্তু, কণ্ঠবর্ণ, স্টাইল ও স্বরছন্দের উপস্থাপন আলাদা করে এবং prompt অডিওকে বিষয়বস্তু শর্তের সঙ্গে পুনরায় মিলিয়ে দেয়। এটি স্বরলিপি-শর্তাধীন SoulX/YingMusic টুলগুলোর কাছাকাছি, কিন্তু পরস্পর বদলযোগ্য নয়।
আগের রূপান্তর ও উৎপাদন ব্যবস্থা প্রায়ই বক্তা, আবেগ ও ছন্দকে এক ল্যাটেন্টে ভরে দিত। সংযোগ কমাতে Vevo স্তরবিন্যস্ত কোয়ান্টাইজেশন ও উৎপাদন ব্যবহার করে। Zero-shot সক্ষমতা আসে ডেটা ও prompt এনকোডিং থেকে; যেকোনো ছোট রেফারেন্স পরিচয়, গানের কথা ও সুর স্থিতিশীল রাখার নিশ্চয়তা দেয় না।
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentবিষয়বস্তু উপস্থাপনq_prosodyস্বরছন্দ উপস্থাপনe_timbreকণ্ঠবর্ণ embeddingবিষয়বস্তু tokenizer গানের কথা ও উচ্চারণ সংরক্ষণ করে, স্বরছন্দ tokenizer ছন্দ ও সুররেখা বহন করে এবং কণ্ঠবর্ণ embedding পরিচয়ের সংকেত দেয়। জেনারেটর এগুলোকে আবার মিলিয়ে দেয়; বিচ্ছিন্নকরণ একটি লক্ষ্য, নিশ্চয়তা নয়।
Vevo2-এর prompt-চালিত পথ MIDI স্বরলিপি অনুসরণ করে না। SoulX/YingMusic-এর সঙ্গে তুলনার আগে লক্ষ্যটি prompt-ভিত্তিক স্টাইল স্থানান্তর, নাকি সম্পাদনাযোগ্য নোট ও নির্ভুল স্থায়িত্ব তা ঠিক করতে হবে।
গবেষণাপত্র, কোড ও ওজন Amphion Vevo2 সোর্স / Vevo2 ওজন / Vevo2 গবেষণাপত্র থেকে অনুসরণ করা যায়।
প্রতিটি সারি নিজস্ব উৎস স্থাপত্য, মেট্রিক বা কাজের সংজ্ঞা অক্ষুণ্ণ রাখে; অভিন্ন প্রোটোকলহীন ফলগুলো আলাদা রাখা হয়।
| মডেল | স্থাপত্য বা প্রমাণ | পরিসর |
|---|---|---|
| Vevo2 | বিষয়বস্তু ও zero-shot স্টাইল/কণ্ঠবর্ণ prompt | বিচ্ছিন্নকরণ, পরিচয় ও স্যাম্পলিংয়ের তারতম্য |
| SoulX-Singer | রেফারেন্স-চালিত গায়ন | একই prompt-এর অধীনে কণ্ঠবর্ণ ও গানের কথা |
| YingMusic-Singer-Plus | গানের কথা ও সুর/স্বরলিপি | নোট, স্থায়িত্ব ও সম্পাদনাযোগ্যতা |
একই prompt থেকে বারবার নমুনা নিন এবং গানের কথার স্পষ্টতা, সুরের রেখা, ছন্দ ও কণ্ঠবর্ণ আলাদাভাবে পরীক্ষা করুন। একটি ফল বেছে নেওয়া তারতম্য আড়াল করে; সঙ্গত, সহগান ও রিভার্ব বিচ্ছিন্নকরণকে কঠিন করে তোলে।
স্বরলিপি-চালিত ব্যবস্থার তুলনায় লক্ষ্য স্থির রাখুন: Vevo2 prompt-ভিত্তিক স্টাইল/কণ্ঠবর্ণ স্থানান্তরের জন্য উপযোগী, আর MIDI/গানের কথা মডেল সম্পাদনাযোগ্য নোট ও নির্ভুল স্থায়িত্বের জন্য উপযোগী। এদের একটিমাত্র অভিন্ন নির্ভুলতার মান নেই।
উপস্থাপন বিচ্ছিন্ন করা পরিচয় মুছে ফেলা নয়। উৎস ও লক্ষ্যের বৈশিষ্ট্য একে অন্যের মধ্যে ফাঁস হতে পারে, এবং আউটপুট বেনামি হওয়ার নিশ্চয়তা নেই।
গায়ন prompt ব্যবহারে অনুমতি দরকার এবং উৎপাদিত অডিও স্পষ্টভাবে চিহ্নিত করতে হবে। সাদৃশ্য ছদ্মবেশ ধারণের অনুমোদন দেয় না।
মডেলের নাম, সংখ্যা ও সীমাবদ্ধতার উৎস নিচের গবেষণাপত্র, রিপোজিটরি বা model card।