Modello
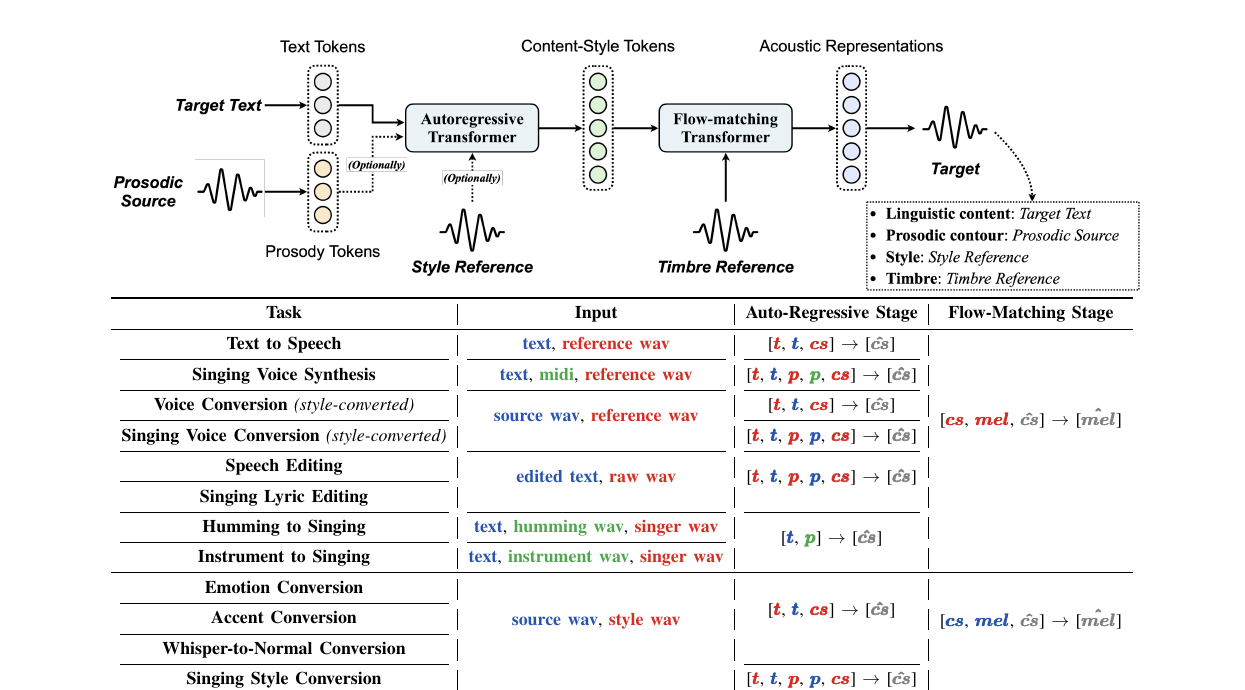
Vevo2: Riorganizzazione del canto basata su tre condizioni: contenuto, timbro e ritmo.
Sintesi canto/note tecniche
Sintesi canto/note tecniche
© 2026 TelkNet. Tutti i diritti riservati.
SINTESI DEL CANTO / NOTA TECNICA
SoulX-Singer accetta testo e MIDI come partitura esplicita. Vevo2 è guidato da un riferimento: i token di contenuto-stile e prosodia vengono estratti da un audio di esempio prima che un modello acustico costruisca la forma d’onda obiettivo. Le due strade non dovrebbero condividere un unico contratto di input.
Se un unico flusso di token trasporta fonemi, altezza, ritmo e timbro, la sostituzione di un fattore perturba gli altri. Il percorso Vevo riduce questo accoppiamento con quantizzatori separati. Per la variabile latente acustica z, i token di contenuto-stile c e i token di prosodia r, il flow matching apprende:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
L’inferenza integra il campo di velocità condizionato e un vocoder ricostruisce l’audio. La separazione migliora il controllo, ma l’accompagnamento, le code del riverbero e gli errori temporali nel riferimento possono ancora entrare nei token.
Vevo2 è adatto a trasferire lo stile vocale e la prosodia da un riferimento. Non espone ogni attacco, rilascio, velocity MIDI e allineamento tra sillabe e testo come un contratto di editing altrettanto rigoroso. SoulX-Singer rimane il percorso MIDI diretto; Vevo2 è il profilo corrispondente guidato da un riferimento.
Le rappresentazioni di contenuto, prosodia e timbro di Vevo2 possono ancora contaminarsi a vicenda, mentre riverbero, cori e accompagnamento alterano il prompt. La somiglianza vocale descrive il comportamento del modello; non concede l’autorizzazione a usare l’identità di una cantante o di un cantante. Riferimenti e risultati richiedono autorizzazione e una chiara indicazione della loro natura sintetica.
Vevo2 è il percorso di Amphion per il canto zero-shot. Non legge il MIDI come una partitura esatta; separa le rappresentazioni di contenuto, timbro, stile e prosodia e ricombina l’audio del prompt con le condizioni di contenuto. È vicino agli strumenti SoulX/YingMusic condizionati dalla partitura, ma non è intercambiabile con essi.
I precedenti sistemi di conversione e generazione spesso racchiudevano parlante, emozione e ritmo in una sola variabile latente. Vevo usa quantizzazione e generazione gerarchiche per ridurre l’accoppiamento. La capacità zero-shot deriva dai dati e dalla codifica del prompt; un riferimento breve scelto arbitrariamente non garantisce identità, testo e melodia stabili.
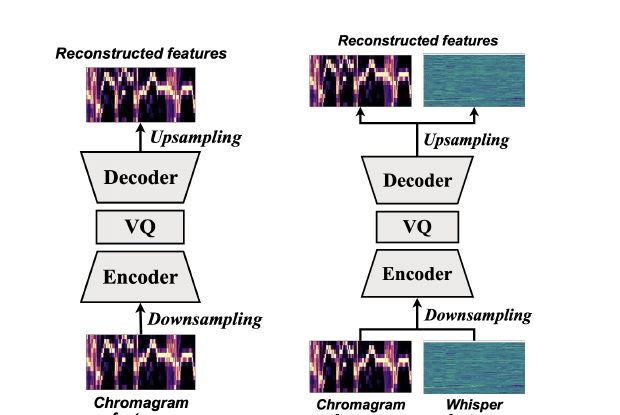
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentrappresentazione del contenutoq_prosodyrappresentazione della prosodiae_timbreembedding del timbroUn tokenizer del contenuto conserva testo e articolazione, un tokenizer della prosodia trasporta ritmo e profilo melodico e un embedding del timbro fornisce indizi d’identità. Il generatore li ricombina; il disaccoppiamento è un obiettivo, non una garanzia.
Il percorso di Vevo2 guidato da prompt non segue una partitura MIDI. Prima del confronto con SoulX/YingMusic occorre stabilire se l’obiettivo sia il trasferimento di stile basato su prompt oppure note modificabili e durata esatta.
Articolo, codice e pesi sono consultabili tramite Codice sorgente Amphion Vevo2 / Pesi Vevo2 / Articolo Vevo2.
Ogni riga mantiene l’architettura, la metrica o la definizione del compito della propria fonte; i risultati privi di un protocollo comune restano separati.
| Modello | Architettura o evidenza | Ambito |
|---|---|---|
| Vevo2 | contenuto più prompt zero-shot di stile/timbro | disaccoppiamento, identità e varianza di campionamento |
| SoulX-Singer | canto guidato da un riferimento | timbro e testo con lo stesso prompt |
| YingMusic-Singer-Plus | testo più melodia/partitura | note, durata e modificabilità |
Occorre campionare più volte dallo stesso prompt e controllare separatamente chiarezza del testo, profilo melodico, ritmo e timbro. Scegliere un solo risultato nasconde la varianza; accompagnamento, cori e riverbero rendono più difficile il disaccoppiamento.
Nel confronto tra sistemi guidati da una partitura bisogna fissare l’obiettivo: Vevo2 è adatto al trasferimento di stile/timbro basato su prompt, mentre i modelli MIDI/testo sono adatti a note modificabili e durata esatta. Non condividono un unico valore di accuratezza.
Il disaccoppiamento delle rappresentazioni non elimina l’identità. I tratti della sorgente e dell’obiettivo possono contaminarsi e l’anonimato dell’output non è garantito.
I prompt vocali richiedono un’autorizzazione e l’audio generato deve essere chiaramente segnalato. La somiglianza non autorizza l’impersonificazione.
I nomi dei modelli, i numeri e i limiti rimandano agli articoli, ai repository o alle schede dei modelli riportati di seguito.