Modelo
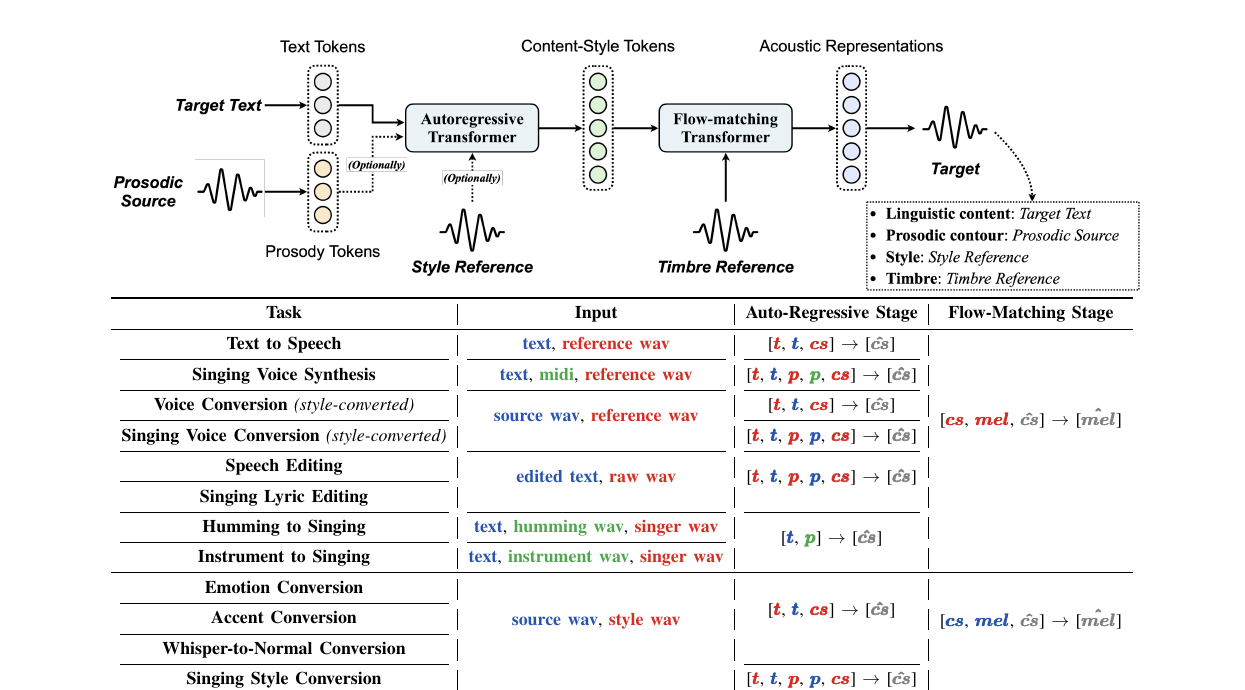
Vevo2: Reorganização do canto baseada em três condições: conteúdo, timbre e ritmo.
Síntese de canto/notas técnicas
Síntese de canto/notas técnicas
© 2026 TelkNet. Todos os direitos reservados.
SÍNTESE DE CANTO / NOTA TÉCNICA
O SoulX-Singer recebe letra e MIDI como uma partitura explícita. O Vevo2 é orientado por referência: tokens de conteúdo e estilo e tokens de prosódia são extraídos de um áudio de exemplo antes que um modelo acústico construa a forma de onda de destino. As duas rotas não devem compartilhar o mesmo contrato de entrada.
Quando um único fluxo de tokens carrega fonemas, altura, ritmo e timbre, a substituição de um fator afeta os demais. A rota do Vevo reduz esse acoplamento com quantizadores separados. Para o espaço latente acústico z, os tokens de conteúdo e estilo c e os tokens de prosódia r, o flow matching aprende:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
A inferência integra o campo de velocidade condicional, e um vocoder reconstrói o áudio. A separação melhora o controle, mas o acompanhamento, as caudas de reverberação do ambiente e os erros de timing da referência ainda podem entrar nos tokens.
O Vevo2 é adequado para transportar o estilo de canto e a prosódia de uma referência. Ele não expõe cada início, fim e velocity de nota MIDI nem o alinhamento entre letra e sílaba como contratos de edição igualmente rigorosos. O SoulX-Singer continua sendo a rota MIDI direta; o Vevo2 é o perfil correspondente orientado por referência.
As representações de conteúdo, prosódia e timbre do Vevo2 ainda podem vazar umas para as outras, enquanto reverberação, backing vocals e acompanhamento contaminam o prompt. A semelhança de voz descreve o comportamento do modelo; não concede permissão para usar a identidade de um cantor. Referências e resultados precisam de autorização e de uma divulgação clara de que são sintéticos.
O Vevo2 é a rota de canto zero-shot do Amphion. Ele não lê MIDI como uma partitura exata; separa representações de conteúdo, timbre, estilo e prosódia e recombina o áudio de prompt com condições de conteúdo. É uma rota próxima das ferramentas SoulX/YingMusic condicionadas por partitura, mas não é intercambiável com elas.
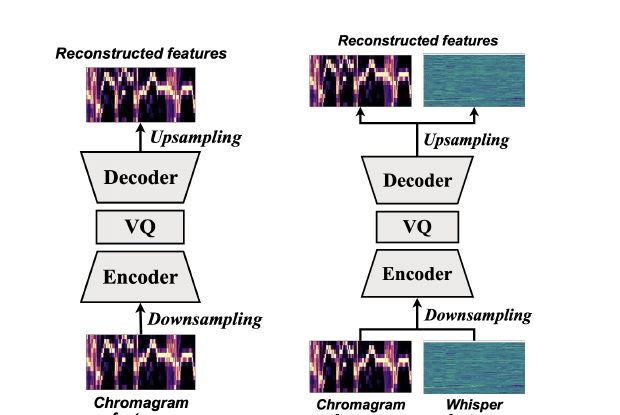
Sistemas anteriores de conversão e geração costumavam reunir locutor, emoção e ritmo em um único espaço latente. O Vevo usa quantização e geração hierárquicas para reduzir o acoplamento. A capacidade zero-shot vem dos dados e da codificação do prompt; uma referência curta qualquer não garante identidade, letra e melodia estáveis.
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentrepresentação de conteúdoq_prosodyrepresentação de prosódiae_timbreembedding de timbreUm tokenizador de conteúdo preserva a letra e a articulação, um tokenizador de prosódia carrega o ritmo e o contorno, e um embedding de timbre fornece sinais de identidade. O gerador os recombina; a separação é um objetivo, não uma garantia.
A rota do Vevo2 orientada por prompt não segue uma partitura MIDI. Uma comparação com SoulX/YingMusic precisa primeiro definir se o objetivo é transferência de estilo baseada em prompt ou notas editáveis e duração exata.
Artigo, código e pesos podem ser consultados por meio do código-fonte do Amphion Vevo2 / pesos do Vevo2 / artigo do Vevo2.
Cada linha mantém a arquitetura, a métrica ou a definição de tarefa de sua fonte; resultados sem um protocolo compartilhado permanecem separados.
| Modelo | Arquitetura ou evidência | Escopo |
|---|---|---|
| Vevo2 | conteúdo mais prompt zero-shot de estilo e timbre | separação, identidade e variância de amostragem |
| SoulX-Singer | canto orientado por referência | timbre e letra sob o mesmo prompt |
| YingMusic-Singer-Plus | letra mais melodia ou partitura | notas, duração e capacidade de edição |
Gere várias amostras com o mesmo prompt e examine separadamente a clareza da letra, o contorno da altura, o ritmo e o timbre. Escolher apenas um resultado esconde a variância; acompanhamento, backing vocals e reverberação tornam a separação mais difícil.
Fixe o objetivo ao comparar sistemas orientados por partitura: o Vevo2 é adequado à transferência de estilo e timbre baseada em prompt, enquanto os modelos de MIDI e letra são adequados a notas editáveis e duração exata. Eles não compartilham um único valor de precisão.
Separar representações não significa remover a identidade. Características da fonte e do destino podem vazar, e não há garantia de que a saída seja anônima.
Prompts de canto exigem permissão, e o áudio gerado precisa de divulgação clara. Semelhança não autoriza falsificação de identidade.
Os nomes dos modelos, números e limitações remetem aos artigos, repositórios ou cartões de modelo abaixo.