Modelo
Vevo2: Reorganización del canto en base a tres condiciones: contenido, timbre y ritmo.
Síntesis de canto/notas técnicas
Síntesis de canto/notas técnicas
© 2026 TelkNet. Todos los derechos reservados.
SÍNTESIS DE CANTO / NOTA TÉCNICA
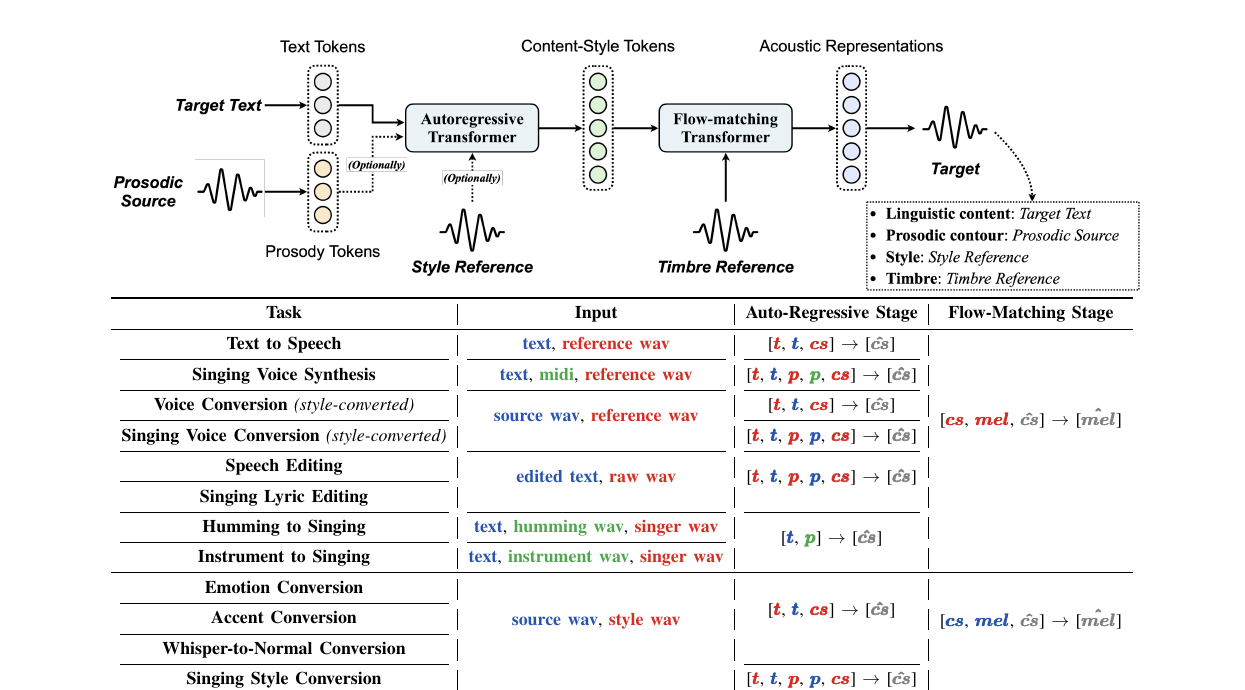
SoulX-Singer acepta letra y MIDI como una partitura explícita. Vevo2 se guía por una referencia: extrae tokens de contenido-estilo y prosodia de un audio de ejemplo antes de que un modelo acústico construya la forma de onda objetivo. Las dos vías no deben compartir un único contrato de entrada.
Si un mismo flujo de tokens contiene fonemas, altura, ritmo y timbre, sustituir un factor altera los demás. La vía Vevo reduce ese acoplamiento mediante cuantizadores separados. Para el latente acústico z, los tokens de contenido-estilo c y los tokens de prosodia r, flow matching aprende:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
La inferencia integra el campo de velocidad condicionado y un vocoder reconstruye el audio. La separación mejora el control, pero el acompañamiento, las colas de reverberación y los errores de tiempo de la referencia todavía pueden pasar a los tokens.
Vevo2 sirve para trasladar el estilo de canto y la prosodia de una referencia. No expone cada ataque, final, velocidad MIDI ni alineación entre sílabas y letra como un contrato de edición igual de estricto. SoulX-Singer sigue siendo la vía MIDI directa; Vevo2 es el perfil correspondiente guiado por una referencia.
Las representaciones de contenido, prosodia y timbre de Vevo2 todavía pueden filtrarse unas en otras, mientras que la reverberación, los coros y el acompañamiento contaminan el prompt. La similitud vocal describe el comportamiento del modelo; no concede permiso para usar la identidad de un cantante. Las referencias y los resultados requieren autorización y una indicación clara de que son sintéticos.
Vevo2 es la vía de canto zero-shot de Amphion. No lee el MIDI como una partitura exacta; separa las representaciones de contenido, timbre, estilo y prosodia y recombina el audio del prompt con condiciones de contenido. Está próxima a las herramientas SoulX/YingMusic condicionadas por partitura, pero no es intercambiable con ellas.
Los sistemas anteriores de conversión y generación solían agrupar hablante, emoción y ritmo en un solo latente. Vevo emplea cuantización y generación jerárquicas para reducir el acoplamiento. La capacidad zero-shot procede de los datos y la codificación del prompt; una referencia breve cualquiera no garantiza que la identidad, la letra y la melodía se mantengan estables.
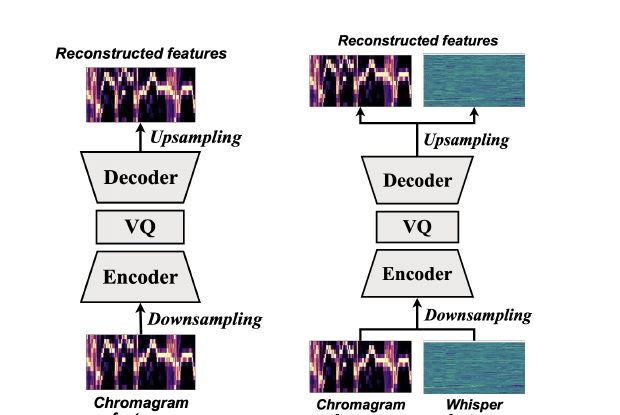
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentrepresentación de contenidoq_prosodyrepresentación de prosodiae_timbreembedding de timbreUn tokenizador de contenido conserva la letra y la articulación, otro de prosodia transporta el ritmo y el contorno, y un embedding de timbre aporta indicios de identidad. El generador los recombina; el desacoplamiento es un objetivo, no una garantía.
La vía de Vevo2 guiada por prompts no sigue una partitura MIDI. Antes de compararla con SoulX/YingMusic hay que fijar si el objetivo es transferir estilo mediante un prompt o disponer de notas editables y una duración exacta.
El artículo, el código y los pesos pueden consultarse en Código fuente de Amphion Vevo2 / Pesos de Vevo2 / Artículo de Vevo2.
Cada fila conserva su arquitectura, métrica o definición de tarea de origen; los resultados sin un protocolo común se mantienen separados.
| Modelo | Arquitectura o evidencia | Ámbito |
|---|---|---|
| Vevo2 | contenido más prompt zero-shot de estilo/timbre | desacoplamiento, identidad y variación del muestreo |
| SoulX-Singer | canto guiado por una referencia | timbre y letra con el mismo prompt |
| YingMusic-Singer-Plus | letra más melodía/partitura | notas, duración y capacidad de edición |
Conviene obtener varias muestras del mismo prompt y revisar por separado la claridad de la letra, el contorno de altura, el ritmo y el timbre. Elegir un único resultado oculta la variación; el acompañamiento, los coros y la reverberación dificultan el desacoplamiento.
Al comparar sistemas guiados por partitura, hay que fijar el objetivo: Vevo2 sirve para transferir estilo/timbre mediante prompts, mientras que los modelos MIDI/letra sirven para obtener notas editables y una duración exacta. No comparten un único valor de precisión.
Desacoplar representaciones no elimina la identidad. Los rasgos de la fuente y el objetivo pueden filtrarse, y no se garantiza que el resultado sea anónimo.
Los prompts de canto requieren permiso y el audio generado necesita una indicación clara. La similitud no autoriza la suplantación.
Los nombres de modelos, las cifras y las limitaciones remiten a los artículos, repositorios o tarjetas de modelo indicados a continuación.