Vevo2: การปรับโครงสร้างการร้องเพลงตามเงื่อนไขสามประการ: เนื้อหา จังหวะ และจังหวะ
การสังเคราะห์เสียงร้อง/บันทึกทางเทคนิค
การสังเคราะห์เสียงร้อง / บันทึกทางเทคนิค
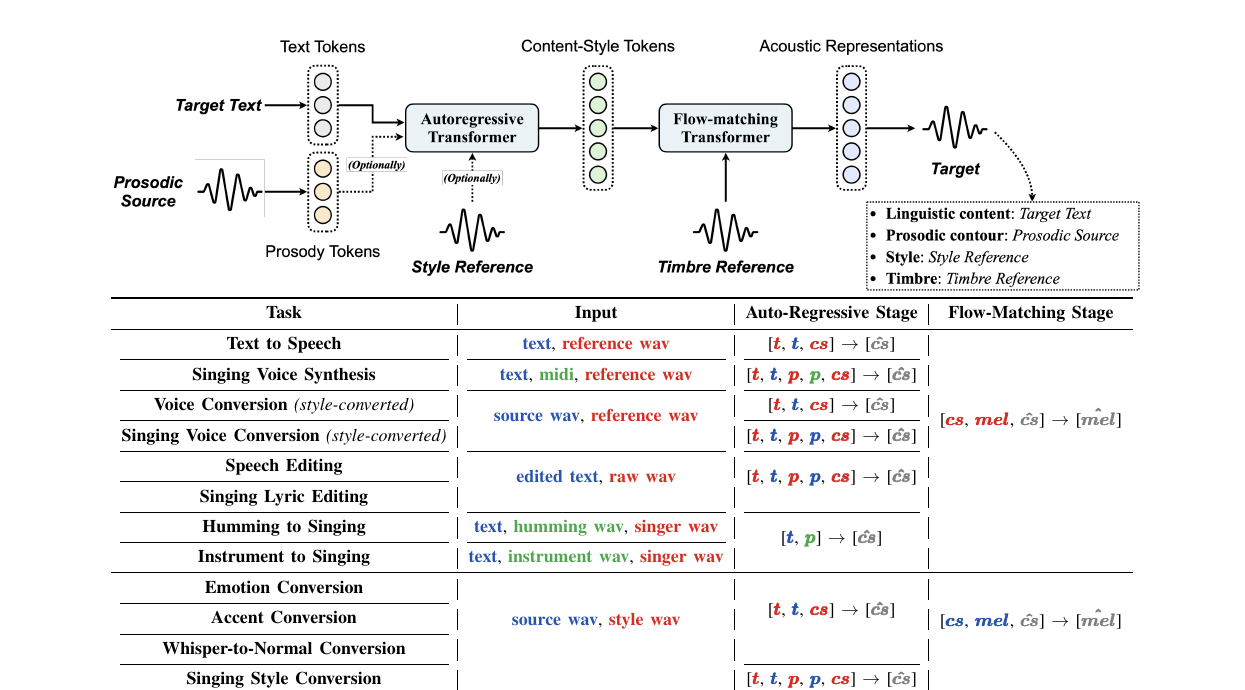
SoulX-Singer รับเนื้อร้องและ MIDI เป็นโน้ตเพลงที่ระบุไว้อย่างชัดเจน ส่วน Vevo2 ขับเคลื่อนด้วยเสียงอ้างอิง โดยแยก token ของเนื้อหา-สไตล์และสัทสัมพันธ์จากเสียงตัวอย่าง ก่อนให้โมเดลอะคูสติกสร้างรูปคลื่นเป้าหมาย ทั้งสองเส้นทางไม่ควรใช้ข้อตกลงอินพุตชุดเดียวกัน
เหตุใดจึงต้องมี tokenizer สองตัว
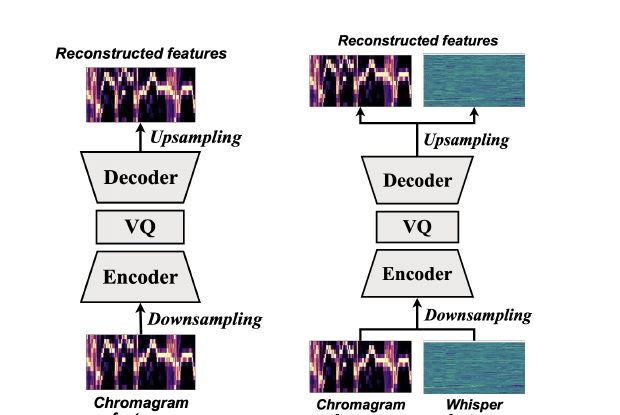
หากสตรีม token เดียวบรรจุทั้งหน่วยเสียง ระดับเสียง จังหวะ และลักษณะเสียง การแทนที่ปัจจัยหนึ่งจะรบกวนปัจจัยอื่น เส้นทาง Vevo ลดการเชื่อมโยงนี้ด้วยตัวควอนไทซ์แยกกัน สำหรับตัวแปรแฝงทางอะคูสติก z, token เนื้อหา-สไตล์ c และ token สัทสัมพันธ์ r, flow matching จะเรียนรู้:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
ขั้นอนุมานอินทิเกรตสนามความเร็วแบบมีเงื่อนไข แล้ว vocoder จึงสร้างเสียงกลับคืน การแยกองค์ประกอบช่วยให้ควบคุมได้ดีขึ้น แต่เสียงประกอบ หางเสียงก้องของห้อง และข้อผิดพลาดด้านเวลาในเสียงอ้างอิงยังอาจเข้าไปอยู่ใน token
ไม่ใช่โปรแกรมแก้ไขโน้ตเพลง
Vevo2 เหมาะกับการนำสไตล์การร้องและสัทสัมพันธ์มาจากเสียงอ้างอิง แต่ไม่ได้เปิดให้แก้ไขจุดเริ่ม จุดสิ้นสุด velocity ของ MIDI และการจัดแนวเนื้อร้องกับพยางค์ทุกตำแหน่งภายใต้ข้อตกลงที่เข้มงวดเท่ากัน SoulX-Singer ยังคงเป็นเส้นทาง MIDI โดยตรง ส่วน Vevo2 เป็นโปรไฟล์ที่ขับเคลื่อนด้วยเสียงอ้างอิงซึ่งสอดคล้องกัน
ความคล้ายแบบ zero-shot และการอนุญาต
ตัวแทนเนื้อหา สัทสัมพันธ์ และลักษณะเสียงของ Vevo2 ยังอาจรั่วเข้าหากัน ขณะที่เสียงก้อง เสียงร้องประสาน และเสียงประกอบอาจปนเปื้อน prompt ความคล้ายของเสียงร้องอธิบายพฤติกรรมของโมเดลเท่านั้น ไม่ได้ให้สิทธิ์ใช้ตัวตนของนักร้อง เสียงอ้างอิงและผลลัพธ์ต้องได้รับอนุญาตและระบุให้ชัดเจนว่าเป็นเสียงสังเคราะห์
จากแหล่งเสียงแบบตายตัวสู่การแยกเสียงแบบมีเงื่อนไข
Vevo2 เป็นเส้นทางการร้องแบบ zero-shot ของ Amphion ระบบไม่ได้อ่าน MIDI เป็นโน้ตเพลงที่เที่ยงตรง แต่แยกตัวแทนของเนื้อหา ลักษณะเสียง สไตล์ และสัทสัมพันธ์ แล้วนำเสียง prompt มารวมกับเงื่อนไขเนื้อหาอีกครั้ง ระบบนี้อยู่ใกล้กับเครื่องมือ SoulX/YingMusic ที่มีเงื่อนไขจากโน้ตเพลง แต่ใช้แทนกันไม่ได้
ระบบแปลงและสร้างเสียงรุ่นก่อนมักรวมผู้พูด อารมณ์ และจังหวะไว้ในตัวแปรแฝงเดียว Vevo ใช้การควอนไทซ์และการสร้างแบบลำดับชั้นเพื่อลดการเชื่อมโยง ความสามารถแบบ zero-shot มาจากข้อมูลและการเข้ารหัส prompt เสียงอ้างอิงสั้น ๆ ที่เลือกมาโดยพลการไม่ได้รับประกันว่าตัวตน เนื้อร้อง และทำนองจะคงที่
เงื่อนไขแบบแบ่งชั้นสำหรับเนื้อหา สัทสัมพันธ์ และลักษณะเสียง
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentตัวแทนเนื้อหาq_prosodyตัวแทนสัทสัมพันธ์e_timbreembedding ลักษณะเสียง
tokenizer เนื้อหารักษาเนื้อร้องและการออกเสียง tokenizer สัทสัมพันธ์ถ่ายทอดจังหวะและแนวระดับเสียง ส่วน embedding ลักษณะเสียงให้เบาะแสด้านตัวตน ตัวสร้างนำทั้งหมดมารวมกันใหม่ การแยกตัวแทนเป็นเป้าหมาย ไม่ใช่สิ่งที่รับประกัน
เส้นทางที่ขับเคลื่อนด้วย prompt ของ Vevo2 ไม่ใช่การตามโน้ต MIDI การเปรียบเทียบกับ SoulX/YingMusic ต้องกำหนดก่อนว่าเป้าหมายคือการถ่ายโอนสไตล์ตาม prompt หรือโน้ตที่แก้ไขได้พร้อมระยะเวลาที่แม่นยำ
ติดตามบทความ โค้ด และน้ำหนักได้จาก ซอร์ส Amphion Vevo2 / น้ำหนัก Vevo2 / บทความ Vevo2
ผลที่เปรียบเทียบได้ภายใต้นิยาม stem เดียวกัน
แต่ละแถวยังคงสถาปัตยกรรม เมตริก หรือนิยามงานของแหล่งที่มาไว้ ผลที่ไม่มีโพรโทคอลร่วมกันจะแยกออกจากกัน
| โมเดล | สถาปัตยกรรมหรือหลักฐาน | ขอบเขต |
|---|---|---|
| Vevo2 | เนื้อหาและ prompt สไตล์/ลักษณะเสียงแบบ zero-shot | การแยกตัวแทน ตัวตน และความแปรปรวนจากการสุ่มตัวอย่าง |
| SoulX-Singer | เสียงร้องที่ขับเคลื่อนด้วยเสียงอ้างอิง | ลักษณะเสียงและเนื้อร้องภายใต้ prompt เดียวกัน |
| YingMusic-Singer-Plus | เนื้อร้องและทำนอง/โน้ตเพลง | โน้ต ระยะเวลา และความสามารถในการแก้ไข |
การฟัง stem และความสอดคล้องของเสียงผสม
สุ่มตัวอย่างจาก prompt เดิมหลายครั้ง แล้วตรวจสอบความชัดเจนของเนื้อร้อง แนวระดับเสียง จังหวะ และลักษณะเสียงแยกกัน การเลือกเฉพาะผลลัพธ์เดียวจะซ่อนความแปรปรวน เสียงประกอบ เสียงร้องประสาน และเสียงก้องทำให้แยกตัวแทนได้ยากขึ้น
เมื่อนำระบบที่ขับเคลื่อนด้วยโน้ตเพลงมาเปรียบเทียบ ต้องกำหนดเป้าหมายให้คงที่ Vevo2 เหมาะกับการถ่ายโอนสไตล์/ลักษณะเสียงตาม prompt ส่วนโมเดล MIDI/เนื้อร้องเหมาะกับโน้ตที่แก้ไขได้และระยะเวลาที่แม่นยำ ทั้งสองเส้นทางไม่มีค่าความแม่นยำเดียวร่วมกัน
ขอบเขตของนิยาม stem ในชุดข้อมูล
การแยกตัวแทนไม่ใช่การลบตัวตน ลักษณะของต้นทางและเป้าหมายอาจรั่วหากัน และไม่รับประกันว่าผลลัพธ์จะไม่ระบุตัวบุคคล
prompt เสียงร้องต้องได้รับอนุญาต และเสียงที่สร้างขึ้นต้องระบุให้ชัดเจน ความคล้ายไม่ใช่สิทธิ์ในการแอบอ้างเป็นผู้อื่น
บทความและไฟล์สาธารณะสำหรับซอร์ส Amphion Vevo2
ชื่อโมเดล ตัวเลข และข้อจำกัดสืบย้อนกลับไปยังบทความ คลังโค้ด หรือ model card ด้านล่าง