Модель
Vevo2: Реорганизация пения на основе трех условий: содержания, тембра и ритма.
Певческий синтез/технические примечания
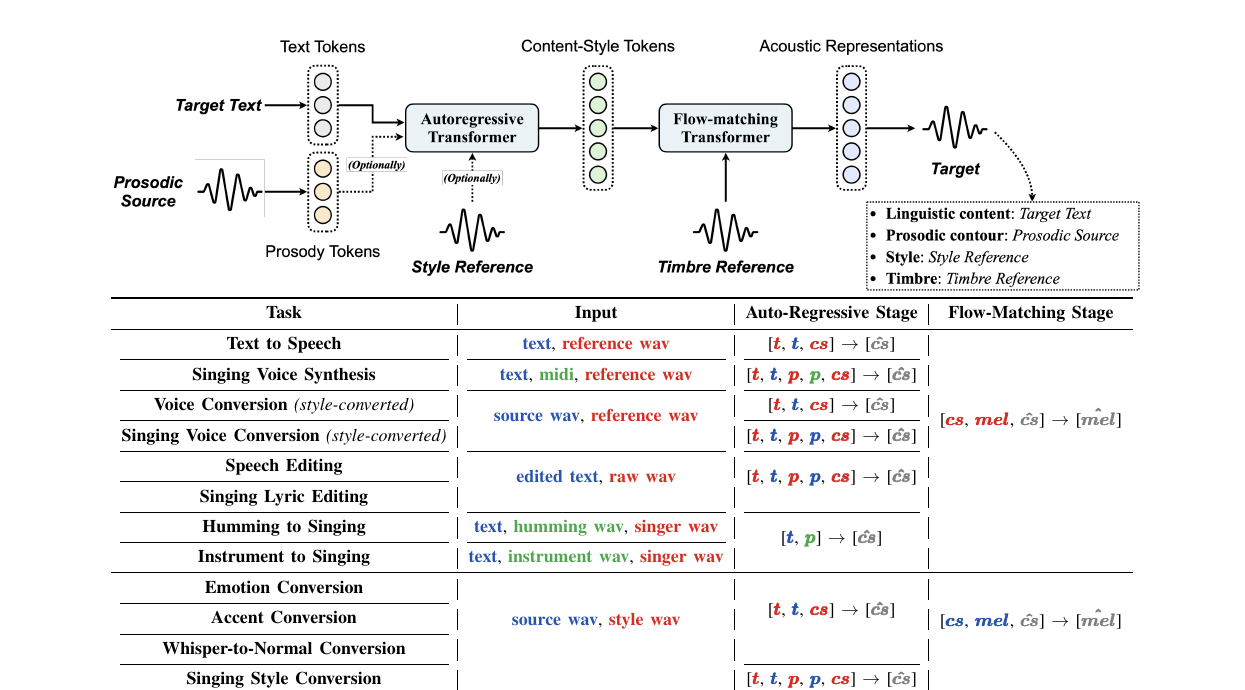
Певческий синтез/технические примечания
СИНТЕЗ ПЕНИЯ / ТЕХНИЧЕСКАЯ ЗАМЕТКА
SoulX-Singer принимает текст и MIDI как явную партитуру. Vevo2 работает от эталона: token содержания и стиля, а также token просодии извлекаются из примера аудио до того, как акустическая модель строит целевую форму волны. Для этих двух путей нельзя использовать один входной контракт.
Если один поток token несёт фонемы, высоту, ритм и тембр, замена одного фактора нарушает остальные. Путь Vevo ослабляет эту связь с помощью раздельных квантователей. Для акустического скрытого представления z, token содержания и стиля c и token просодии r flow matching обучается следующему:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
При инференсе интегрируется условное поле скоростей, а vocoder восстанавливает аудио. Разделение улучшает управляемость, однако аккомпанемент, хвосты комнатной реверберации и временные ошибки эталона по-прежнему могут попасть в token.
Vevo2 подходит для переноса стиля пения и просодии из эталона. Он не предоставляет каждое начало, окончание и velocity ноты MIDI, а также выравнивание текста по слогам в виде одинаково строгого контракта редактирования. SoulX-Singer остаётся прямым путём MIDI; Vevo2 — соответствующий ему профиль, управляемый эталоном.
Представления содержания, просодии и тембра в Vevo2 всё ещё могут проникать друг в друга, а реверберация, бэк-вокал и аккомпанемент загрязняют prompt. Сходство голоса описывает поведение модели, но не даёт разрешения использовать личность певца. Для эталонов и результатов нужны разрешение и ясное указание на синтетическое происхождение.
Vevo2 — zero-shot путь синтеза пения в Amphion. Он не читает MIDI как точную партитуру, а разделяет представления содержания, тембра, стиля и просодии и заново объединяет prompt-аудио с условиями содержания. Этот путь близок к управляемым партитурой инструментам SoulX/YingMusic, но не взаимозаменяем с ними.
Ранние системы преобразования и генерации часто упаковывали диктора, эмоцию и ритм в одно скрытое представление. Vevo использует иерархическое квантование и генерацию, чтобы ослабить связь. Zero-shot способность возникает благодаря данным и кодированию prompt; произвольный короткий эталон не гарантирует стабильности личности, текста и мелодии.
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentпредставление содержанияq_prosodyпредставление просодииe_timbreembedding тембраTokenizer содержания сохраняет текст и артикуляцию, tokenizer просодии переносит ритм и контур, а embedding тембра предоставляет признаки личности. Генератор заново объединяет их; разделение является целью, а не гарантией.
Управляемый prompt путь Vevo2 не следует партитуре MIDI. Перед сравнением с SoulX/YingMusic нужно определить, требуется ли перенос стиля по prompt или редактируемые ноты и точная длительность.
Статью, код и веса можно найти через исходный код Amphion Vevo2 / веса Vevo2 / статью Vevo2.
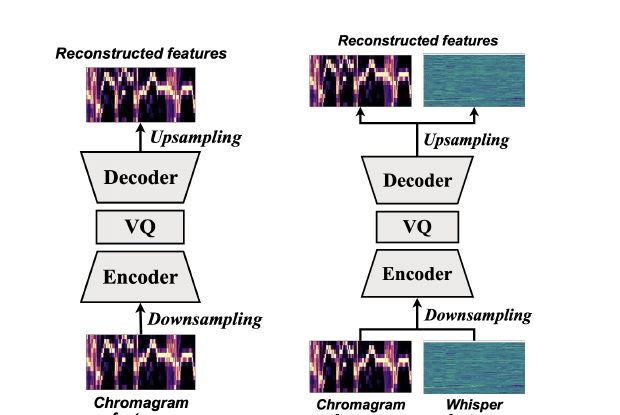
Каждая строка сохраняет архитектуру, метрику или определение задачи из своего источника; результаты без общего протокола остаются раздельными.
| Модель | Архитектура или свидетельство | Область |
|---|---|---|
| Vevo2 | содержание и zero-shot prompt стиля и тембра | разделение, личность и вариативность сэмплирования |
| SoulX-Singer | пение, управляемое эталоном | тембр и текст при одном prompt |
| YingMusic-Singer-Plus | текст и мелодия или партитура | ноты, длительность и редактируемость |
Создайте несколько сэмплов по одному prompt и отдельно проверьте ясность текста, контур высоты, ритм и тембр. Выбор одного лучшего результата скрывает вариативность; аккомпанемент, бэк-вокал и реверберация усложняют разделение.
При сравнении систем, управляемых партитурой, зафиксируйте цель: Vevo2 подходит для переноса стиля и тембра по prompt, а модели MIDI и текста — для редактируемых нот и точной длительности. У них нет одного общего значения точности.
Разделение представлений не является удалением личности. Признаки источника и цели могут проникать друг в друга, а анонимность результата не гарантируется.
Для вокальных prompt требуется разрешение, а сгенерированное аудио нуждается в ясном раскрытии. Сходство не даёт права выдавать себя за другого.
Названия моделей, числа и ограничения восходят к приведённым ниже статьям, репозиториям или карточкам моделей.