Vevo2: 내용, 음색, 리듬의 세 가지 조건에 따라 노래를 재구성합니다.
노래 합성/기술 노트
가창 합성 / 기술 노트
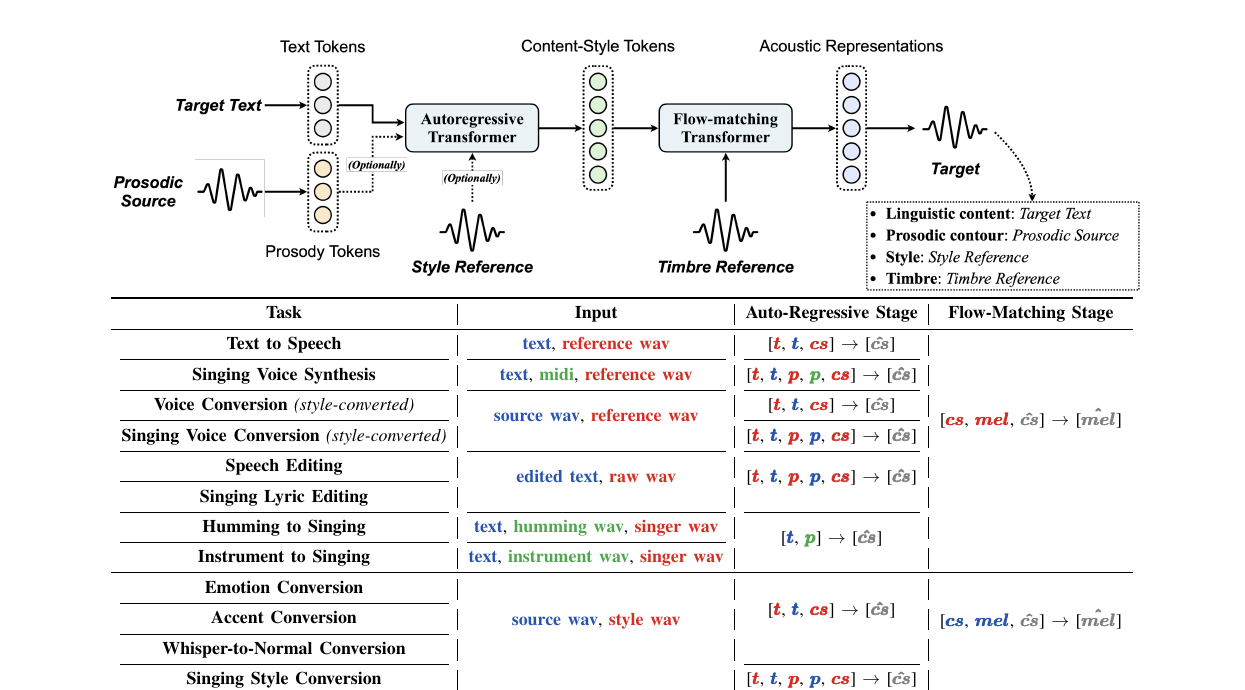
SoulX-Singer는 가사와 MIDI를 명시적인 악보로 입력받는다. Vevo2는 참조 음원으로 구동된다. 예시 음원에서 콘텐츠-스타일 토큰과 운율 토큰을 추출한 뒤 음향 모델이 목표 파형을 만든다. 두 경로가 하나의 입력 계약을 공유해서는 안 된다.
토크나이저가 두 개인 이유
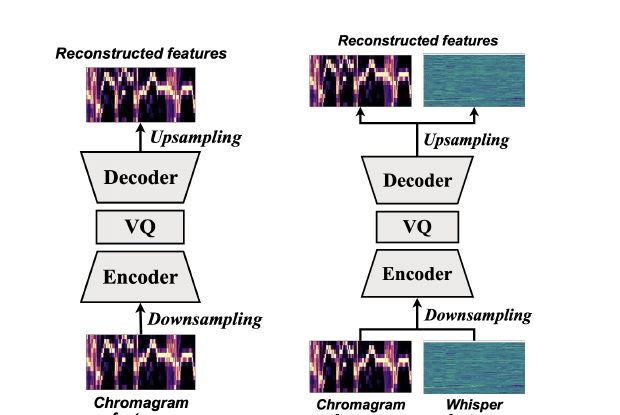
하나의 토큰 스트림이 음소, 음높이, 리듬, 음색을 모두 담으면 한 요소를 바꿀 때 다른 요소도 흔들린다. Vevo 경로는 별도의 양자화기를 사용해 이러한 결합을 줄인다. 음향 잠재변수 z, 콘텐츠-스타일 토큰 c, 운율 토큰 r에 대해 flow matching은 다음을 학습한다.
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
추론에서는 조건부 속도장을 적분하고 보코더가 음원을 재구성한다. 요소를 분리하면 제어력이 높아지지만 참조 음원의 반주, 공간 잔향, 타이밍 오류가 여전히 토큰에 들어갈 수 있다.
악보 편집기는 아니다
Vevo2는 참조 음원에서 가창 스타일과 운율을 가져오는 데 적합하다. MIDI의 모든 시작 시점, 종료 시점, 세기, 가사 음절 정렬을 똑같이 엄격한 편집 계약으로 제공하지는 않는다. SoulX-Singer는 직접 MIDI를 사용하는 경로로 남고, Vevo2는 이에 대응하는 참조 구동 프로필이다.
제로샷 유사성과 허가
Vevo2의 콘텐츠, 운율, 음색 표현은 여전히 서로 새어 들어갈 수 있으며, 리버브, 백 보컬, 반주가 프롬프트를 오염시킬 수 있다. 목소리 유사성은 모델의 동작을 설명할 뿐 가수의 정체성을 사용할 허가를 부여하지 않는다. 참조 음원과 출력물에는 허가와 명확한 합성물 표시가 필요하다.
고정 소스에서 조건부 분리로
Vevo2는 Amphion의 제로샷 가창 경로다. MIDI를 정확한 악보로 읽는 대신 콘텐츠, 음색, 스타일, 운율 표현을 분리하고 프롬프트 음원과 콘텐츠 조건을 다시 결합한다. 악보 조건을 사용하는 SoulX/YingMusic 도구와 인접한 계열이지만 서로 바꿔 쓸 수는 없다.
이전의 변환 및 생성 시스템은 화자, 감정, 리듬을 하나의 잠재변수에 묶는 경우가 많았다. Vevo는 계층적 양자화와 생성을 사용해 결합을 줄인다. 제로샷 능력은 데이터와 프롬프트 인코딩에서 나온다. 임의의 짧은 참조 음원만으로 정체성, 가사, 멜로디가 안정적으로 유지되지는 않는다.
콘텐츠, 운율, 음색을 위한 계층형 조건
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_content콘텐츠 표현q_prosody운율 표현e_timbre음색 임베딩
콘텐츠 토크나이저는 가사와 발음을 보존하고, 운율 토크나이저는 리듬과 음높이 윤곽을 담으며, 음색 임베딩은 정체성 단서를 제공한다. 생성기가 이들을 다시 결합한다. 분리 표현은 목표이지 보장된 결과가 아니다.
Vevo2의 프롬프트 구동 경로는 MIDI 악보 추종이 아니다. SoulX/YingMusic과 비교하려면 먼저 목표가 프롬프트 기반 스타일 전이인지, 편집 가능한 음표와 정확한 길이인지 정해야 한다.
논문, 코드, 가중치는 Amphion Vevo2 소스 / Vevo2 가중치 / Vevo2 논문에서 확인할 수 있다.
동일한 스템 정의에서 비교 가능한 결과
각 행은 자체 소스 아키텍처, 지표 또는 작업 정의를 유지하며, 공통 프로토콜이 없는 결과는 서로 분리한다.
| 모델 | 아키텍처 또는 근거 | 범위 |
|---|---|---|
| Vevo2 | 콘텐츠와 제로샷 스타일/음색 프롬프트 | 표현 분리, 정체성, 샘플링 변동 |
| SoulX-Singer | 참조 구동 가창 | 동일한 프롬프트에서의 음색과 가사 |
| YingMusic-Singer-Plus | 가사와 멜로디/악보 | 음표, 길이, 편집 가능성 |
스템 청취와 믹스 일관성
같은 프롬프트로 여러 번 샘플링하고 가사 명료도, 음높이 윤곽, 리듬, 음색을 각각 확인해야 한다. 결과 하나만 골라 제시하면 변동이 가려진다. 반주, 백 보컬, 리버브는 표현 분리를 더 어렵게 만든다.
악보 구동 시스템을 비교할 때는 목표를 고정해야 한다. Vevo2는 프롬프트 기반 스타일/음색 전이에 적합하고, MIDI/가사 모델은 편집 가능한 음표와 정확한 길이에 적합하다. 두 경로가 공유하는 단일 정확도 값은 없다.
데이터셋 스템 정의의 경계
표현 분리가 정체성 제거를 뜻하지는 않는다. 소스와 목표의 특성이 서로 새어 들어갈 수 있으며, 출력의 익명성도 보장되지 않는다.
가창 프롬프트에는 허가가 필요하고 생성 음원은 합성 사실을 명확히 밝혀야 한다. 유사성은 사칭을 허가하지 않는다.
Amphion Vevo2 소스 관련 논문과 공개 파일
모델 이름, 수치, 한계는 아래 논문, 저장소 또는 모델 카드에서 확인할 수 있다.