نموذج
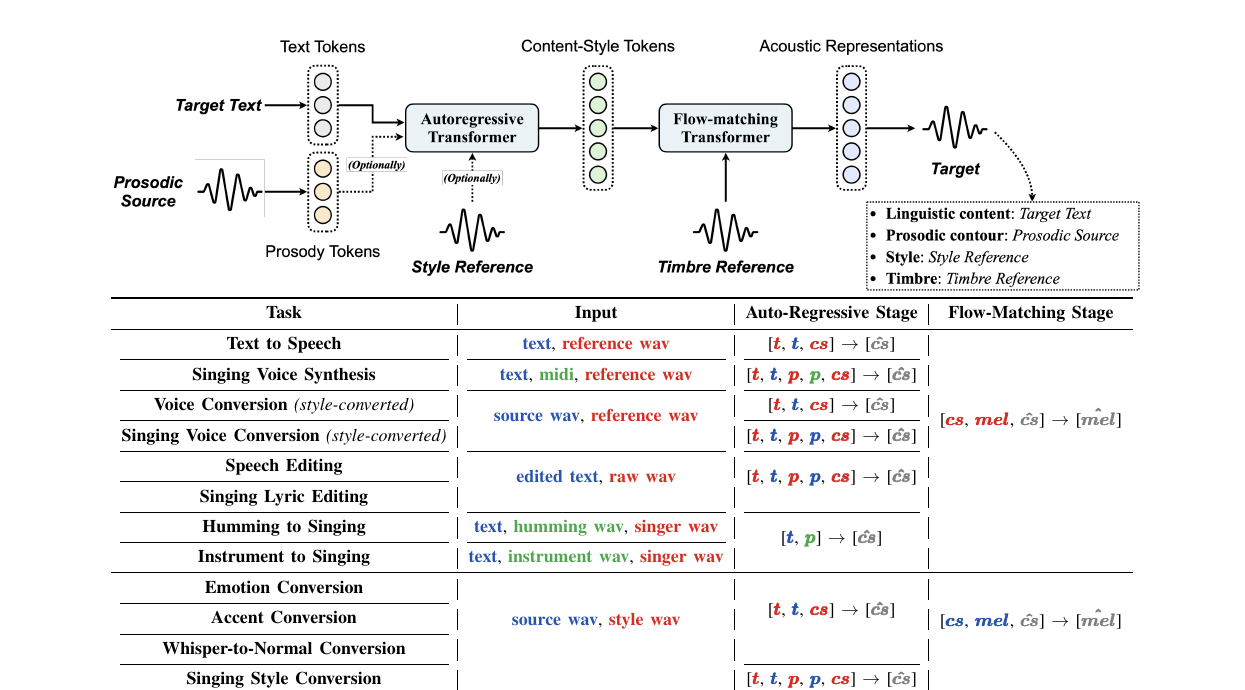
Vevo2: إعادة تنظيم الغناء بناء على ثلاثة شروط: المحتوى والجرس والإيقاع.
تركيب الغناء/الملاحظات الفنية
تركيب الغناء/الملاحظات الفنية
© 2026 تيلك نت. جميع الحقوق محفوظة.
توليد الغناء / ملاحظة تقنية
يستقبل SoulX-Singer الكلمات وMIDI بوصفهما نوتة موسيقية صريحة. أما Vevo2 فيقوده المرجع: إذ تُستخرج token المحتوى والأسلوب وtoken التنغيم من صوت نموذجي قبل أن يبني النموذج الصوتي waveform الهدف. لا ينبغي للمسارين أن يتشاركا عقد إدخال واحدًا.
إذا حمل stream واحد من token الفونيمات وطبقة الصوت والإيقاع والجرس، فإن استبدال عامل واحد يربك العوامل الأخرى. يقلل مسار Vevo هذا الترابط باستخدام quantizer منفصلة. بالنسبة إلى التمثيل الصوتي الكامن z، وtoken المحتوى والأسلوب c، وtoken التنغيم r، يتعلم flow matching ما يلي:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
يدمج الاستدلال حقل السرعة الشرطي، ثم يعيد vocoder بناء الصوت. يحسن الفصل القدرة على التحكم، لكن المرافقة وذيول صدى الغرفة وأخطاء التوقيت في المرجع قد تظل تدخل إلى token.
يناسب Vevo2 نقل أسلوب الغناء والتنغيم من مرجع. لكنه لا يعرض كل بداية ونهاية وvelocity في MIDI، ولا محاذاة الكلمات مع المقاطع، بوصفها عقود تحرير متساوية في الصرامة. يظل SoulX-Singer المسار المباشر لـ MIDI؛ أما Vevo2 فهو ملف التعريف المقابل الذي يقوده المرجع.
قد تظل تمثيلات المحتوى والتنغيم والجرس في Vevo2 تتسرب بعضها إلى بعض، بينما يلوث الصدى والغناء الخلفي والمرافقة prompt. يصف تشابه الصوت سلوك النموذج؛ ولا يمنح إذنًا باستخدام هوية المغني. تحتاج المراجع والمخرجات إلى تصريح وإفصاح واضح عن كونها مصطنعة.
Vevo2 هو مسار الغناء zero-shot في Amphion. لا يقرأ MIDI بوصفه نوتة موسيقية دقيقة؛ بل يفصل تمثيلات المحتوى والجرس والأسلوب والتنغيم، ويعيد دمج صوت prompt مع شروط المحتوى. إنه قريب من أدوات SoulX/YingMusic المشروطة بالنوتة، لكنه ليس بديلًا قابلًا للتبادل معها.
كثيرًا ما كانت أنظمة التحويل والتوليد السابقة تضع المتحدث والعاطفة والإيقاع في تمثيل كامن واحد. يستخدم Vevo quantization وتوليدًا هرميين لتقليل الترابط. تأتي قدرة zero-shot من البيانات وترميز prompt؛ ولا يضمن مرجع قصير عشوائي ثبات الهوية والكلمات واللحن.
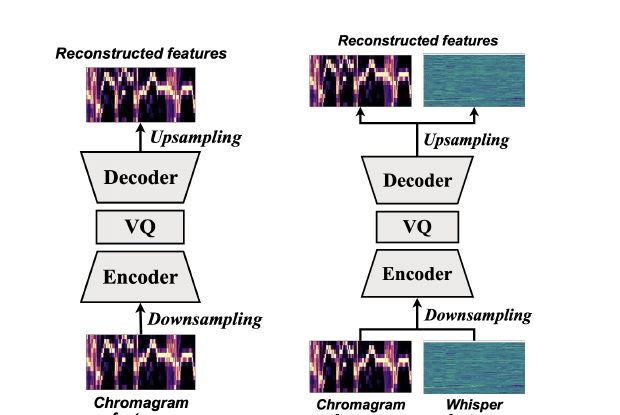
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentتمثيل المحتوىq_prosodyتمثيل التنغيمe_timbreembedding الجرسيحفظ tokenizer المحتوى الكلمات والنطق، ويحمل tokenizer التنغيم الإيقاع والمنحنى، بينما يوفّر embedding الجرس دلائل الهوية. يعيد المولّد دمجها؛ والفصل هدف وليس ضمانًا.
مسار Vevo2 الذي يقوده prompt لا يتبع نوتة MIDI. يجب قبل مقارنته مع SoulX/YingMusic تحديد ما إذا كان الهدف نقل الأسلوب باستخدام prompt أم توفير نغمات قابلة للتحرير ومدة دقيقة.
يمكن تتبع الورقة والكود والأوزان عبر مصدر Amphion Vevo2 / أوزان Vevo2 / ورقة Vevo2.
يحتفظ كل صف بمعمارية مصدره أو مقياسه أو تعريف مهمته؛ وتبقى النتائج التي لا تشترك في بروتوكول واحد منفصلة.
| النموذج | المعمارية أو الدليل | النطاق |
|---|---|---|
| Vevo2 | المحتوى مع prompt للأسلوب والجرس بأسلوب zero-shot | الفصل والهوية وتباين أخذ العينات |
| SoulX-Singer | غناء يقوده المرجع | الجرس والكلمات تحت prompt نفسه |
| YingMusic-Singer-Plus | الكلمات مع اللحن أو النوتة | النغمات والمدة وقابلية التحرير |
خذ عينات متكررة من prompt نفسه وافحص وضوح الكلمات ومنحنى طبقة الصوت والإيقاع والجرس كلًا على حدة. انتقاء نتيجة واحدة يخفي التباين؛ وتجعل المرافقة والغناء الخلفي والصدى عملية الفصل أصعب.
ثبّت الهدف عند مقارنة الأنظمة التي تقودها النوتة: يناسب Vevo2 نقل الأسلوب والجرس استنادًا إلى prompt، بينما تناسب نماذج MIDI والكلمات النغمات القابلة للتحرير والمدة الدقيقة. ولا تشترك هذه المسارات في قيمة دقة واحدة.
فصل التمثيلات ليس إزالة للهوية. قد تتسرب سمات المصدر والهدف، ولا يوجد ضمان بأن يكون الناتج مجهول الهوية.
تتطلب prompt الغناء إذنًا، ويحتاج الصوت المولد إلى إفصاح واضح. التشابه لا يجيز انتحال الهوية.
تعود أسماء النماذج والأرقام والقيود إلى الأوراق أو المستودعات أو بطاقات النماذج أدناه.