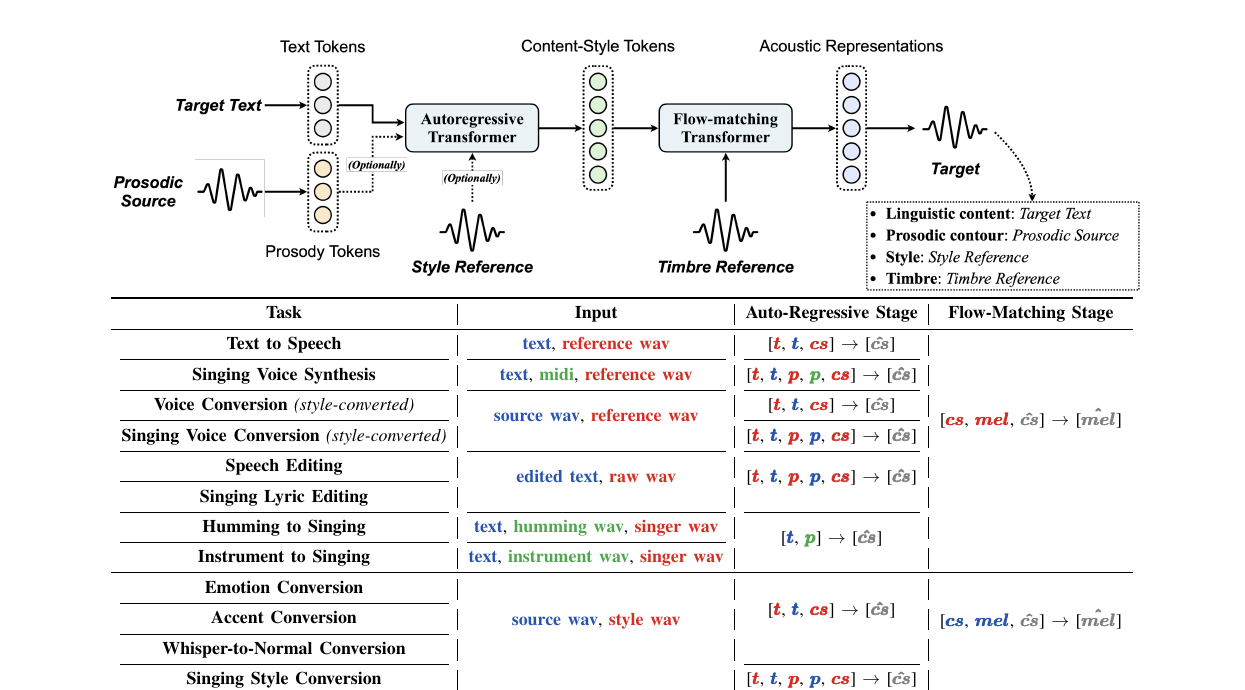
Vevo2: 内容、音色、リズムの 3 つの条件に基づいて歌唱を再編成します。
歌唱合成/技術メモ
歌声合成 / 技術ノート
SoulX-Singer は歌詞と MIDI を明示的な楽譜として受け取ります。Vevo2 は参照駆動型であり、音響モデルが目的の waveform を構築する前に、サンプル音声から内容・スタイル token と韻律 token を抽出します。この二つの経路に同じ入力契約を適用すべきではありません。
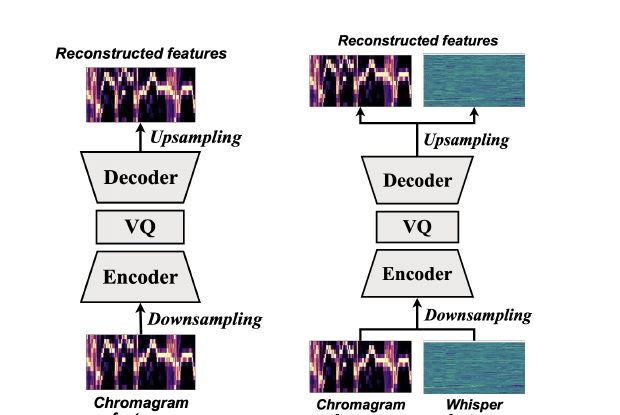
Tokenizer が二つ必要な理由
一つの token stream が音素、pitch、リズム、音色を担うと、一要素の置き換えがほかの要素を乱します。Vevo の経路では、個別の quantizer によってこの結合を弱めます。音響 latent z、内容・スタイル token c、韻律 token r に対して、flow matching は次を学習します。
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
推論では条件付き velocity field を積分し、vocoder が音声を再構築します。分離によって制御性は向上しますが、参照音声の伴奏、部屋の残響、timing error が token に入り込む可能性は残ります。
楽譜 editor ではない
Vevo2 は参照音声から歌唱スタイルと韻律を受け継ぐ用途に適しています。すべての MIDI onset、offset、velocity、歌詞と音節の alignment を、同じ厳密さを持つ編集契約として公開するものではありません。SoulX-Singer は直接 MIDI を扱う経路であり、Vevo2 はそれに対応する参照駆動型 profile です。
Zero-shot の類似性と許可
Vevo2 の内容、韻律、音色の表現は相互に漏れ出す可能性があり、reverb、backing vocal、伴奏も prompt を汚染します。音声類似度はモデルの挙動を説明するもので、歌手の identity を使用する許可を与えるものではありません。参照音声と出力には、許可と合成音声であることの明確な開示が必要です。
固定音源から条件付き分離へ
Vevo2 は Amphion の zero-shot 歌唱経路です。MIDI を厳密な楽譜として読み取るのではなく、内容、音色、スタイル、韻律の表現を分離し、prompt 音声を内容条件と再結合します。楽譜条件付きの SoulX/YingMusic ツールに隣接する方式ですが、相互に置き換えることはできません。
以前の変換・生成 system は、話者、感情、リズムを一つの latent にまとめることがよくありました。Vevo は階層的な quantization と生成によって結合を弱めます。Zero-shot 能力はデータと prompt encoding に由来します。任意の短い参照だけで、identity、歌詞、メロディーが安定するとは限りません。
内容、韻律、音色を階層化した条件
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_content内容表現q_prosody韻律表現e_timbre音色 embedding
内容 tokenizer は歌詞と調音を保ち、韻律 tokenizer はリズムと輪郭を運び、音色 embedding は identity の手がかりを与えます。Generator はそれらを再結合します。Disentanglement は目標であって保証ではありません。
Vevo2 の prompt 駆動経路は MIDI 楽譜追従ではありません。SoulX/YingMusic と比較する前に、目的が prompt ベースのスタイル転送なのか、編集可能な音符と正確な長さなのかを固定する必要があります。
論文、code、weight は Amphion Vevo2 のソース / Vevo2 の weight / Vevo2 論文から確認できます。
同じ stem 定義の下で比較できる結果
各行では、出典の architecture、metric、または task 定義を維持しています。共通 protocol のない結果は別々に扱います。
| モデル | Architecture または根拠 | 対象範囲 |
|---|---|---|
| Vevo2 | 内容と zero-shot のスタイル・音色 prompt | disentanglement、identity、sampling variance |
| SoulX-Singer | 参照駆動型の歌唱 | 同じ prompt の下での音色と歌詞 |
| YingMusic-Singer-Plus | 歌詞とメロディー・楽譜 | 音符、長さ、編集可能性 |
Stem の聴取と mixture の一貫性
同じ prompt から繰り返し sample を生成し、歌詞の明瞭さ、pitch contour、リズム、音色を個別に確認してください。一つの結果だけを選ぶと variance が隠れます。伴奏、backing vocal、reverb は disentanglement をさらに難しくします。
楽譜駆動 system を比較するときは、対象を固定してください。Vevo2 は prompt ベースのスタイル・音色転送に適し、MIDI・歌詞モデルは編集可能な音符と正確な長さに適します。両者は一つの accuracy 値を共有しません。
Dataset の stem 定義が及ぶ境界
表現の disentanglement は identity の除去ではありません。音源側と目標側の特徴が漏れる可能性があり、出力が匿名になる保証もありません。
歌唱 prompt には許可が必要で、生成音声には明確な開示が必要です。類似していることは、なりすましを許可しません。
Amphion Vevo2 のソースに関する論文と公開ファイル
モデル名、数値、制約の出典は、以下の論文、repository、model card です。