Model
Vevo2: Reorganizacja śpiewu oparta na trzech warunkach: treści, barwie i rytmie.
Synteza śpiewu/notatki techniczne
Synteza śpiewu/notatki techniczne
© 2026 TelkNet. Wszelkie prawa zastrzeżone.
SYNTEZA ŚPIEWU / NOTA TECHNICZNA
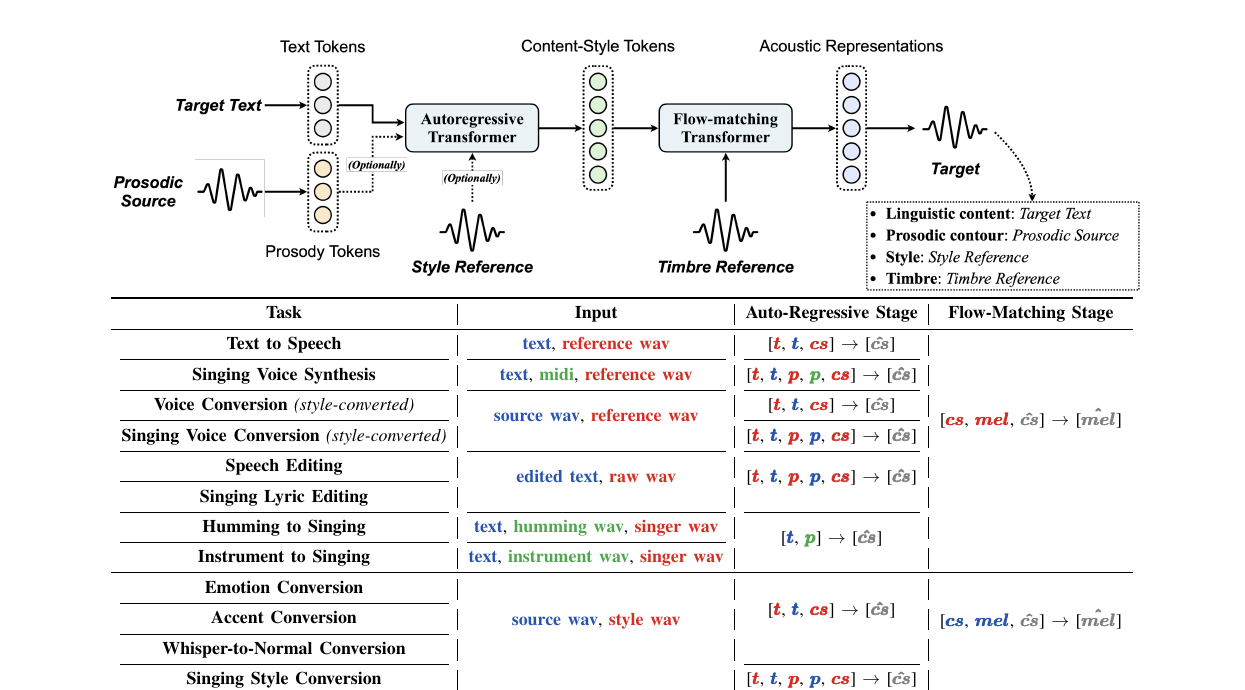
SoulX-Singer przyjmuje tekst i MIDI jako jawną partyturę. Vevo2 opiera się na materiale referencyjnym: tokeny treści i stylu oraz tokeny prozodii są wyodrębniane z przykładowego dźwięku, zanim model akustyczny zbuduje docelowy przebieg fali. Obie ścieżki nie powinny współdzielić jednego kontraktu wejściowego.
Jeśli jeden strumień tokenów przenosi fonemy, wysokość dźwięku, rytm i barwę, zastąpienie jednego czynnika zaburza pozostałe. Ścieżka Vevo ogranicza to sprzężenie dzięki oddzielnym kwantyzatorom. Dla akustycznej reprezentacji ukrytej z, tokenów treści i stylu c oraz tokenów prozodii r flow matching uczy się:
L_FM = E ||v_θ(z_t,t,c,r)-u_t||²
Inferencja całkuje warunkowe pole prędkości, a vocoder rekonstruuje dźwięk. Rozdzielenie poprawia sterowanie, lecz akompaniament, pogłos pomieszczenia i błędy czasowe z materiału referencyjnego nadal mogą trafiać do tokenów.
Vevo2 nadaje się do przenoszenia stylu śpiewu i prozodii z materiału referencyjnego. Nie udostępnia każdego początku i końca nuty MIDI, velocity ani powiązania tekstu z sylabami jako równie ścisłego kontraktu edycji. SoulX-Singer pozostaje bezpośrednią ścieżką MIDI; Vevo2 jest odpowiadającym jej profilem opartym na materiale referencyjnym.
Reprezentacje treści, prozodii i barwy w Vevo2 nadal mogą przenikać się wzajemnie, a pogłos, wokale wspierające i akompaniament zanieczyszczają prompt. Podobieństwo głosu opisuje zachowanie modelu; nie daje zgody na wykorzystanie tożsamości wykonawcy. Materiały referencyjne i wyniki wymagają upoważnienia oraz wyraźnego ujawnienia, że są syntetyczne.
Vevo2 jest ścieżką śpiewu zero-shot projektu Amphion. Nie odczytuje MIDI jako dokładnej partytury; rozdziela reprezentacje treści, barwy, stylu i prozodii, a następnie łączy dźwięk promptu z warunkami treści. Jest rozwiązaniem sąsiadującym z narzędziami SoulX/YingMusic warunkowanymi partyturą, ale nie jest z nimi wymienne.
Wcześniejsze systemy konwersji i generowania często pakowały mówcę, emocje i rytm w jedną reprezentację ukrytą. Vevo używa hierarchicznej kwantyzacji i generowania, aby zmniejszyć sprzężenie. Zdolność zero-shot wynika z danych i kodowania promptu; dowolna krótka próbka nie gwarantuje stabilnej tożsamości, tekstu ani melodii.
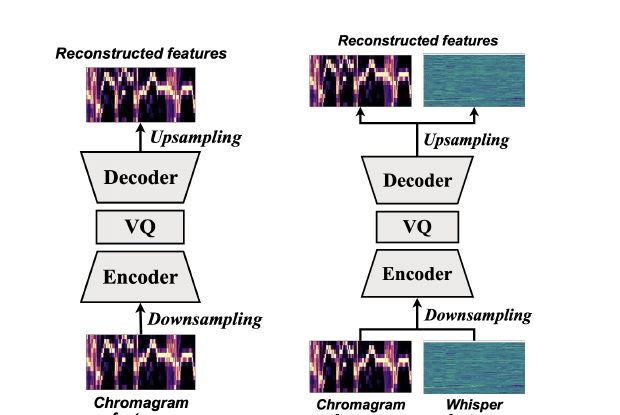
ŷ=G(q_content(x_c),q_prosody(x_r),e_timbre(x_r))q_contentreprezentacja treściq_prosodyreprezentacja prozodiie_timbreembedding barwyTokenizer treści zachowuje tekst i artykulację, tokenizer prozodii przenosi rytm i kontur, a embedding barwy dostarcza wskazówek tożsamości. Generator łączy je ponownie; rozplątanie jest celem, a nie gwarancją.
Oparta na promptach ścieżka Vevo2 nie podąża za partyturą MIDI. Porównanie z SoulX/YingMusic wymaga najpierw ustalenia, czy celem jest przenoszenie stylu na podstawie promptu, czy edytowalne nuty i dokładny czas trwania.
Artykuł, kod i wagi można prześledzić przez źródła Amphion Vevo2 / wagi Vevo2 / artykuł Vevo2.
Każdy wiersz zachowuje architekturę, metrykę lub definicję zadania ze swojego źródła; wyniki bez wspólnego protokołu pozostają oddzielne.
| Model | Architektura lub dowód | Zakres |
|---|---|---|
| Vevo2 | treść oraz zero-shot prompt stylu i barwy | rozplątanie, tożsamość i wariancja próbkowania |
| SoulX-Singer | śpiew oparty na materiale referencyjnym | barwa i tekst w ramach tego samego promptu |
| YingMusic-Singer-Plus | tekst wraz z melodią lub partyturą | nuty, czas trwania i możliwość edycji |
Wielokrotnie próbkuj z tego samego promptu i osobno sprawdzaj wyrazistość tekstu, kontur wysokości, rytm oraz barwę. Wybór jednego najlepszego wyniku ukrywa wariancję; akompaniament, wokale wspierające i pogłos utrudniają rozplątanie.
Podczas porównywania systemów sterowanych partyturą ustal ten sam cel: Vevo2 nadaje się do przenoszenia stylu i barwy na podstawie promptu, a modele MIDI i tekstu do edytowalnych nut oraz dokładnego czasu trwania. Nie dzielą one jednej wartości dokładności.
Rozplątanie reprezentacji nie jest usunięciem tożsamości. Cechy źródła i celu mogą przenikać, a anonimowość wyniku nie jest gwarantowana.
Prompty wokalne wymagają zgody, a wygenerowany dźwięk wyraźnego ujawnienia. Podobieństwo nie upoważnia do podszywania się pod inną osobę.
Nazwy modeli, liczby i ograniczenia pochodzą z poniższych artykułów, repozytoriów lub kart modeli.