Phân tích tách âm thanh bốn stem: vì sao Huge-SCNet hợp với mục tiêu MSS · TelkNet
Mô hình
Phân tích tách âm thanh bốn stem: vì sao Huge-SCNet hợp với mục tiêu MSS
Công cụ bốn stem hiện tại của TelkNet dùng Huge-SCNet-4stems V1.2 để tách bản mix đầy đủ thành vocals, drums, bass và other. Bài viết giải thích lựa chọn qua lịch sử kiến trúc MSS, điểm mạnh và giới hạn của Mel-Band RoFormer, mô hình subband của SCNet và điểm số công khai.
Tin tức mô hình / Tách nguồn nhạc
Ngày đăng: 2026-06-30
Mô hình bốn stem hiện tại: Huge-SCNet-4stems V1.2
Đầu ra tiêu chuẩn: giọng hát / trống / bass / khác
Chủ đề: kiến trúc MSS, giới hạn của Mel-Band RoFormer, đánh đổi của SCNet
Tóm tắt
Tách nguồn nhạc bằng AI đã vượt qua câu hỏi đơn giản là có thể rút giọng hát ra khỏi bản phối hay không. Với phối lại, lấy mẫu, luyện tập, Music-to-MIDI, âm thanh không gian và làm sạch tư liệu, câu hỏi hữu ích là kết quả có còn chỉnh sửa được hay không. Tách bốn stem tiêu chuẩn theo đuổi mục tiêu khắt khe hơn đó: chia toàn bộ bản phối thành giọng hát, trống, bass và khác, thay vì chỉ tạo tệp giọng hát và nhạc đệm.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer và Huge-SCNet-4stems V1.2 đại diện cho những cách tiếp cận bốn stem khác nhau. Chỉ riêng sức mạnh ở giọng hát không quyết định chất lượng bốn stem. Một ensemble cấp nền tảng có thể đạt điểm cao dù không phải mô hình độc lập có thể tải xuống, trong khi một checkpoint công khai cung cấp hiện vật có thể tái lập.
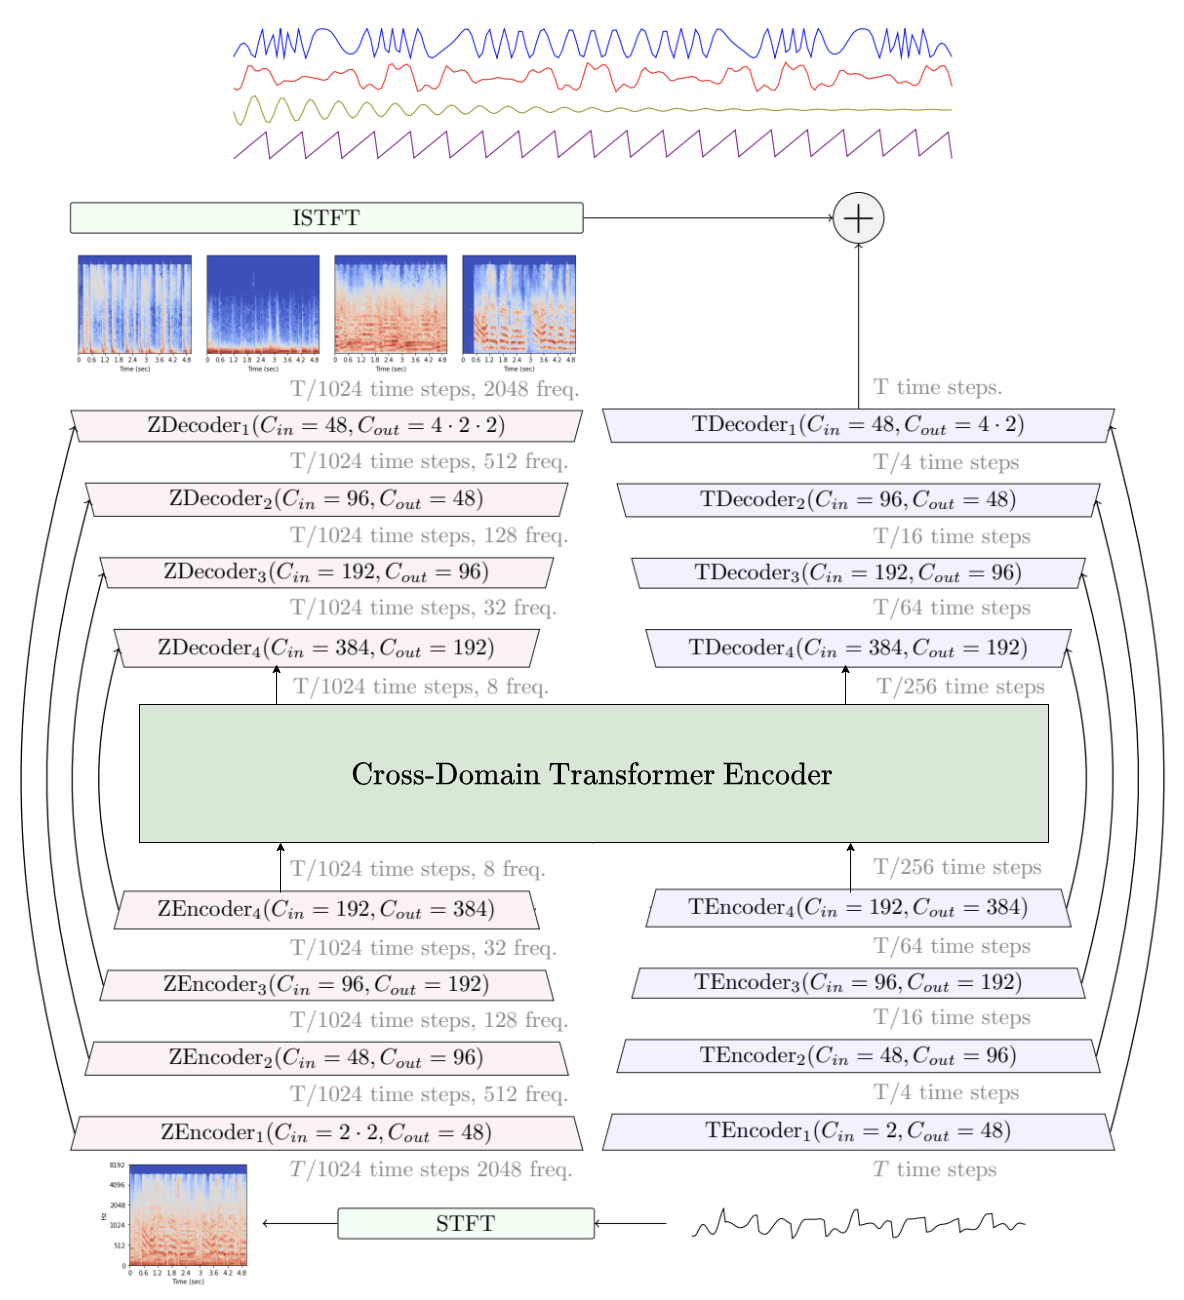
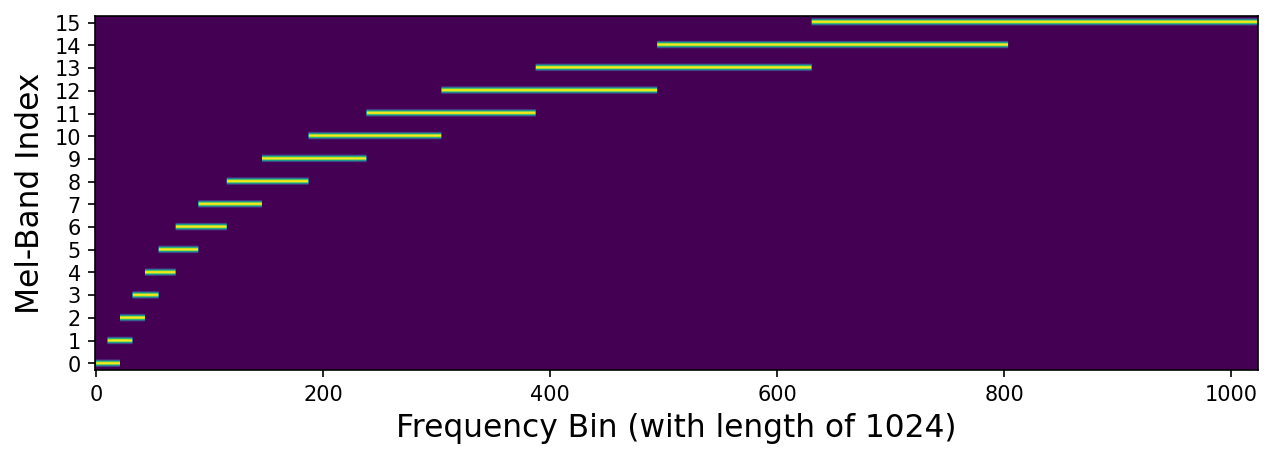
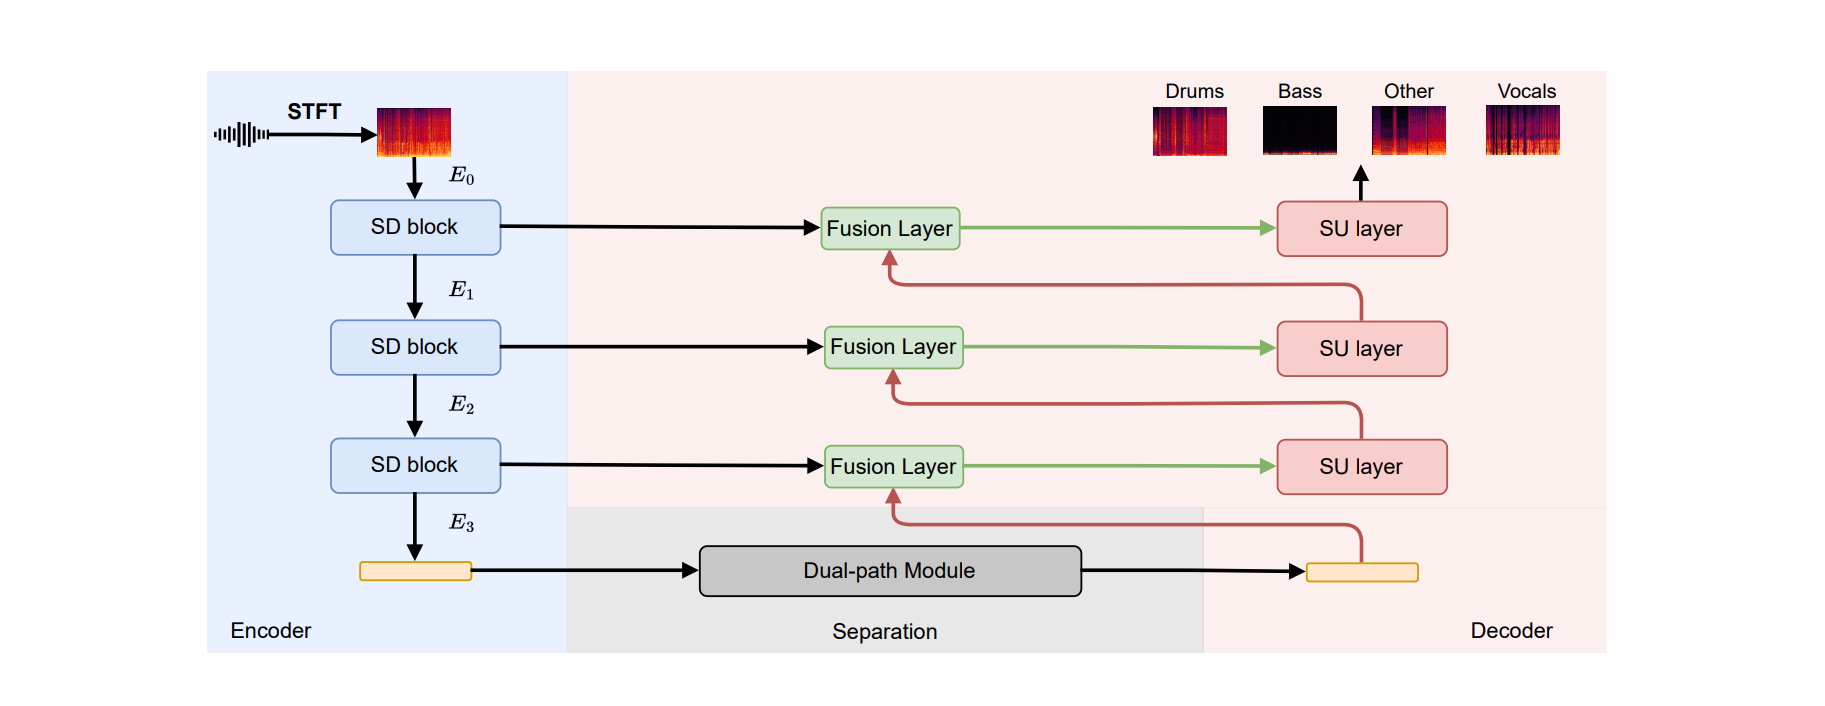
HTDemucs Sơ đồ cấu trúc chính thức của bài báo: hai nhánh miền dạng sóng và miền phổ hội tụ bên trong mô hình. Thiết kế đại diện của giai đoạn "miền kép" trong dòng thời gian bên dưới trông như thế này (nguồn: Hybrid Transformers paper, arXiv:2211.08553).Mel-Band RoFormer Sơ đồ chính thức của Paper: cách các thùng quang phổ được ánh xạ tới các băng tần con chồng chéo được tổ chức theo thang đo mel. Các dải con thu được ở tần số trung-thấp dày đặc hơn nên chi tiết giọng hát được thể hiện chi tiết hơn (nguồn: arXiv:2310.01809).Sơ đồ kiến trúc chính thức của SCNet paper: Vị trí của mô-đun nén thưa thớt giữa bộ mã hóa và mạng phân tách rõ ràng ngay lập tức - trước tiên, nén các khu vực có mật độ thông tin thấp, sau đó để sức mạnh tính toán cho các ranh giới giọng nói đông đúc (nguồn: SCNet paper, arXiv:2401.13276).
Các trang thuật toán công khai và bảng xếp hạng của MVSep là những điểm tham chiếu phổ biến trong tách nguồn nhạc. Chúng ghi lại kết quả và cấu hình; không nên hiểu một quy trình ensemble là một mô hình độc lập duy nhất.
Bốn stem không phải tên gọi khác của nhạc đệm
Tách bốn stem tiêu chuẩn thường có nghĩa là giọng hát, trống, bass và khác. Giọng hát là phần hát, trống là bộ trống, bass là phần bass, còn khác chứa những nhạc cụ còn lại: guitar, piano, bộ dây, synthesizer, bộ đồng, hiệu ứng và nhiều thành phần khác. Phần nhạc đệm nghe được sau khi tắt giọng hát thực chất là tổng của trống, bass và khác.
Mục tiêu này bắt nguồn từ các bộ dữ liệu chính và truyền thống đánh giá trong tách nguồn nhạc. MUSDB18 và MUSDB18-HQ từ lâu đã định hình việc huấn luyện và đánh giá mô hình xoay quanh bốn stem này. Khi cộng đồng nói 4-stem, họ thường nói đến mục tiêu đầu ra này.
Sự phân biệt này làm thay đổi lựa chọn công cụ. Nếu mục tiêu là giọng hát sạch hoặc bản nhạc không lời, bộ tách giọng hai stem là lựa chọn trực tiếp hơn. Nếu mục tiêu là luyện trống, phân tích bass, lấy mẫu, phối lại hoặc làm sạch tư liệu có thể chỉnh sửa, bốn stem hữu ích hơn. Khác không phải là nhạc đệm kém hơn; đó là nhóm nhạc cụ khó nhất trong hệ thống.
Bốn giai đoạn từ U-Net đến SCNet
Tách nguồn nhạc là nỗ lực khôi phục nhiều nguồn từ một dạng sóng đã trộn theo cả thời gian và tần số. Các mô hình trước đây có thể tạo đầu ra nghe được, nhưng những hiện vật méo tiếng rất quen thuộc: giọng hát rò rỉ, tiếng trống lẫn sang stem khác, bass đục, tần số cao bị nhòe hoặc chất lượng pha bị xé trong các bản phối dày đặc.
Giai đoạn
Hướng tiếp cận tiêu biểu
Tiến bộ
Vấn đề còn lại
2020-2021
VR Architecture / U-Net
Xử lý phổ ảnh như hình ảnh và đưa việc tách giọng hát/nhạc đệm cơ bản vào thực tế.
Các cửa sổ tích chập cục bộ gặp khó với ngữ cảnh âm nhạc dài và quan hệ pha.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Kết hợp mô hình hóa dạng sóng và phổ ảnh, cải thiện chất lượng cùng độ ổn định khi tái tạo.
Cao trào dày đặc, độ vang lớn và transient phức tạp vẫn có thể tạo ra hiện vật méo tiếng.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Dùng chia dải, RoPE và mô hình hóa thời gian-tần số mạnh hơn cho giọng hát, hòa âm, luyến âm và âm ngân.
Cách phân bổ tần số ưu tiên giọng hát không tự động là lựa chọn tốt nhất cho mọi nhạc cụ trong bốn stem.
2024-2026
SCNet / Huge-SCNet (Tsinghua SIGS, Skywork AI, Peng Cheng Lab, CUHK và các đơn vị khác)
Dùng mô hình hóa dải con và nén thưa để tập trung vào những vùng thời gian-tần số giàu thông tin.
Mục tiêu vẫn là tách bốn stem tiêu chuẩn, không phải đầu ra sáu stem hay ensemble cấp nền tảng.
Lịch sử này giải thích vì sao không thể giản lược việc chọn mô hình thành chất lượng giọng hát. Tách bốn stem còn phải giữ được transient của trống, tần số cơ bản và họa âm của bass, ranh giới giọng hát cùng chi tiết tần số cao trong stem khác.
Mốc thời gian cũng phụ thuộc vào phạm vi nguồn: bài báo SCNet được công bố vào tháng 1 năm 2024, còn Huge-SCNet-4stems V1.2 thuộc bối cảnh checkpoint công khai về sau. Vì vậy, dòng thời gian này dùng 2024-2026 thay vì ngụ ý rằng bản thân SCNet chỉ xuất hiện sau 2025.
Mel-Band RoFormer: thế mạnh giọng hát và giới hạn bốn stem
Mel-Band RoFormer do nhóm Speech, Audio, and Music Intelligence (SAMI) của ByteDance đề xuất. Các tác giả bài báo là Ju-Chiang Wang, Wei-Tsung Lu và Minz Won; trang tiêu đề ghi đơn vị là SAMI, ByteDance. Các trang cộng đồng đôi khi tóm tắt hướng này là ByteDance AI Labs, nhưng cách diễn đạt chính xác nhất theo nguồn là các tác giả bài báo và SAMI, ByteDance.
Mô hình hấp dẫn vì định hình các dải tần gần hơn với thính giác con người. Tai nhạy hơn với tần số thấp và trung, nơi chứa tần số cơ bản của giọng hát, phụ âm, hơi thở và nhiều tín hiệu cao độ. Phép chiếu mel-band biểu diễn dải này chi tiết hơn, giúp mô hình bám theo giọng chính, bè, luyến, rung và đuôi reverb.
Họ RoFormer dùng mã hóa vị trí xoay, hay RoPE, trên cả chuỗi thời gian lẫn chuỗi dải con. Điều này khiến điểm attention phụ thuộc vào vị trí tương đối. Luyến âm, âm ngân và cụm nhạc lặp lại là những trực giác cấu trúc hữu ích cho đặc tính đó, nhưng bài báo chỉ trực tiếp kiểm thử các mô hình có RoPE so với không có RoPE trong điều kiện kiểm soát; bài báo không công bố chỉ số riêng cho luyến âm hoặc hòa âm kéo dài.
Đường đi tín hiệu được định nghĩa trong bài báo
BS-RoFormer trước hết chuyển dạng sóng của bản trộn thành phổ ảnh phức. Phép chiếu dải và Transformer phân cấp ước lượng một mặt nạ phức, mặt nạ đó được áp dụng lên phổ của bản trộn, rồi STFT nghịch đảo tái tạo dạng sóng đích. Mel-RoFormer thay đổi phép chiếu bên trong fθ: các dải mel chồng lấn thay thế cách chia theo kinh nghiệm, không chồng lấn. Nó không thay thế toàn bộ đường tái tạo.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: phổ ảnh phức của bản trộn, gồm cả thành phần thực và ảo.
fθ: phép chiếu dải, Transformer trong dải/giữa các dải và ước lượng mặt nạ.
M̂: mặt nạ đích phức dùng để khôi phục biên độ và pha.
ŷ: dạng sóng được tái tạo bằng STFT nghịch đảo và được ràng buộc bởi mất mát dạng sóng cùng mất mát phổ trong quá trình huấn luyện.
Đó là lý do Mel-Band RoFormer là hướng mạnh cho các tác vụ giọng hát/nhạc đệm, giọng chính/bè và trích xuất giọng hát sạch. Vấn đề là tách bốn stem không chỉ xoay quanh giọng hát. Mô hình còn phải tách trống, bass và khác, trong khi khác thường chứa chi tiết nhạc cụ tần số cao khó nhất.
Sau các bài báo: RoFormer trở thành hệ sinh thái công cụ mở như thế nào
BS-RoFormer xuất hiện vào tháng 9 năm 2023 với hai loại bằng chứng trong một bài báo. Hệ thống L=12 lớn hơn, được huấn luyện trên MUSDB18HQ cùng 500 bài hát nội bộ, ghi lại bài dự thi SDX23 đứng đầu của SAMI-ByteDance. Các mô hình nhỏ hơn chỉ dùng MUSDB18HQ cung cấp phép ablation có kiểm soát cho RoPE, chia dải và tái tạo bằng chồng lấn-rồi-lấy-trung-bình. Bài báo công bố kiến trúc, điều kiện huấn luyện và bảng kết quả. Bài báo không đính kèm checkpoint SDX23 ban đầu hoặc liên kết kho huấn luyện và suy luận của ByteDance/SAMI.
Mel-Band RoFormer tiếp nối vào tháng 10 năm 2023. Nó giữ lại RoPE Transformer, mô hình hóa chuỗi trong dải/giữa dải, mặt nạ phức và tái tạo dạng sóng, nhưng thay cách chia thủ công không chồng lấn bằng 60 dải mel chồng lấn. Khoảng cách một tháng rất quan trọng: đây là bản sửa đổi công khai cho phép chiếu tần số do chính hạn chế của bài báo trước thúc đẩy, không phải gói checkpoint chính thức thứ hai được phát hành cùng văn bản.
Mã thực thi được tích lũy bên ngoài các bài báo. Kho lucidrains chuyển sơ đồ và phương trình thành các lớp mô hình PyTorch, đồng thời công khai mời mọi người tái tạo bộ tách. Xử lý stereo, nhiều stem đầu ra và biến thể Mel-Band khiến cấu trúc có thể tái sử dụng, nhưng chỉ riêng mã nguồn không thể tái tạo các bài hát nội bộ, trạng thái optimizer, thời lượng huấn luyện hay tham số cuối cùng của cuộc thi.
Sau đó Music-Source-Separation-Training mang đến một xưởng chung cho cấu trúc có thể tái sử dụng này: bộ nạp dữ liệu, tăng cường dữ liệu, huấn luyện, xác thực, tiếp tục từ checkpoint, suy luận theo khối, chồng lấn và ensembling. README ghi công lucidrains vì đã tái tạo các mô hình RoFormer từ bài báo và chấp nhận mô hình do cộng đồng gửi. Một kiến trúc lúc này có thể được huấn luyện để tách giọng hát/nhạc cụ, bốn stem, các stem con của trống hoặc những mục tiêu chuyên biệt khác. Không có một trọng số cộng đồng chuẩn duy nhất.
Mô hình giọng hát của Kimberley Jensen khiến quy trình trở nên cụ thể. Kho mã cho biết mô hình được huấn luyện với nhiều dữ liệu hơn bằng mã của ZFTurbo, mặc định dùng khối tám giây và cung cấp num_overlap để giảm hiện vật tại điểm ghép, đổi lại suy luận lâu hơn. Kho cũng ghi công những người đóng góp vào bộ dữ liệu. Những chi tiết này giải thích vì sao một checkpoint có thể tải xuống mang đặc tính mà chỉ tên kiến trúc không thể mô tả.
Trang MVSep hiện tại ghi nhận Kimberley Jensen là người cung cấp các trọng số công khai chất lượng cao đầu tiên, sau đó mô tả việc sửa đổi và tiếp tục huấn luyện các trọng số mở. Bas Curtiz, unwa, becruily, gabox cùng những phiên bản khác xuất hiện trên cùng trang với các đánh đổi khác nhau về độ đầy, rò âm, nhiễu và SDR. Đây là một phả hệ trọng số phân nhánh: các mô hình cùng dùng Mel-Band RoFormer, nhưng không dùng chung dữ liệu, mục tiêu, lịch sử fine-tuning hoặc âm thanh cuối cùng.
Bản tổng hợp dựa trên hai bài báo RoFormer, phần triển khai của lucidrains và framework huấn luyện ZFTurbo/MVSep. Các mũi tên thể hiện sự phụ thuộc triển khai, không phải xác nhận chính thức.
Tên hoặc hiện vật
Nó xác định điều gì
Điều gì vẫn cần bằng chứng xuất xứ
BS-RoFormer / Mel-Band RoFormer
Phép chiếu dải, RoPE và thiết kế mô hình hóa chuỗi theo trục.
Người huấn luyện checkpoint cụ thể, dữ liệu, các stem đích và tập đánh giá.
Một tệp checkpoint có thể tải xuống
Một bộ tham số thường phụ thuộc vào cấu hình tương ứng.
Nó đến từ tác giả bài báo, huấn luyện cộng đồng hay fine-tuning về sau.
Một quy trình Mel-Band / BS-RoFormer được lưu trữ
Dịch vụ đã chọn trọng số, cách chia khối, độ chồng lấn và đầu ra.
Không thể đổi nhãn điểm của quy trình lưu trữ thành kết quả SDX23 hoặc kết quả bài báo gốc.
Giờ đây, một tên kiến trúc có thể chỉ hệ thống thi đấu, ablation trong bài báo, checkpoint giọng hát, checkpoint bốn stem hoặc ensemble cấp nền tảng. Nội dung chính xác phải nêu rõ ba điều: ai đề xuất kiến trúc, trọng số hiện tại đến từ đâu và công thức suy luận nào tạo ra kết quả. Nếu thiếu bất kỳ điều nào, những cụm như “mô hình ByteDance chính thức” hay “điểm thi đấu bốn stem của Mel-Band” sẽ âm thầm ghép các hiện vật khác nhau ở những thời điểm khác nhau trong lịch sử này.
So sánh có kiểm soát: Mel không thay thế BS trên mọi stem
Bằng chứng rõ ràng nhất là phép so sánh có kiểm soát trong bài báo Mel-Band năm 2023, không phải sự pha trộn giữa các trang MVSep và checkpoint cộng đồng không liên quan. Mỗi hàng dưới đây đều dùng MUSDB18HQ mà không có bài hát bổ sung. Ở mỗi độ sâu, thay đổi chính nằm ở phép chiếu: các dải theo kinh nghiệm, không chồng lấn của BS-RoFormer được thay bằng 60 dải mel chồng lấn.
Kết quả là một sự đánh đổi, không phải thắng toàn diện. Ở L=6, giọng hát tăng từ 10.78 lên 11.21 dB và trống từ 9.61 lên 9.91 dB, trong khi bass giảm từ 11.43 xuống 9.64 dB và khác giảm nhẹ từ 7.86 xuống 7.81 dB. Ở L=9, giọng hát tăng 0.58 dB và khác tăng 0.13 dB, trống giảm 0.32 dB, còn bass không được báo cáo vì huấn luyện tiến triển quá chậm.
Mô hình trong bài báo (MUSDB18HQ, không có dữ liệu bổ sung)
Giọng hát
Bass
Trống
Khác
SDR trung bình
Tham số
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
không được báo cáo
9.34
7.93
không được báo cáo
94.8M
Bài báo liên hệ kết quả bass với phép ánh xạ tần số. BS-RoFormer chủ ý phân bổ các dải mịn ở tần số thấp, trong khi phép chiếu mel hữu ích hơn cho giọng hát và một số mục tiêu không phải bass. Vì vậy, kết luận kỹ thuật hữu ích phụ thuộc vào tác vụ: phép chiếu mel là lựa chọn mạnh cho giọng hát, nhưng chỉ riêng động cơ tâm lý âm học không chứng minh được ưu thế ở bốn stem.
SCNet và mục tiêu bốn stem
SCNet nhìn phổ theo hướng chú trọng thông tin hơn. Các tác giả bài báo gồm Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu và Helen Meng; trang tiêu đề liệt kê Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab và The Chinese University of Hong Kong trong số các đơn vị liên kết. Về kiến trúc, SCNet chia rõ phổ ảnh của bản trộn thành các dải con và dùng nén thưa để xử lý mật độ thông tin khác nhau giữa các dải này. Nói đơn giản hơn, nó không dồn gần như toàn bộ năng lực vào dải giọng hát. Nó buộc mô hình tập trung vào những vùng thời gian-tần số thực sự mang tín hiệu nhạc cụ hữu ích.
Điều đó quan trọng với bốn stem. Bass nằm ở vùng thấp nhưng mang các họa âm quan trọng. Trống kết hợp transient rất ngắn với cymbal và âm phòng. Khác có thể đồng thời chứa guitar, piano, bộ dây, synthesizer và hiệu ứng. Mô hình hóa dải con cho phép xử lý từng vùng tần số có mục tiêu hơn, còn nén thưa giúp sự chú ý tránh xa vùng trống hoặc ít thông tin.
Bài báo SCNet mô tả toàn bộ hệ thống gồm bộ mã hóa âm thanh, mạng tách dựa trên RNN hai đường và bộ giải mã âm thanh. Bộ mã hóa ánh xạ bản trộn thành các biểu diễn dải con trong miền tần số, mạng tách mô hình hóa cấu trúc theo thời gian và tần số, còn bộ giải mã tái tạo các stem đích.
Huge-SCNet-4stems V1.2 thuộc hướng này. Hợp đồng đầu ra của nó là một bộ tệp giọng hát, trống, bass và khác cân bằng để có thể tiếp tục đưa vào phối lại hoặc phiên âm, thay vì mục tiêu tối ưu hóa chỉ dành cho giọng hát.
Cũng cần phân biệt bài báo SCNet với checkpoint Huge-SCNet-4stems V1.2. Bài báo cung cấp kiến trúc nén thưa, thiết kế dải con và kết quả nghiên cứu MUSDB18-HQ; hiện vật có thể tải xuống là checkpoint Hugging Face công khai huge_scnet_4stems_v1.2.ckpt. Checkpoint cộng đồng này không thể kế thừa kết quả 9.0 dB trên MUSDB18-HQ của bài báo vì dữ liệu và xuất xứ bản phát hành khác nhau.
Ranh giới mã nguồn cũng phải được giữ riêng. Các tác giả bài báo phát hành thuhcsi/SCNet làm kho triển khai chính thức, nhưng kho này cho biết mã huấn luyện vẫn cần hoàn thiện và hướng người đọc đến HTDemucs, Music-Source-Separation-Training cùng SCNet-PyTorch như các framework huấn luyện tạm thời. Vì vậy, Huge-SCNet-4stems V1.2 nên được mô tả là lựa chọn checkpoint bốn stem công khai theo hướng SCNet, không phải gói mô hình chính thức từ bài báo SCNet.
MVSep Ensemble như một quy trình cấp nền tảng
MVSep Ensemble 2025.06.30 đại diện cho quy trình đa mô hình ở cấp nền tảng. Trang thuật toán công khai liệt kê nhiều họ mô hình. Nhánh giọng hát có thể dùng UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL và các hướng khác, trong khi bass, trống và khác có thể gọi các mô hình Demucs khác nhau hoặc mô hình liên quan.
Sức mạnh của loại ensemble này đến từ chuyên môn hóa: giao tư liệu thiên về giọng hát cho các mô hình chuyên giọng, giao tư liệu giàu tần số thấp và transient cho bộ tách nhạc cụ mạnh hơn, rồi hợp nhất kết quả. Nó có thể là tham chiếu cho trần chất lượng, nhưng không phải một checkpoint và cũng không phải mô hình độc lập mà người dùng có thể tái lập bằng cách tải một tệp duy nhất.
MVSep liệt kê ensemble 2025.06.30 ở mức SDR trung bình 13.67. Con số đó hữu ích như trần của nền tảng lưu trữ, nhưng không nên đặt cùng hàng với checkpoint độc lập. Nó phản ánh một quy trình phía máy chủ có thể kết hợp các nhánh giọng hát, nhạc cụ, bass, trống, khác và những nhánh dành riêng cho nhạc cụ bổ sung trước khi tạo kết quả cuối cùng.
Vì lý do đó, khi bàn về một mô hình bốn stem đơn lẻ có thể tải xuống, cần để ensemble nền tảng bên ngoài danh mục mô hình đơn. Nếu không, phép so sánh sẽ chuyển từ kiến trúc mô hình sang quy trình được lưu trữ.
So sánh bốn stem công khai
Bảng dưới đây dùng số liệu từ các trang mô hình và benchmark công khai được dẫn nguồn. Điểm số giúp định vị từng mô hình dưới cùng một mục tiêu bốn stem. Không nên coi chúng là phán quyết tuyệt đối cho mọi bài hát, thể loại hoặc tình huống nghe.
Phạm vi nguồn được giữ hẹp có chủ ý: hàng Huge-SCNet-4stems V1.2 với 10.02 dB đến từ tham chiếu HF / MVSep công khai; SCNet XL IHF, BS Roformer và HTDemucs4 dùng các hàng ZFTurbo / MVSep Multisong công khai. Đây không phải bảng trộn lẫn kết quả MUSDB18-HQ của bài báo SCNet, các trang giọng hát Mel-Band và điểm quy trình lưu trữ MVSep Ensemble.
Mô hình
SDR trung bình
Giọng hát
Trống
Bass
Khác
Cách diễn giải
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Checkpoint bốn stem Huge-SCNet công khai trong bảng tham chiếu được dẫn nguồn.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Ứng viên bốn stem độc lập mạnh, đặc biệt cho trống và bass.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Tham chiếu bốn stem hữu ích cho hướng RoFormer chia dải.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Baseline cổ điển đã trưởng thành, nhưng không phải trần chất lượng bốn stem hiện nay.
Cách đọc điểm số
SDR cao hơn thường có nghĩa là ít biến dạng hơn so với stem tham chiếu. Nhưng SDR trung bình không thể thay thế việc nghe và cũng không thể gom mọi stem thành một câu trả lời. Một mô hình có thể mạnh ở bass và trống trong khi mô hình khác giữ giọng hát sạch hơn. Khác đặc biệt khó vì chứa nhiều nhạc cụ.
Giá trị của Huge-SCNet-4stems V1.2 nằm ở ranh giới hiện vật rõ ràng: một tên checkpoint công khai, đầu ra bốn stem tiêu chuẩn và số liệu tham chiếu công khai có thể truy vết. SCNet XL IHF vẫn là phép so sánh quan trọng. MVSep Ensemble vẫn là tham chiếu trần chất lượng được lưu trữ. Chúng trả lời những câu hỏi khác nhau.
Người dùng nên bắt đầu từ mục tiêu. Hãy dùng tách giọng hát để có giọng sạch nhất. Dùng tách bốn stem để có giọng hát, trống, bass và khác có thể chỉnh sửa. Dùng tách sáu stem khi guitar và piano cần tệp riêng.
Ranh giới đầu ra: cân bằng bốn stem và chi tiết sáu stem
Tách sáu stem tiếp tục chia khác thành guitar, piano và phần khác còn lại. Nó nhạy hơn với cú gảy guitar, tiếng bật đầu của piano, kết cấu keyboard và họa âm tần số cao. Vì vậy, một checkpoint BS Roformer SW sáu stem đại diện cho mục tiêu và hợp đồng huấn luyện khác với Huge-SCNet-4stems V1.2.
Những tuyên bố này thuộc các tầng riêng biệt: RoFormer mô tả một họ kiến trúc, Mel-Band nhắm đến biểu diễn giọng hát, SCNet cân bằng bốn stem, còn các ensemble MVSep kết hợp thành phần được lưu trữ. Mỗi loại trả lời một câu hỏi khác nhau về kiến trúc, mục tiêu đầu ra, khả năng truy cập công khai, hình thức quy trình hoặc hợp đồng suy luận.
Kết luận: chọn kiến trúc, không chọn từ khóa thời thượng
Tách bốn stem không phải nhạc đệm được đổi tên, cũng không phải nơi áp mô hình giọng hát phổ biến nhất lên mọi nhạc cụ. Nó yêu cầu mô hình cân bằng giọng hát, trống, bass và khác, đặc biệt là transient của trống, dải trầm của bass, họa âm cao của nhạc cụ và nhóm nhạc cụ hỗn hợp bên trong khác.
Huge-SCNet-4stems V1.2 có vị trí rõ ràng quanh mục tiêu bốn stem tiêu chuẩn đó. Mel-Band RoFormer vẫn quan trọng để hiểu tách giọng hát, còn MVSep Ensemble vẫn hữu ích như tham chiếu chất lượng được lưu trữ. Mỗi loại thuộc một tầng khác nhau trong lịch sử nghiên cứu và triển khai.