Separação de áudio em quatro stems: por que Huge-SCNet combina com MSS · TelkNet
Modelo
Separação de áudio em quatro stems: por que Huge-SCNet combina com MSS
A ferramenta atual de quatro stems da TelkNet usa Huge-SCNet-4stems V1.2 para dividir um mix completo em vocais, bateria, baixo e outros. O artigo explica a escolha pela história de MSS, limites do Mel-Band RoFormer, modelagem por sub-bandas do SCNet e pontuações públicas.
Notícias de modelos / Separação de fontes musicais
Data da notícia: 2026-06-30
Modelo atual de quatro stems: Huge-SCNet-4stems V1.2
Saída padrão: vocais / bateria / baixo / outros
Tema: arquitetura MSS, limites do Mel-Band RoFormer e compromissos do SCNet
Resumo
A separação de fontes musicais por IA já superou a simples pergunta sobre a possibilidade de extrair uma voz de uma mixagem. Para remixagem, sampling, prática, Music-to-MIDI, áudio espacial e limpeza de material, a pergunta útil é se o resultado continua editável. A separação padrão em quatro stems segue esse objetivo mais rigoroso: dividir uma mixagem completa em vocais, bateria, baixo e outros, em vez de produzir apenas arquivos de voz e acompanhamento.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer e Huge-SCNet-4stems V1.2 representam abordagens distintas de separação em quatro stems. A força nos vocais, sozinha, não determina a qualidade dos quatro stems. Um ensemble de plataforma pode alcançar uma pontuação alta sem ser um modelo independente para download, enquanto um checkpoint público oferece um artefato reproduzível.
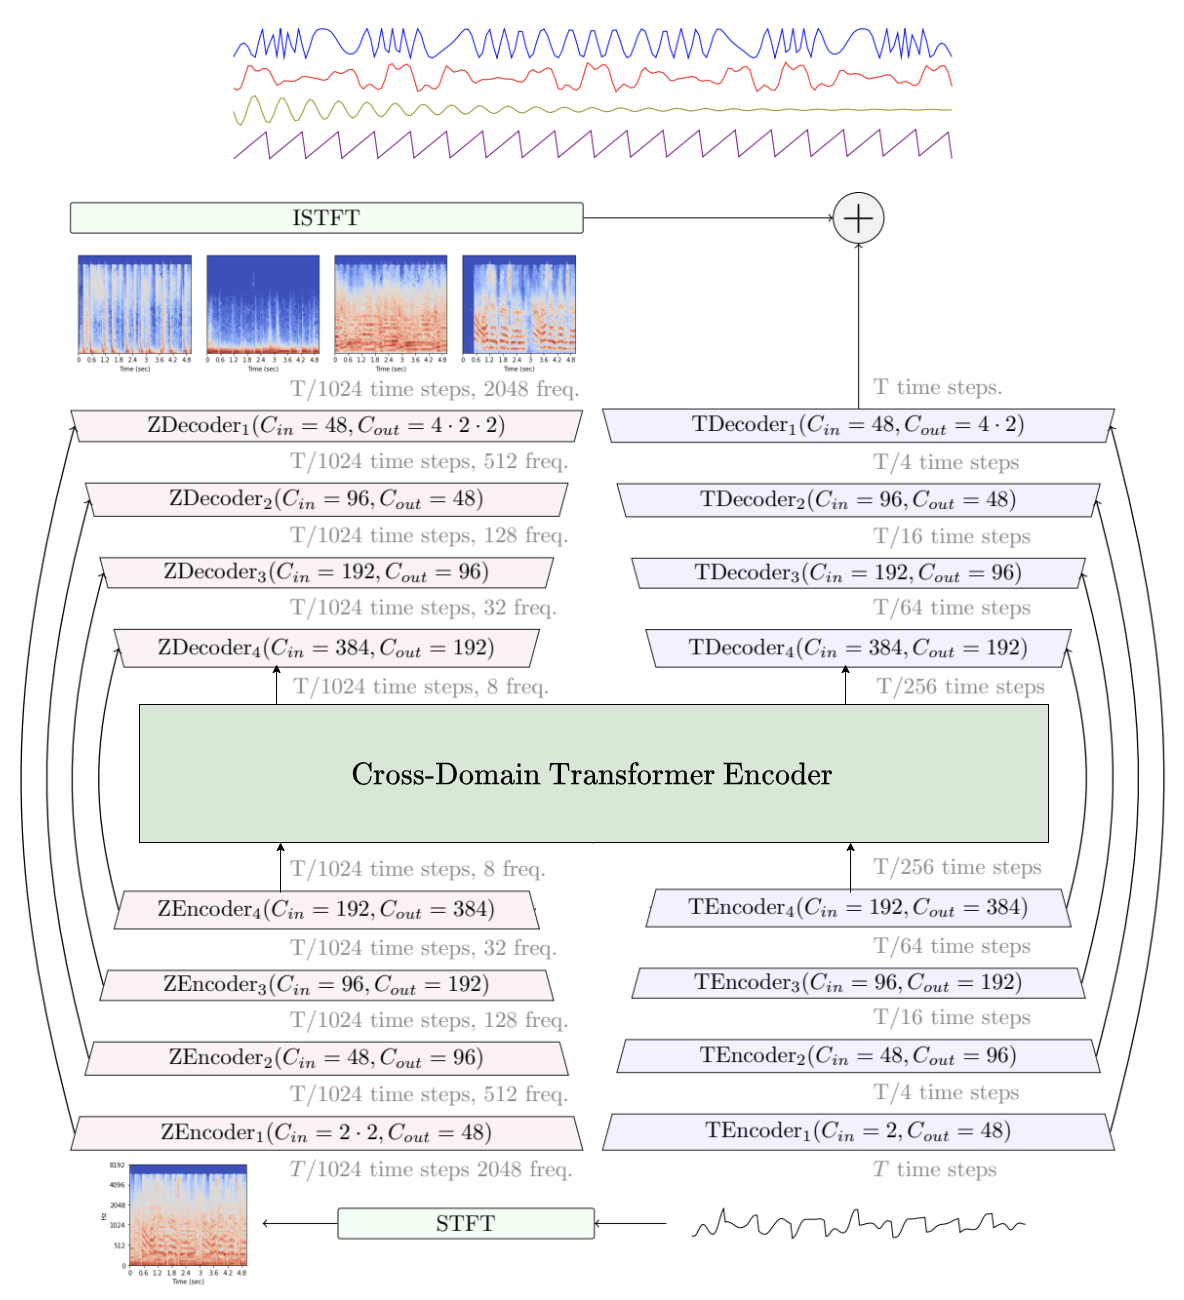
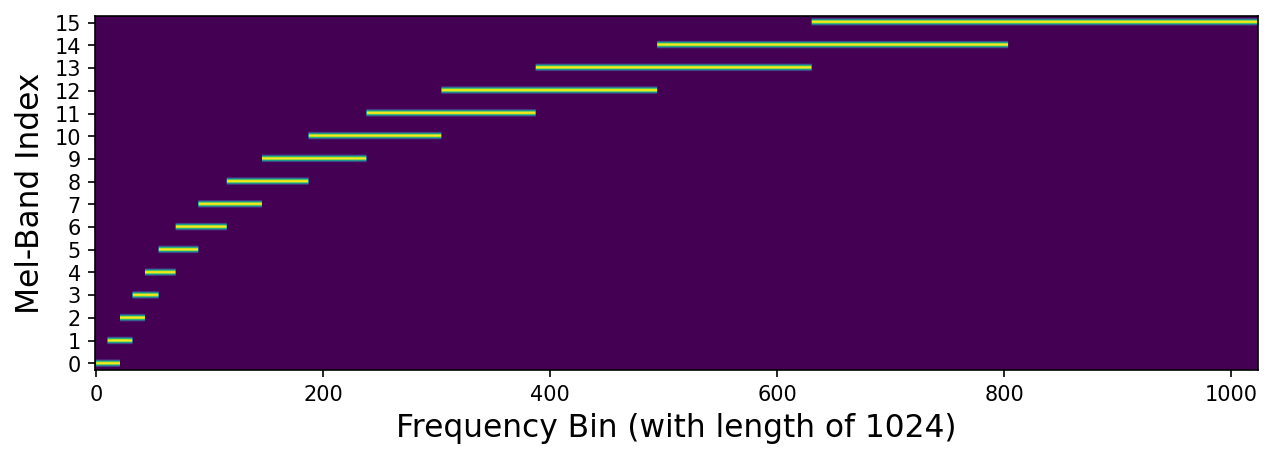
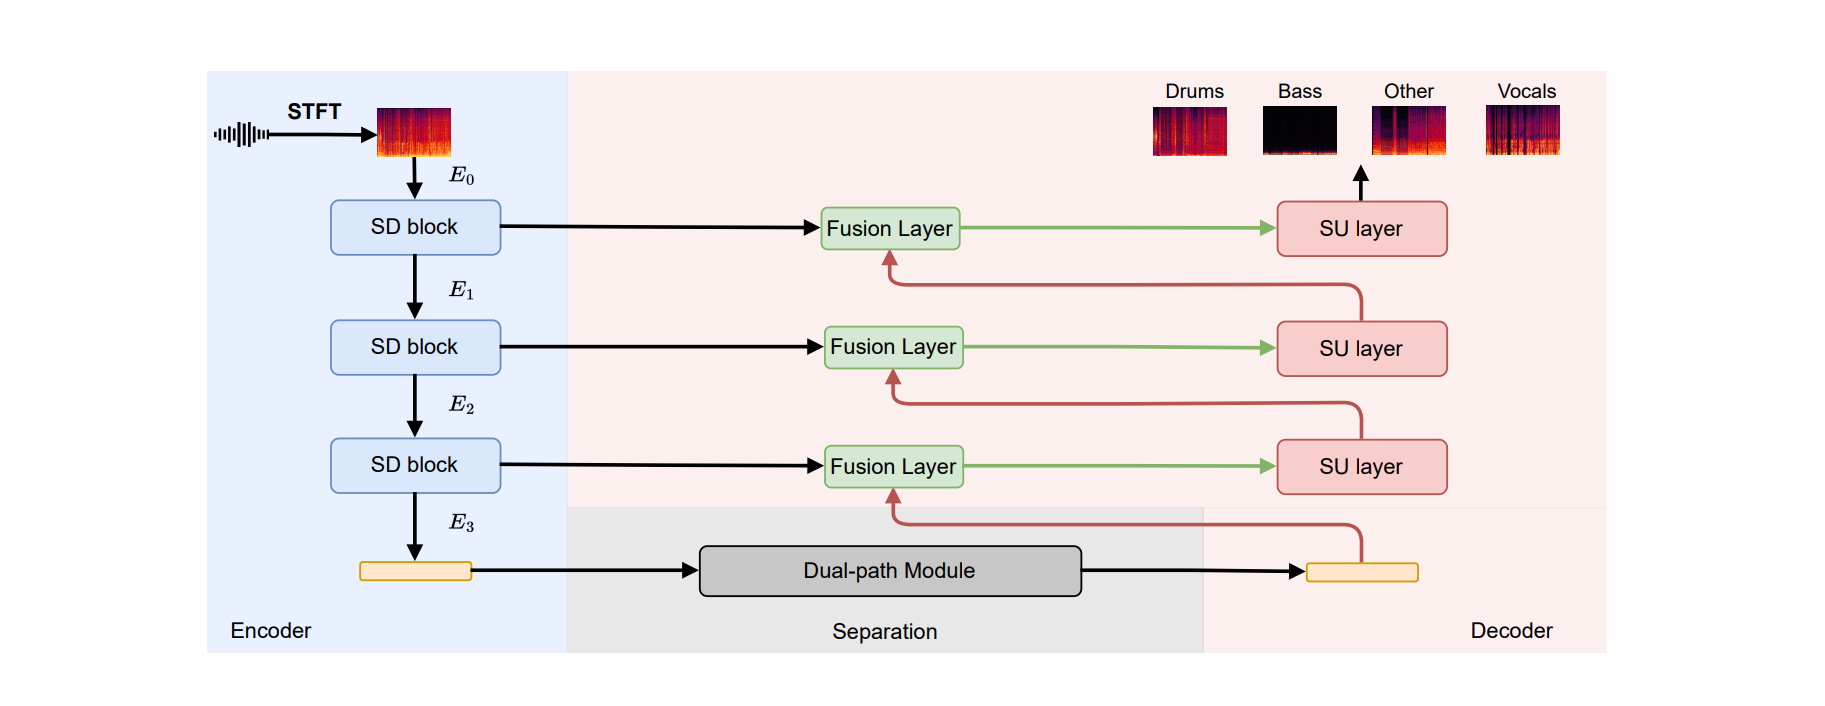
HTDemucs O diagrama de estrutura oficial do artigo: os dois ramos do domínio da forma de onda e do domínio do espectro convergem dentro do modelo. O design representativo do estágio de "domínio duplo" na linha do tempo abaixo é semelhante a este (fonte: artigo Hybrid Transformers, arXiv:2211.08553).Diagrama oficial do Mel-Band RoFormer Paper: como as caixas espectrais são mapeadas para subbandas sobrepostas organizadas em uma escala mel. As subbandas obtidas na frequência média-baixa são mais densas, portanto os detalhes vocais são expressos com mais detalhes (fonte: arXiv:2310.01809).Diagrama de arquitetura oficial do papel SCNet: A posição do módulo de compressão esparso entre o codificador e a rede de separação é clara à primeira vista - primeiro comprimindo áreas de baixa densidade de informação e depois deixando o poder de computação para limites de voz lotados (fonte: artigo SCNet, arXiv:2401.13276).
As páginas públicas de algoritmos e os rankings do MVSep são referências comuns na separação de fontes musicais. Elas documentam resultados e configurações; um fluxo de trabalho com ensemble não deve ser interpretado como um único modelo independente.
Quatro stems não são outro nome para o acompanhamento
A separação padrão em quatro stems normalmente significa vocais, bateria, baixo e outros. Vocais representam a parte cantada; bateria, o kit de bateria; baixo, a linha de baixo; e outros reúne os instrumentos restantes: guitarra, piano, cordas, sintetizadores, metais, efeitos e mais. O acompanhamento ouvido depois de silenciar os vocais é, na verdade, a soma de bateria, baixo e outros.
Esse objetivo vem dos principais conjuntos de dados e da tradição de avaliação na separação de fontes musicais. MUSDB18 e MUSDB18-HQ orientam há muito tempo o treinamento e a avaliação de modelos em torno desses quatro stems. Quando a comunidade diz 4-stem, geralmente se refere a esse tipo de saída.
A distinção muda a escolha da ferramenta. Se o objetivo é obter um vocal limpo ou um instrumental sem vocais, um separador vocal de dois stems é mais direto. Se o objetivo é praticar bateria, analisar o baixo, fazer sampling, remixar ou limpar material editável, quatro stems são mais úteis. Outros não é um acompanhamento de qualidade inferior; é o conjunto instrumental mais difícil do sistema.
Quatro etapas do U-Net ao SCNet
A separação de fontes musicais tenta recuperar várias fontes de uma única forma de onda mixada ao longo do tempo e da frequência. Modelos anteriores já conseguiam produzir resultados audíveis, mas os artefatos eram conhecidos: vazamento de voz, resíduos de bateria, baixo embolado, altas frequências borradas ou uma fase fragmentada em arranjos densos.
Período
Linha representativa
Avanço
Problema restante
2020-2021
VR Architecture / U-Net
Tratou espectrogramas como imagens e tornou prática a separação básica entre voz e acompanhamento.
Janelas de convolução locais tinham dificuldade com o contexto musical de longa duração e as relações de fase.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Combinou modelagem de forma de onda e espectrograma, melhorando a qualidade e a estabilidade da reconstrução.
Clímax densos, reverberação intensa e transientes complexos ainda podiam produzir artefatos.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Usou divisão em bandas, RoPE e modelagem tempo-frequência mais potente para vocais, harmonias, slides e sustentação.
Uma distribuição de frequências que favorece os vocais não é automaticamente a melhor para todos os instrumentos em quatro stems.
Usou modelagem por sub-bandas e compressão esparsa para se concentrar em regiões de tempo-frequência ricas em informação.
O objetivo continua sendo a separação padrão em quatro stems, não uma saída de seis stems nem um ensemble de plataforma.
Essa evolução explica por que a seleção de modelos não pode ser reduzida à qualidade vocal. A separação em quatro stems também precisa preservar os transientes da bateria, as frequências fundamentais e os harmônicos do baixo, os limites dos vocais e os detalhes de alta frequência presentes em outros.
A cronologia também é delimitada pelas fontes: o artigo do SCNet tornou-se público em janeiro de 2024, enquanto o Huge-SCNet-4stems V1.2 pertence ao contexto posterior de checkpoints públicos. Por isso, esta linha do tempo usa 2024-2026, em vez de sugerir que o próprio SCNet só apareceu depois de 2025.
Mel-Band RoFormer: força nos vocais e limites dos quatro stems
O Mel-Band RoFormer foi proposto pela equipe Speech, Audio, and Music Intelligence (SAMI) da ByteDance. Os autores do artigo são Ju-Chiang Wang, Wei-Tsung Lu e Minz Won, com a afiliação da página de título registrada como SAMI, ByteDance. Algumas páginas da comunidade resumem essa linha como ByteDance AI Labs, mas a formulação mais precisa da fonte é a dos autores do artigo e SAMI, ByteDance.
O modelo chama atenção porque organiza as bandas de frequência de forma mais próxima à audição humana. O ouvido é mais sensível às frequências baixas e médias, onde estão as fundamentais vocais, as consoantes, a respiração e muitas pistas de altura. A projeção mel-band oferece uma representação mais fina desse intervalo, ajudando o modelo a acompanhar vozes principais, backing vocals, slides, vibrato e caudas de reverberação.
A família RoFormer usa codificação posicional rotativa, ou RoPE, tanto nas sequências temporais quanto nas sequências de sub-bandas. Isso faz com que as pontuações de atenção dependam da posição relativa. Slides, notas sustentadas e frases repetidas oferecem intuições estruturais úteis para essa propriedade, mas o artigo testa diretamente apenas modelos controlados com RoPE contra modelos sem RoPE; ele não apresenta métricas separadas para slides ou harmonias longas.
Caminho do sinal definido no artigo
O BS-RoFormer primeiro converte a forma de onda da mixagem em um espectrograma complexo. Sua projeção em bandas e seu Transformer hierárquico estimam uma máscara complexa; essa máscara é aplicada ao espectro da mixagem, e a STFT inversa reconstrói a forma de onda alvo. O Mel-RoFormer altera a projeção dentro de fθ: bandas mel sobrepostas substituem a divisão heurística sem sobreposição. Ele não substitui todo o caminho de reconstrução.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: o espectrograma complexo da mixagem, incluindo os componentes real e imaginário.
fθ: projeção em bandas, Transformers intra/interbanda e estimativa de máscara.
M̂: a máscara complexa do alvo usada para recuperar magnitude e fase.
ŷ: a forma de onda reconstruída pela STFT inversa e restringida por perdas de forma de onda e espectrais durante o treinamento.
É por isso que o Mel-Band RoFormer é uma linha forte para separar voz e acompanhamento, voz principal e backing vocals, e para extrair vocais limpos. O problema é que a separação em quatro stems não trata apenas de vocais. Ela também precisa separar bateria, baixo e outros, e esta última categoria costuma conter os detalhes instrumentais de alta frequência mais difíceis.
Depois dos artigos: como o RoFormer se tornou um ecossistema de ferramentas abertas
O BS-RoFormer surgiu em setembro de 2023 com dois tipos de evidência em um único artigo. O sistema L=12 maior, treinado com MUSDB18HQ e mais 500 músicas internas, documentou a participação da SAMI-ByteDance que ficou em primeiro lugar no SDX23. Modelos menores, treinados apenas com MUSDB18HQ, forneceram ablações controladas de RoPE, divisão em bandas e reconstrução por sobreposição e média. O artigo publicou a arquitetura, as condições de treinamento e as tabelas de resultados. Ele não anexou o checkpoint original do SDX23 nem indicou um repositório de treinamento e inferência da ByteDance/SAMI.
O Mel-Band RoFormer veio em seguida, em outubro de 2023. Ele manteve os Transformers com RoPE, a modelagem de sequências intra/interbanda, as máscaras complexas e a reconstrução da forma de onda, mas substituiu a divisão manual sem sobreposição por 60 bandas mel sobrepostas. O intervalo de um mês é importante: tratava-se de uma revisão pública da projeção de frequência motivada pela limitação do próprio artigo anterior, não de um segundo pacote oficial de checkpoint lançado junto com o texto.
O código executável se acumulou fora dos artigos. O repositório de lucidrains transformou os diagramas e as equações em classes de modelos PyTorch e convidou abertamente outras pessoas a reproduzir o separador. O suporte a estéreo, vários stems de saída e a variante Mel-Band tornaram a estrutura reutilizável, mas o código sozinho não conseguia reconstruir as músicas internas, o estado do otimizador, a duração do treinamento nem os parâmetros finais da competição.
O Music-Source-Separation-Training deu então a essa estrutura reutilizável uma oficina comum: carregadores de conjuntos de dados, aumento de dados, treinamento, validação, retomada de checkpoint, inferência em blocos, sobreposição e combinação de modelos. Seu README credita a lucidrains a recriação dos modelos RoFormer a partir dos artigos e aceita envios de modelos da comunidade. Uma mesma arquitetura passou a poder ser treinada para separar voz e instrumental, quatro stems, substems de bateria ou outros alvos especializados. Não havia um único conjunto canônico de pesos da comunidade.
O modelo vocal de Kimberley Jensen tornou o processo concreto. O repositório informa que ele foi treinado com mais dados usando o código de ZFTurbo, usa por padrão um bloco de oito segundos e expõe num_overlap para reduzir artefatos de emenda ao custo de uma inferência mais demorada. Também credita quem contribuiu para o conjunto de dados. Esses detalhes explicam por que um checkpoint para download possui características que o nome de uma arquitetura, sozinho, não consegue descrever.
A página atual do MVSep atribui os primeiros pesos públicos de alta qualidade a Kimberley Jensen e depois descreve modificações posteriores e a continuação do treinamento dos pesos abertos. Bas Curtiz, unwa, becruily, gabox e outras edições aparecem na mesma página com diferentes compromissos entre corpo, vazamento, ruído e SDR. Esta é uma genealogia de pesos ramificada: os modelos compartilham o Mel-Band RoFormer, mas não seus dados, seu objetivo, seu histórico de ajuste fino nem seu som final.
Síntese baseada nos dois artigos do RoFormer, na implementação de lucidrains e no ambiente de treinamento ZFTurbo/MVSep. As setas mostram dependência de implementação, não endosso oficial.
Nome ou artefato
O que identifica
O que ainda exige comprovação de origem
BS-RoFormer / Mel-Band RoFormer
Projeto de projeção em bandas, RoPE e modelagem de sequência axial.
Quem treinou o checkpoint concreto, os dados, os stems-alvo e o conjunto de avaliação.
Um arquivo de checkpoint para download
Um conjunto de parâmetros que normalmente depende de uma configuração correspondente.
Se veio dos autores do artigo, de treinamento da comunidade ou de ajuste fino posterior.
Um fluxo Mel-Band / BS-RoFormer hospedado
O serviço selecionou pesos, divisão em blocos, sobreposição e saídas.
Pontuações do fluxo hospedado não podem ser renomeadas como resultados do SDX23 ou do artigo original.
Um mesmo nome de arquitetura pode agora se referir a um sistema de competição, uma ablação de artigo, um checkpoint vocal, um checkpoint de quatro stems ou um ensemble de plataforma. Um texto preciso precisa expor três pontos: quem propôs a arquitetura, de onde vieram os pesos atuais e qual configuração de inferência entrega o resultado. Sem os três, expressões como “modelo oficial da ByteDance” ou “pontuação de competição do Mel-Band em quatro stems” juntam discretamente artefatos diferentes de momentos distintos dessa história.
Comparação controlada: Mel não substitui BS em todos os stems
A evidência mais limpa é a comparação controlada do artigo Mel-Band de 2023, e não uma mistura de páginas do MVSep com checkpoints comunitários sem relação entre si. Todas as linhas abaixo usam MUSDB18HQ sem músicas extras. Dentro de cada profundidade, a principal mudança está na projeção: as bandas heurísticas e não sobrepostas do BS-RoFormer são substituídas por 60 bandas mel sobrepostas.
O resultado é uma troca de vantagens, não uma vitória completa. Em L=6, vocais sobem de 10.78 para 11.21 dB e bateria de 9.61 para 9.91 dB, enquanto baixo cai de 11.43 para 9.64 dB e outros recua de 7.86 para 7.81 dB. Em L=9, vocais ganha 0.58 dB e outros ganha 0.13 dB, bateria perde 0.32 dB, e o baixo não é informado porque o treinamento avançou devagar demais.
Modelo do artigo (MUSDB18HQ, sem dados extras)
Vocais
Baixo
Bateria
Outros
SDR médio
Parâmetros
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
não informado
9.34
7.93
não informado
94.8M
O artigo relaciona o resultado do baixo ao mapeamento de frequências. O BS-RoFormer reserva deliberadamente bandas estreitas para as baixas frequências, enquanto a projeção mel ajuda mais os vocais e alguns alvos que não são baixo. A conclusão de engenharia útil, portanto, depende da tarefa: a projeção mel é uma escolha forte para vocais, mas a motivação psicoacústica por si só não comprova domínio na separação em quatro stems.
SCNet e o objetivo de quatro stems
A SCNet adota uma visão do espectro mais orientada pela informação. Entre os autores do artigo estão Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu e Helen Meng; a página de título lista Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab e The Chinese University of Hong Kong entre as afiliações. Em termos de arquitetura, a SCNet divide explicitamente o espectrograma da mistura em sub-bandas e usa compressão esparsa para lidar com as diferentes densidades de informação dessas bandas. Em termos mais simples, ela não concentra quase toda a capacidade na faixa vocal. O modelo é levado a se concentrar nas regiões de tempo-frequência que realmente carregam sinal instrumental útil.
Isso importa para quatro stems. O baixo ocupa frequências baixas, mas carrega harmônicos importantes. A bateria combina transientes muito curtos com pratos e ambiência. Outros pode conter guitarra, piano, cordas, sintetizadores e efeitos ao mesmo tempo. A modelagem por sub-bandas permite tratar de forma mais direcionada diferentes regiões de frequência, enquanto a compressão esparsa afasta a atenção de regiões vazias ou com pouca informação.
O artigo da SCNet descreve o sistema completo como um codificador de áudio, uma rede de separação baseada em RNN de caminho duplo e um decodificador de áudio. O codificador mapeia a mistura para representações de sub-bandas no domínio da frequência, a rede de separação modela a estrutura ao longo do tempo e da frequência, e o decodificador reconstrói os stems-alvo.
Huge-SCNet-4stems V1.2 pertence a essa linha. Seu contrato de saída é um conjunto equilibrado de arquivos de vocais, bateria, baixo e outros que pode seguir para remixagem ou transcrição, e não um objetivo de otimização exclusivo para vocais.
Também é importante separar o artigo da SCNet do checkpoint Huge-SCNet-4stems V1.2. O artigo apresenta a arquitetura de compressão esparsa, o projeto de sub-bandas e o resultado de pesquisa no MUSDB18-HQ; o artefato para download é o checkpoint público do Hugging Face huge_scnet_4stems_v1.2.ckpt. Esse checkpoint comunitário não pode herdar o resultado de 9.0 dB do artigo no MUSDB18-HQ, porque os dados e a procedência da versão são diferentes.
A fronteira do código também deve permanecer separada. Os autores do artigo publicam thuhcsi/SCNet como repositório oficial da implementação, mas o repositório informa que o código de treinamento ainda precisa ser concluído e encaminha os leitores a HTDemucs, Music-Source-Separation-Training e SCNet-PyTorch como frameworks provisórios de treinamento. Portanto, Huge-SCNet-4stems V1.2 deve ser descrito como uma opção pública de checkpoint de quatro stems na linha da SCNet, e não como o pacote de modelo oficial do artigo da SCNet.
MVSep Ensemble como fluxo de plataforma
MVSep Ensemble 2025.06.30 representa um fluxo multimodelo no nível da plataforma. A página pública do algoritmo lista mais de uma família de modelos. O caminho de vocais pode usar UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL e outras rotas, enquanto baixo, bateria e outros podem acionar modelos Demucs diferentes ou relacionados.
A força desse tipo de ensemble vem da especialização: encaminhar material com forte presença vocal a especialistas em vocais, material rico em baixas frequências e transientes a separadores instrumentais mais fortes e, depois, combinar os resultados. Ele pode servir como referência do teto de qualidade, mas não é um único checkpoint nem um modelo independente que o usuário possa reproduzir baixando um só arquivo.
O MVSep atribui SDR médio de 13.67 ao ensemble 2025.06.30. Esse número é útil como teto de uma plataforma hospedada, mas não deve aparecer na mesma linha de um checkpoint independente. Ele representa um fluxo no servidor capaz de combinar caminhos de vocais, instrumental, baixo, bateria, outros e instrumentos específicos adicionais antes de produzir o resultado final.
Por isso, a discussão sobre um único modelo de quatro stems disponível para download precisa manter os ensembles de plataforma fora da categoria de modelo único. Caso contrário, a comparação deixa de ser entre arquiteturas de modelo e passa a ser entre fluxos hospedados.
Comparação pública de quatro stems
A tabela abaixo usa números das páginas públicas citadas de modelos e benchmarks. As pontuações ajudam a situar cada modelo sob o mesmo objetivo de quatro stems. Elas não devem ser lidas como um veredito absoluto para toda música, gênero ou situação de audição.
O escopo das fontes é intencionalmente restrito: a linha do Huge-SCNet-4stems V1.2 com 10.02 dB vem da referência pública HF / MVSep; SCNet XL IHF, BS Roformer e HTDemucs4 usam linhas públicas ZFTurbo / MVSep Multisong. Esta não é uma tabela que mistura resultados do artigo da SCNet no MUSDB18-HQ, páginas vocais do Mel-Band e pontuações do fluxo hospedado MVSep Ensemble.
Modelo
SDR médio
Vocais
Bateria
Baixo
Outros
Como interpretar
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Checkpoint público Huge-SCNet de quatro stems na tabela de referência citada.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Forte candidato independente de quatro stems, sobretudo para bateria e baixo.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Referência útil de quatro stems para a linha do RoFormer com divisão em bandas.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Baseline clássico e maduro, mas não o teto da qualidade atual em quatro stems.
Como interpretar as pontuações
SDR mais alto normalmente significa menos distorção em relação ao stem de referência. Porém, o SDR médio não substitui a audição nem reduz todos os stems a uma única resposta. Um modelo pode ser forte em baixo e bateria, enquanto outro mantém os vocais mais limpos. Outros é especialmente difícil porque reúne muitos instrumentos.
O valor do Huge-SCNet-4stems V1.2 está na clareza da fronteira do artefato: um nome público de checkpoint, saída padrão de quatro stems e números públicos de referência rastreáveis. SCNet XL IHF continua sendo uma comparação importante. MVSep Ensemble continua sendo uma referência hospedada do teto de qualidade. Eles respondem a perguntas diferentes.
O usuário deve começar pelo objetivo. Use separação vocal para obter o vocal mais limpo. Use separação em quatro stems para obter vocais, bateria, baixo e outros editáveis. Use separação em seis stems quando guitarra e piano precisarem de arquivos próprios.
Fronteira da saída: equilíbrio de quatro stems versus detalhe de seis stems
A separação em seis stems subdivide outros em guitarra, piano e os instrumentos restantes. Ela é mais sensível a batidas de guitarra, ataques de piano, textura de teclados e harmônicos de alta frequência. Um checkpoint BS Roformer SW de seis stems, portanto, representa um objetivo e um contrato de treinamento diferentes dos do Huge-SCNet-4stems V1.2.
Essas afirmações pertencem a camadas distintas: RoFormer descreve uma família de arquiteturas, Mel-Band visa à representação vocal, SCNet equilibra quatro stems e os ensembles do MVSep combinam componentes hospedados. Cada uma responde a uma pergunta diferente sobre arquitetura, objetivo de saída, disponibilidade pública, forma do fluxo ou contrato de inferência.
Conclusão: escolha a arquitetura, não o termo da moda
A separação em quatro stems não é uma faixa de acompanhamento rebatizada nem um lugar para aplicar o modelo vocal mais popular a todos os instrumentos. Ela exige que o modelo equilibre vocais, bateria, baixo e outros, sobretudo transientes de bateria, frequências graves do baixo, harmônicos instrumentais altos e o conjunto misto de instrumentos dentro de outros.
Huge-SCNet-4stems V1.2 ocupa uma posição clara em torno desse objetivo padrão de quatro stems. Mel-Band RoFormer continua importante para compreender a separação vocal, enquanto MVSep Ensemble continua útil como referência hospedada de qualidade. Cada um pertence a uma camada diferente da história da pesquisa e da implantação.