Fire-stem lydseparation: hvorfor Huge-SCNet passer til MSS-målet · TelkNet
Modelvalg
Fire-stem lydseparation: hvorfor Huge-SCNet passer til MSS-målet
TelkNets aktuelle fire-stem-værktøj bruger Huge-SCNet-4stems V1.2 til at dele et helt mix i vokal, trommer, bas og andet. Artiklen forklarer valget gennem MSS-arkitektur, Mel-Band RoFormer-styrker og begrænsninger, SCNet-subbandmodellering og offentlige fire-stem-tal.
Modelnyt / Separation af musikkilder
Nyhedsdato: 2026-06-30
Nuværende model til fire stems: Huge-SCNet-4stems V1.2
AI-baseret separation af musikkilder er kommet videre end det enkle spørgsmål om, hvorvidt en vokal kan trækkes ud af et miks. Til remix, sampling, øvning, Music-to-MIDI, rumlig lyd og oprydning i materiale er det nyttige spørgsmål, om resultatet fortsat kan redigeres. Standardseparation i fire stems følger dette strengere mål: Et komplet miks opdeles i vocals, drums, bass og other i stedet for blot at levere filer med vokal og akkompagnement.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer og Huge-SCNet-4stems V1.2 repræsenterer forskellige tilgange til fire stems. Vokalstyrke alene afgør ikke kvaliteten af en separation i fire stems. Et platformsensemble kan opnå en høj score uden at være en selvstændig model, der kan downloades, mens et offentligt checkpoint udgør et reproducerbart artefakt.
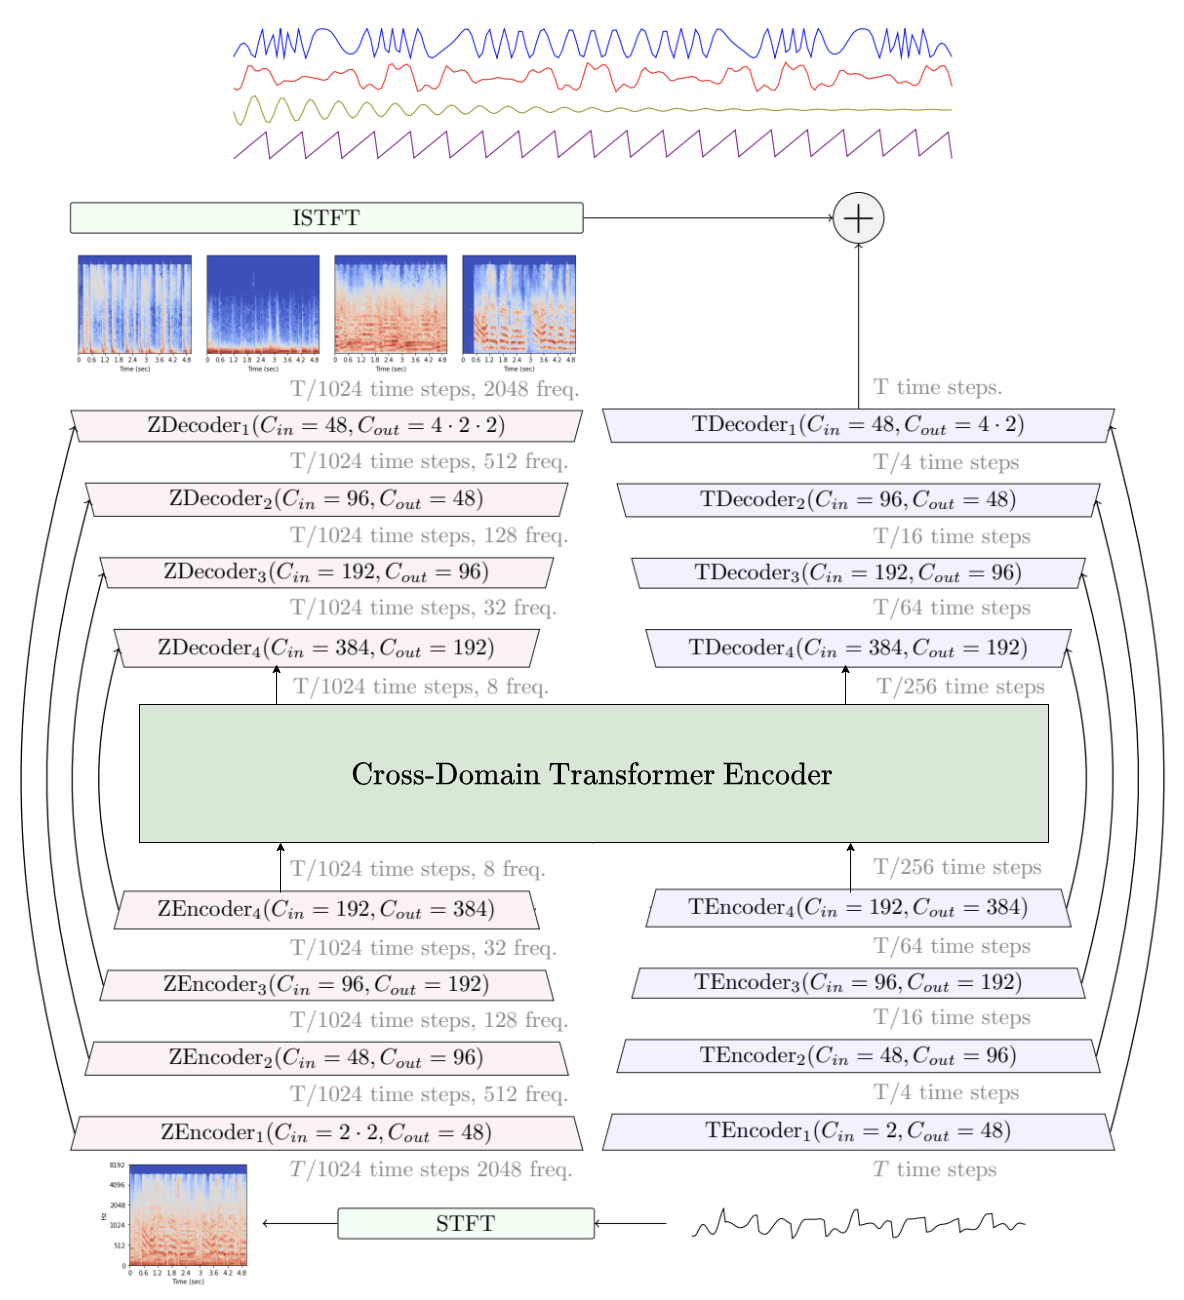
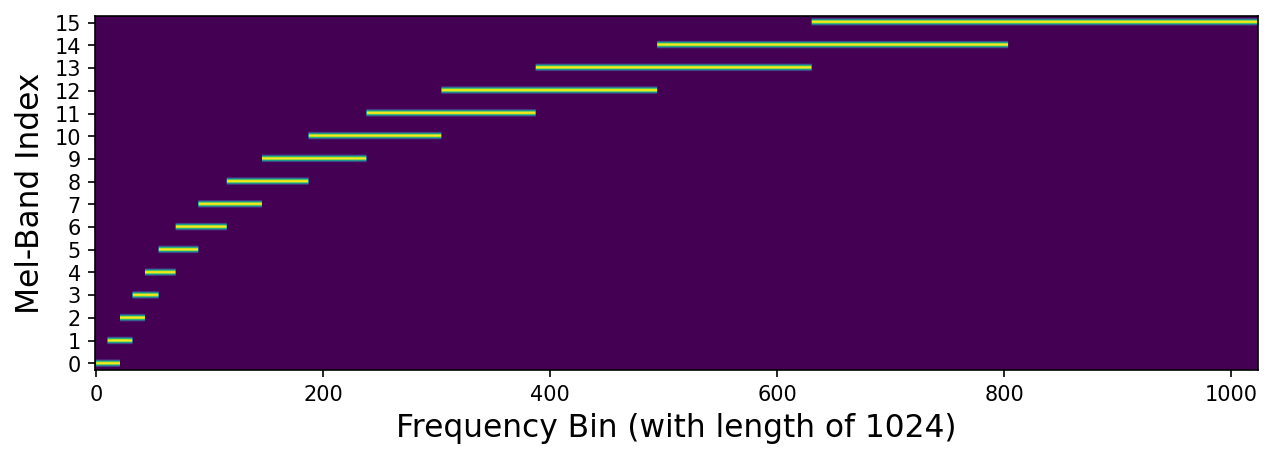
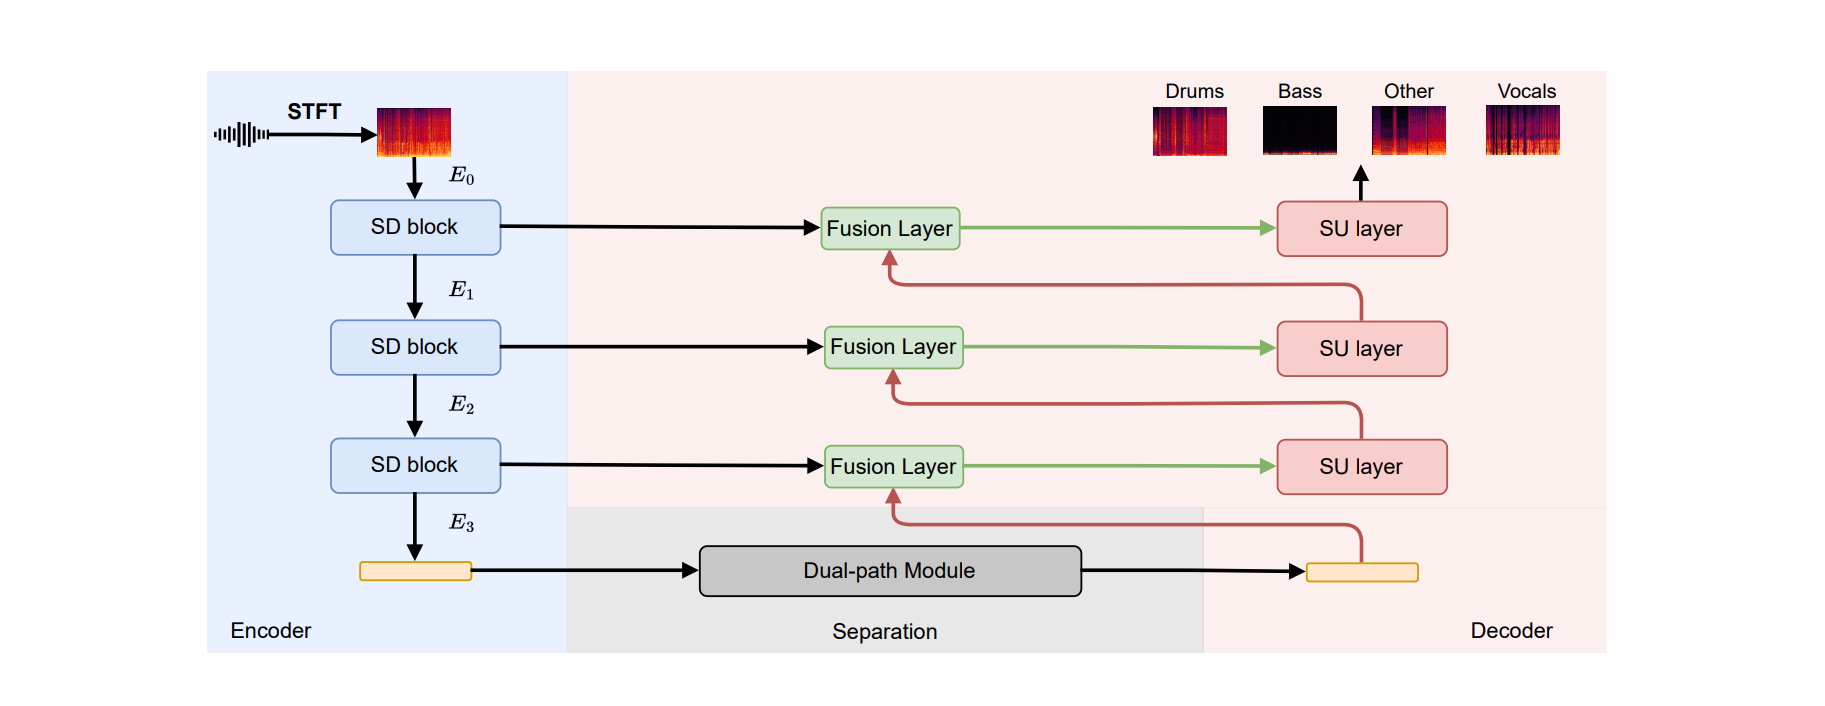
HTDemucs Det officielle strukturdiagram af papiret: de to grene af bølgeformsdomænet og spektrumdomænet konvergerer inde i modellen. Det repræsentative design af "dual domain"-stadiet i tidslinjen nedenfor ser sådan ud (kilde: Hybrid Transformers paper, arXiv:2211.08553).Mel-Band RoFormer Paper officielt diagram: hvordan spektrale bins er kortlagt til overlappende underbånd organiseret på en mel-skala. Underbåndene opnået i den mellem-lave frekvens er tættere, så vokaldetaljerne er udtrykt i finere detaljer (kilde: arXiv:2310.01809).SCNet papir officielt arkitekturdiagram: Placeringen af det sparsomme kompressionsmodul mellem indkoderen og separationsnetværket er klar med et øjeblik - først komprimerer områder med lav informationstæthed og overlader derefter computerkraften til overfyldte stemmegrænser (kilde: SCNet-papir, arXiv:2401.13276).
MVSep's offentlige algoritmesider og ranglister er almindelige referencepunkter inden for separation af musikkilder. De dokumenterer resultater og konfigurationer; en ensemblearbejdsgang bør ikke opfattes som én selvstændig model.
Fire stems er ikke et andet navn for akkompagnementsspor
Standardseparation i fire stems betyder som regel vocals, drums, bass og other. Vocals er sangsporet, drums er trommesættet, bass er basstemmen, og other rummer de resterende instrumenter: guitar, klaver, strygere, synthesizere, blæsere, effekter og mere. Det akkompagnementsspor, man hører efter at have slået vokalen fra, er i virkeligheden summen af drums, bass og other.
Dette mål stammer fra de vigtigste datasæt og evalueringstraditionen inden for separation af musikkilder. MUSDB18 og MUSDB18-HQ har længe formet modeltræning og evaluering omkring disse fire stems. Når miljøet siger 4-stem, betyder det som regel dette outputmål.
Forskellen ændrer valget af værktøj. Hvis målet er en ren vokal eller en instrumentalversion uden vokal, er en vokalseparator med to stems den mest direkte løsning. Hvis målet er trommeøvning, basanalyse, sampling, remix eller redigerbar oprydning i materiale, er fire stems mere nyttige. Other er ikke et dårligere akkompagnementsspor; det er systemets vanskeligste samling af instrumenter.
Fire faser fra U-Net til SCNet
Separation af musikkilder forsøger at genskabe flere kilder fra én blandet bølgeform på tværs af tid og frekvens. Tidligere modeller kunne levere brugbare resultater, men artefakterne var velkendte: vokallækage, trommeoverhør, mudret bas, udtværede høje frekvenser eller en sønderrevet fasekarakter i tætte arrangementer.
Periode
Repræsentativ retning
Fremskridt
Resterende problem
2020-2021
VR Architecture / U-Net
Behandlede spektrogrammer som billeder og gjorde grundlæggende separation af vokal og akkompagnement praktisk anvendelig.
Lokale konvolutionsvinduer havde vanskeligt ved lang musikalsk kontekst og faseforhold.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Kombinerede modellering af bølgeform og spektrogram og forbedrede rekonstruktionskvalitet og stabilitet.
Tætte klimakser, kraftig rumklang og komplekse transienter kunne stadig give artefakter.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Brugte båndopdeling, RoPE og stærkere tids-frekvensmodellering til vokaler, harmonier, glid og udholdte toner.
En frekvensfordeling, der favoriserer vokaler, er ikke automatisk bedst for alle instrumenter i fire stems.
Brugte delbåndsmodellering og sparsom komprimering til at fokusere på informationsrige tids-frekvensområder.
Målet er fortsat standardseparation i fire stems, ikke output i seks stems eller et platformsensemble.
Denne udvikling forklarer, hvorfor modelvalg ikke kan reduceres til vokalkvalitet. Separation i fire stems skal også bevare trommetransienter, bassens grundtoner og overtoner, vokalgrænser og detaljerne i de høje frekvenser i other.
Tidsangivelserne er også afgrænset af kilderne: SCNet-artiklen blev offentliggjort i januar 2024, mens Huge-SCNet-4stems V1.2 hører til den senere kontekst med offentlige checkpoints. Derfor bruger tidslinjen 2024-2026 i stedet for at antyde, at SCNet selv først dukkede op efter 2025.
Mel-Band RoFormer: Stærk vokal og begrænsninger ved fire stems
Mel-Band RoFormer blev foreslået af ByteDance's team for Speech, Audio, and Music Intelligence (SAMI). Artiklens forfattere er Ju-Chiang Wang, Wei-Tsung Lu og Minz Won, og tilhørsforholdet på titelsiden er angivet som SAMI, ByteDance. Miljøets sider sammenfatter undertiden retningen som ByteDance AI Labs, men den mest præcise formulering fra kilden er artiklens forfattere og SAMI, ByteDance.
Modellen er attraktiv, fordi den former frekvensbåndene tættere på den menneskelige hørelse. Øret er mere følsomt over for lave og mellemste frekvenser, hvor vokalens grundtoner, konsonanter, vejrtrækning og mange tonehøjdesignaler findes. Mel-båndprojektion giver dette område en finere repræsentation og hjælper modellen med at følge leadvokal, korstemmer, glid, vibrato og rumklangens udløb.
RoFormer-familien bruger roterende positionskodning, eller RoPE, på både tids- og delbåndssekvenserne. Det får attention-scorer til at afhænge af den relative position. Glid, udholdte toner og gentagne fraser er nyttige strukturelle billeder på denne egenskab, men artiklen tester direkte kun kontrollerede modeller med og uden RoPE; den rapporterer ikke særskilte mål for glid eller lange harmonier.
Signalvejen defineret i artiklen
BS-RoFormer konverterer først den blandede bølgeform til et komplekst spektrogram. Dens båndprojektion og hierarkiske Transformer estimerer en kompleks maske, masken anvendes på blandingens spektrum, og invers STFT rekonstruerer målbølgeformen. Mel-RoFormer ændrer projektionen inde i fθ: overlappende mel-bånd erstatter den heuristiske, ikke-overlappende opdeling. Den erstatter ikke hele rekonstruktionsvejen.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: blandingens komplekse spektrogram inklusive reelle og imaginære komponenter.
fθ: båndprojektion, Transformer-modeller inden for og mellem bånd samt maskeestimering.
M̂: den komplekse målmaske, der bruges til at genskabe magnitude og fase.
ŷ: bølgeformen, der rekonstrueres med invers STFT og begrænses af bølgeforms- og spektraltab under træning.
Derfor er Mel-Band RoFormer en stærk retning til vokal/akkompagnement, leadvokal/korstemmer og udtræk af ren vokal. Problemet er, at separation i fire stems ikke kun handler om vokaler. Den skal også adskille drums, bass og other, og other rummer ofte de vanskeligste instrumentdetaljer i de høje frekvenser.
Efter artiklerne: Sådan blev RoFormer et åbent økosystem af værktøjer
BS-RoFormer udkom i september 2023 med to slags dokumentation i én artikel. Det større L=12-system, der var trænet på MUSDB18HQ samt 500 interne sange, dokumenterede SAMI-ByteDance's førstepladsbidrag til SDX23. Mindre modeller, der kun brugte MUSDB18HQ, leverede kontrollerede ablationer for RoPE, båndopdeling og rekonstruktion med overlap-and-average. Artiklen offentliggjorde arkitektur, træningsbetingelser og resultattabeller. Den vedlagde ikke det oprindelige SDX23-checkpoint og linkede ikke til et trænings- og inferensrepository fra ByteDance/SAMI.
Mel-Band RoFormer fulgte i oktober 2023. Den beholdt RoPE Transformers, sekvensmodellering inden for og mellem bånd, komplekse masker og bølgeformsrekonstruktion, men erstattede den hånddesignede, ikke-overlappende opdeling med 60 overlappende mel-bånd. Intervallet på en måned er vigtigt: Det var en offentlig revision af frekvensprojektionen, foranlediget af begrænsningen i den tidligere artikel, ikke endnu en officiel checkpointpakke udgivet sammen med teksten.
Eksekverbar kode samlede sig uden for artiklerne. lucidrains-repositoriet omsatte diagrammer og ligninger til PyTorch-modelklasser og opfordrede åbent andre til at reproducere separatoren. Stereohåndtering, flere outputstems og Mel-Band-varianten gjorde strukturen genanvendelig, men kode alene kunne ikke genskabe de interne sange, optimeringstilstanden, træningsvarigheden eller de endelige konkurrenceparametre.
Music-Source-Separation-Training gav derefter den genanvendelige struktur et fælles værksted: datasætindlæsere, augmentation, træning, validering, genoptagelse fra checkpoint, opdelt inferens, overlap og ensembling. Dets README krediterer lucidrains for at genskabe RoFormer-modellerne fra artiklerne og modtager modelbidrag fra miljøet. Én arkitektur kunne nu trænes til separation af vokal/instrumental, fire stems, trommeunderstems eller andre specialiserede mål. Der fandtes ikke én kanonisk vægt fra miljøet.
Kimberley Jensens vokalmodel gjorde processen konkret. Repositoriet oplyser, at den blev trænet på flere data med ZFTurbo's kode, bruger et otte sekunder langt segment som standard og stiller num_overlap til rådighed for at reducere samlingsartefakter på bekostning af længere inferens. Det krediterer også bidragydere til datasættet. Disse detaljer forklarer, hvorfor et checkpoint, der kan downloades, har en karakter, som et arkitekturnavn alene ikke kan beskrive.
Den nuværende MVSep-side tilskriver Kimberley Jensen de første offentlige vægte af høj kvalitet og beskriver derefter senere ændring og fortsat træning af de åbne vægte. Udgaver fra Bas Curtiz, unwa, becruily, gabox og andre optræder på samme side med forskellige afvejninger mellem fylde, overhør, støj og SDR. Det er en forgrenet vægtgenealogi: Modellerne deler Mel-Band RoFormer, men ikke deres data, målfunktion, finjusteringshistorik eller endelige lyd.
Sammenfatning baseret på de to RoFormer-artikler, lucidrains' implementering og ZFTurbo/MVSep-træningsrammen. Pilene viser implementeringsafhængighed, ikke officiel godkendelse.
Navn eller artefakt
Hvad det identificerer
Hvad der stadig kræver dokumenteret oprindelse
BS-RoFormer / Mel-Band RoFormer
Design med båndprojektion, RoPE og aksial sekvensmodellering.
Træneren, dataene, målstems og evalueringssættet for det konkrete checkpoint.
En checkpointfil, der kan downloades
Ét parametersæt, som normalt afhænger af en tilsvarende konfiguration.
Om det kommer fra artiklens forfattere, træning i miljøet eller senere finjustering.
En hostet Mel-Band / BS-RoFormer-arbejdsgang
Tjenesten har valgt vægte, segmentering, overlap og output.
Scorer fra hostede arbejdsgange kan ikke omdøbes til SDX23-resultater eller resultater fra den oprindelige artikel.
Ét arkitekturnavn kan nu henvise til et konkurrencesystem, en ablation i en artikel, et vokalcheckpoint, et checkpoint til fire stems eller et platformsensemble. Præcis tekst skal synliggøre tre ting: hvem der foreslog arkitekturen, hvor de nuværende vægte kom fra, og hvilken inferensopskrift der leverer resultatet. Uden alle tre sammenføjer formuleringer som »officiel ByteDance-model« eller »Mel-Band-konkurrencescore for fire stems« stiltiende forskellige artefakter fra forskellige tidspunkter i denne historie.
Kontrolleret sammenligning: Mel erstatter ikke BS på tværs af alle stems
Det klareste belæg er den kontrollerede sammenligning i Mel-Band-artiklen fra 2023, ikke en blanding af MVSep-sider og uvedkommende checkpoints fra miljøet. Hver række nedenfor bruger MUSDB18HQ uden ekstra sange. Inden for hver dybde er den vigtigste ændring projektionen: BS-RoFormers heuristiske, ikke-overlappende bånd erstattes af 60 overlappende mel-bånd.
Resultatet er en afvejning, ikke en sejr på alle punkter. Ved L=6 stiger vocals fra 10.78 til 11.21 dB og drums fra 9.61 til 9.91 dB, mens bass falder fra 11.43 til 9.64 dB, og other glider fra 7.86 til 7.81 dB. Ved L=9 vinder vocals 0.58 dB og other 0.13 dB, drums taber 0.32 dB, og bass rapporteres ikke, fordi træningen skred for langsomt frem.
Model i artiklen (MUSDB18HQ, ingen ekstra data)
Vocals
Bass
Drums
Other
Gennemsnitlig SDR
Parametre
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
ikke rapporteret
9.34
7.93
ikke rapporteret
94.8M
Artiklen forbinder basresultatet med frekvenskortlægningen. BS-RoFormer tildeler bevidst fine bånd ved lave frekvenser, mens mel-projektionen er mere nyttig for vokaler og visse mål uden bas. Den praktiske tekniske konklusion er derfor opgavespecifik: Mel-projektion er et stærkt valg til vokal, men en psykoakustisk begrundelse beviser ikke i sig selv dominans ved fire stems.
SCNet og målet med fire stems
SCNet anlægger et mere informationsorienteret syn på spektret. Artiklens forfattere omfatter Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu og Helen Meng; titelsiden angiver blandt andet Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab og The Chinese University of Hong Kong som tilhørsforhold. Arkitektonisk opdeler SCNet eksplicit blandingens spektrogram i delbånd og bruger sparsom komprimering til at håndtere båndenes forskellige informationstæthed. Enklere sagt lægger den ikke næsten al kapacitet i vokalområdet. Den får modellen til at fokusere på tids-frekvensområder, der faktisk rummer brugbare instrumentsignaler.
Det er vigtigt for fire stems. Bassen ligger lavt, men rummer vigtige overtoner. Trommer kombinerer meget korte transienter med bækkener og rumlyd. Other kan indeholde guitar, klaver, strygere, synthesizere og effekter på samme tid. Delbåndsmodellering giver forskellige frekvensområder en mere målrettet behandling, mens sparsom komprimering holder opmærksomheden væk fra tomme områder eller områder med få informationer.
SCNet-artiklen beskriver hele systemet som en lydencoder, et separationsnetværk baseret på dual-path RNN og en lyddecoder. Encoderen kortlægger blandingen til delbåndsrepræsentationer i frekvensdomænet, separationsnetværket modellerer struktur på tværs af tid og frekvens, og decoderen rekonstruerer målstems.
Huge-SCNet-4stems V1.2 hører til denne retning. Dens outputkontrakt er et afbalanceret sæt filer med vocals, drums, bass og other, som kan fortsætte til remix eller transskription, frem for et mål, der kun er optimeret til vokal.
Det er også vigtigt at adskille SCNet-artiklen fra Huge-SCNet-4stems V1.2-checkpointet. Artiklen leverer arkitekturen med sparsom komprimering, delbåndsdesignet og forskningsresultatet på MUSDB18-HQ; det artefakt, der kan downloades, er det offentlige Hugging Face-checkpoint huge_scnet_4stems_v1.2.ckpt. Dette checkpoint fra miljøet kan ikke overtage artiklens resultat på 9.0 dB på MUSDB18-HQ, fordi data og udgivelsesproveniens er forskellige.
Kodegrænsen skal også holdes adskilt. Artiklens forfattere udgiver thuhcsi/SCNet som det officielle implementeringsrepository, men repositoriet oplyser, at træningskoden endnu ikke er færdig, og henviser læserne til HTDemucs, Music-Source-Separation-Training og SCNet-PyTorch som midlertidige træningsrammer. Huge-SCNet-4stems V1.2 bør derfor beskrives som et offentligt valg af checkpoint til fire stems i SCNet-retningen, ikke som den officielle modelpakke fra SCNet-artiklen.
MVSep Ensemble som platformsarbejdsgang
MVSep Ensemble 2025.06.30 repræsenterer en platformsbaseret arbejdsgang med flere modeller. Den offentlige algoritmeside angiver mere end én modelfamilie. Vokalvejen kan bruge UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL og andre retninger, mens bass, drums og other kan benytte forskellige Demucs-modeller eller beslægtede modeller.
Styrken ved denne type ensemble kommer fra specialisering: Vokaltungt materiale tildeles vokalspecialister, materiale med mange lave frekvenser og transienter tildeles stærkere instrumentseparatorer, og derefter sammenflettes resultaterne. Det kan være en reference for kvalitetsloftet, men det er ikke ét checkpoint og ikke en selvstændig model, som en bruger kan reproducere ved at downloade én fil.
MVSep angiver det gennemsnitlige SDR for ensemblet fra 2025.06.30 til 13.67. Tallet er nyttigt som loft for en hostet platform, men bør ikke placeres i samme række som et selvstændigt checkpoint. Det afspejler en arbejdsgang på serversiden, som kan kombinere vokal, instrumental, bass, drums, other og yderligere instrumentspecifikke veje, før det endelige resultat leveres.
Derfor skal platformsensembler holdes uden for kategorien med enkeltmodeller, når emnet er én selvstændig model til fire stems, der kan downloades. Ellers flyttes sammenligningen fra modelarkitektur til en hostet arbejdsgang.
Offentlig sammenligning af fire stems
Tabellen nedenfor bruger tal fra de citerede offentlige model- og benchmarksider. Scorerne hjælper med at placere hver model under det samme mål med fire stems. De bør ikke læses som en absolut dom for enhver sang, genre eller lyttesituation.
Kildeområdet er bevidst smalt: Rækken med 10.02 dB for Huge-SCNet-4stems V1.2 kommer fra den offentlige HF/MVSep-reference; SCNet XL IHF, BS Roformer og HTDemucs4 bruger offentlige ZFTurbo/MVSep Multisong-rækker. Det er ikke en blandet tabel med SCNet-artiklens MUSDB18-HQ-resultater, Mel-Band-vokalsider og scorer fra MVSep Ensembles hostede arbejdsgang.
Model
Gennemsnitlig SDR
Vocals
Drums
Bass
Other
Sådan skal den læses
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Offentligt Huge-SCNet-checkpoint til fire stems i den citerede referencetabel.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
En stærk selvstændig kandidat til fire stems, især for drums og bass.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Nyttig reference for fire stems i retningen med båndopdelt RoFormer.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Moden klassisk baseline, men ikke loftet for den nuværende kvalitet ved fire stems.
Sådan læses scorerne
Højere SDR betyder som regel mindre forvrængning i forhold til referencestemmet. Men gennemsnitlig SDR kan ikke erstatte en lyttetest, og den kan ikke udjævne alle stems til ét svar. Én model kan være stærk til bass og drums, mens en anden holder vocals renere. Other er særligt vanskelig, fordi den indeholder mange instrumenter.
Værdien af Huge-SCNet-4stems V1.2 ligger i dens tydelige artefaktgrænse: ét offentligt checkpointnavn, standardoutput i fire stems og offentlige referencetal, der kan spores. SCNet XL IHF er fortsat en vigtig sammenligning. MVSep Ensemble er fortsat en hostet reference for kvalitetsloftet. De besvarer forskellige spørgsmål.
Brugere bør begynde med målet. Brug vokalseparation til den reneste vokal. Brug separation i fire stems til redigerbare vocals, drums, bass og other. Brug separation i seks stems, når guitar og klaver skal have hver sin fil.
Outputgrænse: Balance i fire stems mod detaljer i seks stems
Separation i seks stems opdeler other yderligere i guitar, klaver og det resterende other. Den er mere følsom over for guitaranslag, klaverattacks, keyboardtekstur og overtoner i de høje frekvenser. Et BS Roformer SW-checkpoint til seks stems repræsenterer derfor et andet mål og en anden træningskontrakt end Huge-SCNet-4stems V1.2.
Disse udsagn hører til forskellige lag: RoFormer beskriver en arkitekturfamilie, Mel-Band er rettet mod vokalrepræsentation, SCNet balancerer fire stems, og MVSep-ensembler kombinerer hostede komponenter. De besvarer hver sit spørgsmål om arkitektur, outputmål, offentlig tilgængelighed, arbejdsgangsform eller inferenskontrakt.
Konklusion: Vælg arkitekturen, ikke modeordet
Separation i fire stems er ikke et omdøbt akkompagnementsspor og ikke et sted, hvor den mest populære vokalmodel indsættes på ethvert instrument. Modellen skal balancere vocals, drums, bass og other, især trommetransienter, bassens dybe frekvenser, instrumenternes høje overtoner og samlingen af blandede instrumenter i other.
Huge-SCNet-4stems V1.2 har en klar position omkring dette standardmål med fire stems. Mel-Band RoFormer er fortsat vigtig for forståelsen af vokalseparation, mens MVSep Ensemble fortsat er nyttig som en hostet kvalitetsreference. De hører hver til sit lag i forskningens og implementeringens historie.