Separacja audio na cztery stemsy: dlaczego Huge-SCNet pasuje do celu MSS · TelkNet
Model
Separacja audio na cztery stemsy: dlaczego Huge-SCNet pasuje do celu MSS
Aktualne narzędzie TelkNet do czterech stemsów używa Huge-SCNet-4stems V1.2, aby podzielić pełny miks na wokal, perkusję, bas i pozostałe. Artykuł wyjaśnia wybór przez historię MSS, mocne strony i ograniczenia Mel-Band RoFormer, modelowanie subband SCNet oraz publiczne wyniki.
Aktualności o modelach / Separacja źródeł muzycznych
Data publikacji: 2026-06-30
Obecny model czterościeżkowy: Huge-SCNet-4stems V1.2
Standardowe wyjście: wokal / perkusja / bas / pozostałe
Separacja źródeł muzycznych z użyciem AI wyszła już poza proste pytanie, czy da się wyodrębnić wokal z miksu. W remiksowaniu, samplingu, ćwiczeniach, konwersji Music-to-MIDI, dźwięku przestrzennym i oczyszczaniu materiału liczy się to, czy wynik pozostaje edytowalny. Standardowa separacja na cztery ścieżki realizuje właśnie ten bardziej wymagający cel: dzieli pełny miks na wokal, perkusję, bas i pozostałe instrumenty, zamiast tworzyć wyłącznie pliki z wokalem i podkładem.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer i Huge-SCNet-4stems V1.2 reprezentują odmienne podejścia do separacji na cztery ścieżki. Sama jakość wokalu nie przesądza o jakości całej separacji. Platformowy zespół modeli może uzyskać wysoki wynik, choć nie jest samodzielnym modelem do pobrania, natomiast publiczny checkpoint stanowi odtwarzalny artefakt.
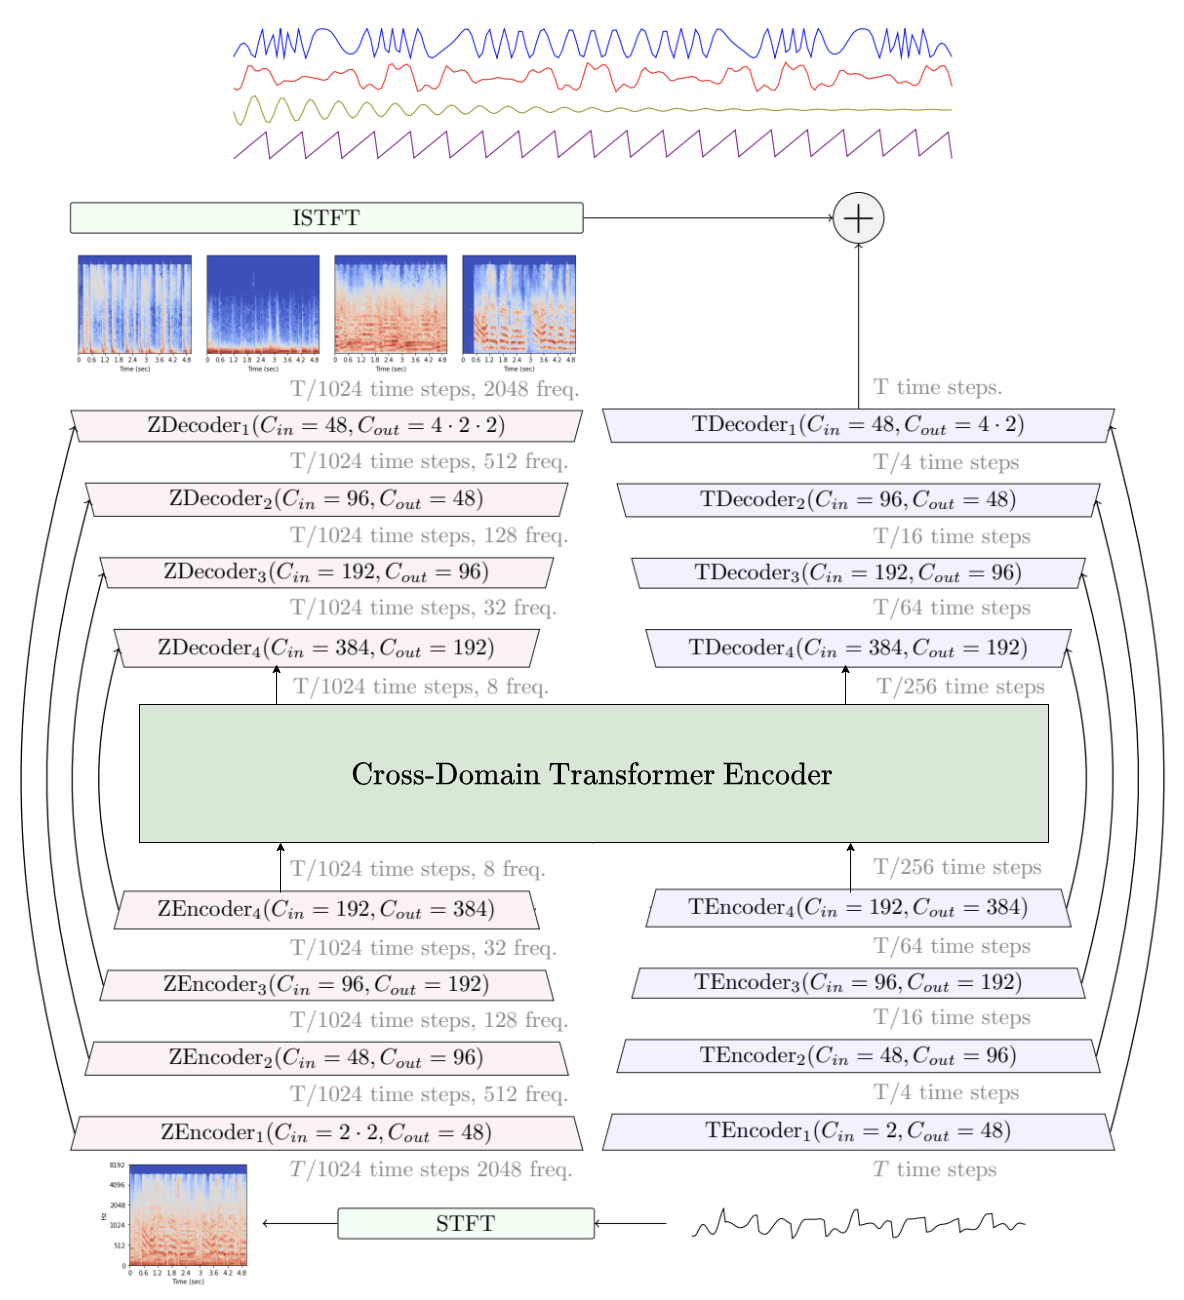
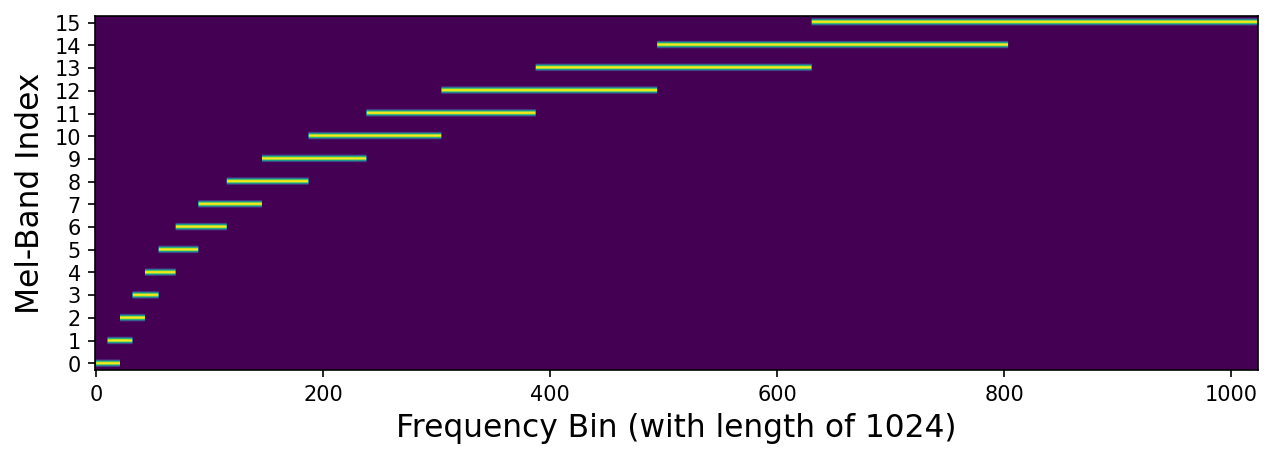
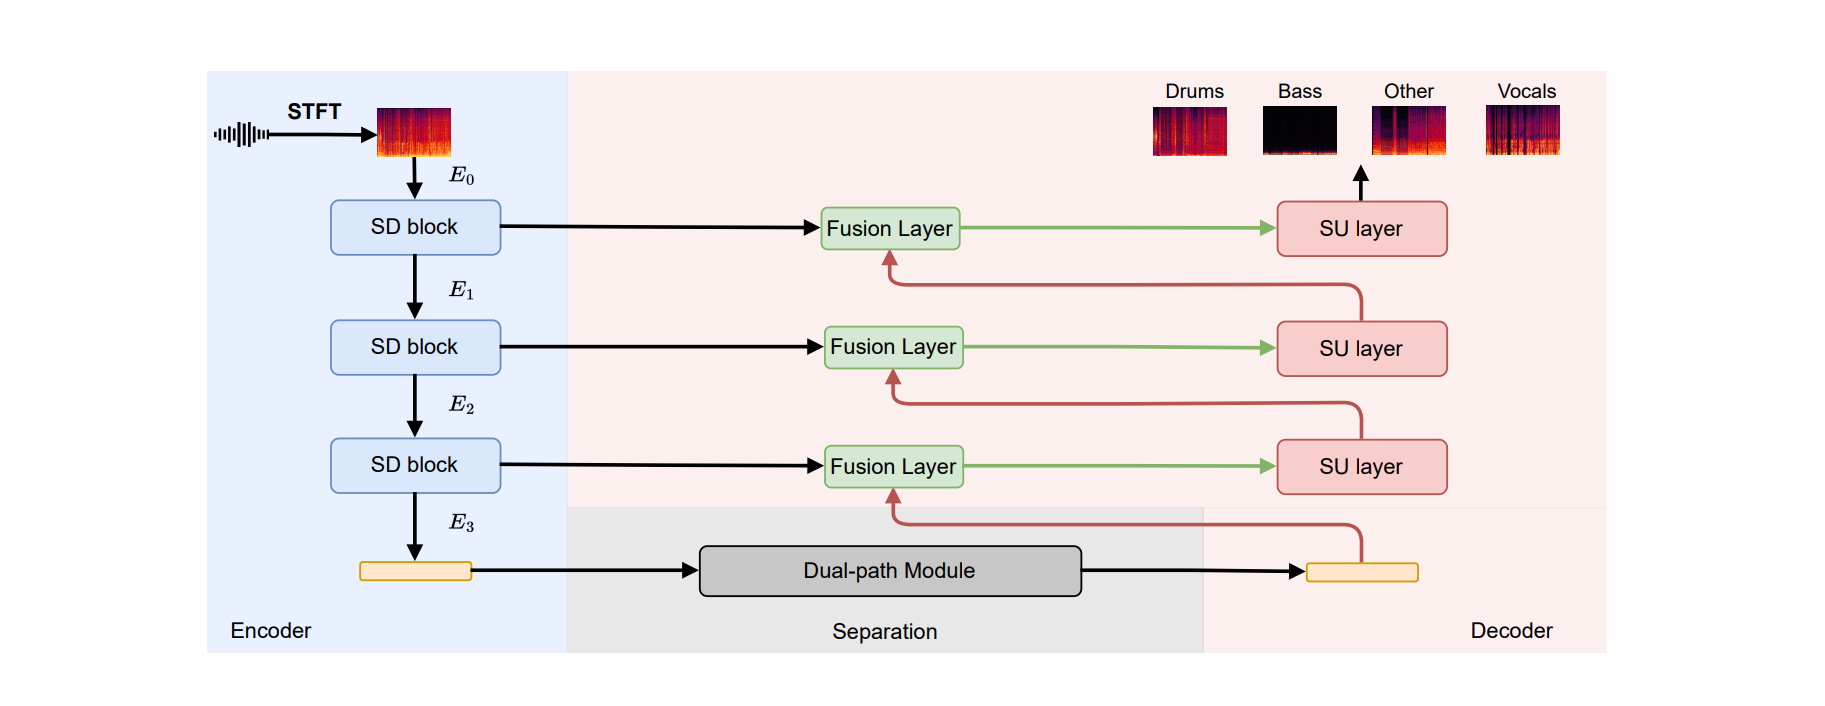
HTDemucs Oficjalny diagram struktury artykułu: wewnątrz modelu zbiegają się dwie gałęzie domeny falowej i domeny widma. Reprezentatywny projekt etapu „dual domeny” na poniższej osi czasu wygląda następująco (źródło: artykuł Hybrid Transformers, arXiv:2211.08553).Oficjalny diagram Mel-Band RoFormer Paper: w jaki sposób pojemniki widmowe są mapowane na nakładające się podpasma zorganizowane w skali mel. Podpasma uzyskane w zakresie średnio-niskich częstotliwości są gęstsze, dzięki czemu szczegóły wokalu są wyrażone z większą szczegółowością (źródło: arXiv:2310.01809).Oficjalny diagram architektury SCNet w papierze: Pozycja modułu kompresji rzadkiej pomiędzy koderem a siecią separacji jest jasna na pierwszy rzut oka - najpierw kompresowane są obszary o niskiej gęstości informacji, a następnie pozostawianie mocy obliczeniowej zatłoczonym granicom głosu (źródło: artykuł SCNet, arXiv:2401.13276).
Publiczne strony algorytmów i rankingi MVSep są częstym punktem odniesienia w separacji źródeł muzycznych. Dokumentują wyniki i konfiguracje; przepływu pracy opartego na zespole modeli nie należy traktować jak jednego samodzielnego modelu.
Cztery ścieżki to nie inna nazwa podkładu
Standardowa separacja na cztery ścieżki zwykle oznacza wokal, perkusję, bas i pozostałe instrumenty. Wokal obejmuje partię śpiewaną, perkusja — zestaw perkusyjny, bas — partię basową, a pozostałe gromadzą resztę instrumentów: gitarę, fortepian, smyczki, syntezatory, instrumenty dęte, efekty i inne elementy. Podkład słyszany po wyciszeniu wokalu jest w rzeczywistości sumą perkusji, basu i pozostałych instrumentów.
Cel ten wywodzi się z głównych zbiorów danych i tradycji ewaluacji separacji źródeł muzycznych. MUSDB18 i MUSDB18-HQ od dawna kształtują trening i ocenę modeli wokół tych czterech ścieżek. Gdy społeczność mówi o 4-stem, zwykle ma na myśli właśnie taki układ wyjściowy.
To rozróżnienie zmienia wybór narzędzia. Jeśli celem jest czysty wokal albo instrumental bez wokalu, bardziej bezpośredni będzie dwutorowy separator wokalu. Jeżeli chodzi o ćwiczenie perkusji, analizę basu, sampling, remiksowanie lub edytowalne oczyszczanie materiału, użyteczniejszym celem są cztery ścieżki. Kategoria pozostałe nie jest gorszym podkładem — to najtrudniejszy zbiór instrumentów w całym systemie.
Cztery etapy od U-Net do SCNet
Separacja źródeł muzycznych próbuje odzyskać kilka źródeł z jednej zmiksowanej fali dźwiękowej w wymiarze czasu i częstotliwości. Wcześniejsze modele potrafiły tworzyć użyteczne odsłuchowo wyniki, ale ich artefakty były dobrze znane: przesłuch wokalu, pozostałości perkusji, zamulony bas, rozmyte wysokie częstotliwości lub poszarpana faza w gęstych aranżacjach.
Okres
Reprezentatywne podejście
Postęp
Nierozwiązany problem
2020-2021
VR Architecture / U-Net
Traktowanie spektrogramów jak obrazów sprawiło, że podstawowa separacja wokalu i podkładu stała się praktyczna.
Lokalne okna splotowe miały trudności z długim kontekstem muzycznym i zależnościami fazowymi.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Połączenie modelowania fali i spektrogramu poprawiło jakość oraz stabilność rekonstrukcji.
Gęste kulminacje, mocny pogłos i złożone transjenty nadal mogły generować artefakty.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Podział na pasma, RoPE i silniejsze modelowanie czasowo-częstotliwościowe poprawiły obsługę wokalu, harmonii, glissand i długich wybrzmień.
Przydział częstotliwości korzystny dla wokalu nie musi być najlepszy dla wszystkich instrumentów w separacji czterościeżkowej.
2024-2026
SCNet / Huge-SCNet (Tsinghua SIGS, Skywork AI, Peng Cheng Lab, CUHK i inne instytucje)
Modelowanie podpasm i kompresja rzadka skupiają obliczenia na obszarach czasowo-częstotliwościowych bogatych w informacje.
Celem pozostaje standardowa separacja na cztery ścieżki, a nie wyjście sześciościeżkowe ani platformowy zespół modeli.
Ta historia pokazuje, dlaczego wyboru modelu nie można sprowadzać do jakości wokalu. Separacja na cztery ścieżki musi także zachować transjenty perkusji, częstotliwości podstawowe i harmoniczne basu, granice wokalu oraz szczegóły wysokoczęstotliwościowe w kategorii pozostałe.
Ramy czasowe również wynikają ze źródeł: artykuł SCNet został publicznie udostępniony w styczniu 2024 roku, natomiast Huge-SCNet-4stems V1.2 należy do późniejszego kontekstu publicznych checkpointów. Dlatego oś czasu obejmuje lata 2024-2026, zamiast sugerować, że sam SCNet pojawił się dopiero po 2025 roku.
Mel-Band RoFormer: przewaga w wokalu i ograniczenia czterech ścieżek
Mel-Band RoFormer został zaproponowany przez zespół Speech, Audio, and Music Intelligence (SAMI) firmy ByteDance. Autorami artykułu są Ju-Chiang Wang, Wei-Tsung Lu i Minz Won, a afiliację na stronie tytułowej podano jako SAMI, ByteDance. Strony społecznościowe czasem opisują tę linię jako ByteDance AI Labs, lecz najprecyzyjniejsze sformułowanie źródłowe wskazuje autorów artykułu oraz SAMI, ByteDance.
Model jest atrakcyjny, ponieważ kształtuje pasma częstotliwości w sposób bliższy ludzkiemu słuchowi. Ucho jest bardziej wrażliwe na niskie i średnie częstotliwości, w których znajdują się częstotliwości podstawowe wokalu, spółgłoski, oddech i liczne wskazówki dotyczące wysokości dźwięku. Projekcja mel-band zapewnia w tym zakresie dokładniejszą reprezentację, pomagając modelowi śledzić główny wokal, chórki, glissanda, vibrato i ogony pogłosu.
Rodzina RoFormer wykorzystuje rotacyjne kodowanie pozycyjne, czyli RoPE, zarówno dla sekwencji czasowych, jak i sekwencji podpasm. Dzięki temu wyniki uwagi zależą od położenia względnego. Glissanda, długie wybrzmienia i powtarzające się frazy pomagają intuicyjnie zrozumieć tę właściwość, ale artykuł bezpośrednio porównuje jedynie kontrolowane modele z RoPE i bez RoPE; nie podaje osobnych metryk dla glissand ani długich harmonii.
Tor sygnałowy zdefiniowany w artykule
BS-RoFormer najpierw przekształca falę mieszaniny w zespolony spektrogram. Projekcja pasmowa i hierarchiczny Transformer szacują zespoloną maskę; maska jest nakładana na widmo mieszaniny, a odwrotna STFT rekonstruuje docelową falę. Mel-RoFormer zmienia projekcję wewnątrz fθ: nakładające się pasma mel zastępują heurystyczny podział bez nakładania. Nie zastępuje całego toru rekonstrukcji.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: zespolony spektrogram mieszaniny, obejmujący część rzeczywistą i urojoną.
fθ: projekcja pasmowa, Transformatory wewnątrz- i międzypasmowe oraz estymacja maski.
M̂: zespolona maska celu służąca do odzyskania amplitudy i fazy.
ŷ: fala zrekonstruowana przez odwrotną STFT i ograniczana podczas treningu przez funkcje straty w dziedzinie fali oraz widma.
Dlatego Mel-Band RoFormer jest mocnym rozwiązaniem dla separacji wokalu i podkładu, głównego wokalu i chórków oraz ekstrakcji czystego wokalu. Problem polega na tym, że separacja na cztery ścieżki nie dotyczy wyłącznie wokalu. Musi też rozdzielić perkusję, bas i pozostałe instrumenty, a ostatnia kategoria często zawiera najtrudniejsze szczegóły instrumentalne w wysokich częstotliwościach.
Po publikacji artykułów: jak RoFormer stał się ekosystemem otwartych narzędzi
BS-RoFormer pojawił się we wrześniu 2023 roku z dwoma rodzajami dowodów w jednym artykule. Większy system L=12, trenowany na MUSDB18HQ oraz 500 wewnętrznych utworach, dokumentował zgłoszenie SAMI-ByteDance, które zajęło pierwsze miejsce w SDX23. Mniejsze modele trenowane wyłącznie na MUSDB18HQ dostarczyły kontrolowanych ablacji RoPE, podziału pasm i rekonstrukcji przez nakładanie i uśrednianie. Artykuł opublikował architekturę, warunki treningu i tabele wyników. Nie załączono do niego oryginalnego checkpointu SDX23 ani odnośnika do repozytorium ByteDance/SAMI z kodem treningu i inferencji.
Mel-Band RoFormer pojawił się w październiku 2023 roku. Zachował Transformatory RoPE, modelowanie sekwencji wewnątrz- i międzypasmowych, zespolone maski oraz rekonstrukcję fali, ale zastąpił ręcznie zaprojektowany podział bez nakładania 60 nakładającymi się pasmami mel. Miesięczny odstęp ma znaczenie: była to publiczna korekta projekcji częstotliwości wynikająca z ograniczenia wcześniejszego artykułu, a nie drugi oficjalny pakiet checkpointu wydany razem z tekstem.
Wykonywalny kod powstawał poza artykułami. Repozytorium lucidrains przełożyło diagramy i równania na klasy modeli PyTorch oraz otwarcie zaprosiło innych do odtworzenia separatora. Obsługa stereo, wiele ścieżek wyjściowych i wariant Mel-Band pozwoliły ponownie wykorzystywać tę strukturę, ale sam kod nie mógł odtworzyć wewnętrznych utworów, stanu optymalizatora, czasu treningu ani końcowych parametrów konkursowych.
Music-Source-Separation-Training zapewnił następnie wspólny warsztat dla tej struktury wielokrotnego użytku: moduły wczytujące zbiory danych, augmentację, trening, walidację, wznawianie od checkpointu, inferencję blokową, nakładanie i łączenie modeli. README przypisuje lucidrains odtworzenie modeli RoFormer na podstawie artykułów i przyjmuje zgłoszenia modeli od społeczności. Jedną architekturę można było odtąd trenować do separacji wokalu i instrumentalu, czterech ścieżek, podścieżek perkusji albo innych specjalistycznych celów. Nie istniał jeden kanoniczny zestaw wag społecznościowych.
Model wokalny Kimberley Jensen nadał temu procesowi konkretny wymiar. Repozytorium podaje, że model wytrenowano na większej ilości danych przy użyciu kodu ZFTurbo, domyślnie stosuje ośmiosekundowy blok i udostępnia num_overlap, aby ograniczyć artefakty łączenia kosztem dłuższej inferencji. Wymienia też osoby, które wniosły dane do zbioru. Te szczegóły pokazują, dlaczego checkpoint do pobrania ma cechy, których sama nazwa architektury nie potrafi opisać.
Obecna strona MVSep przypisuje pierwsze wysokiej jakości publiczne wagi Kimberley Jensen, a następnie opisuje późniejsze modyfikacje i dalszy trening otwartych wag. Bas Curtiz, unwa, becruily, gabox i inne edycje pojawiają się na tej samej stronie z różnymi kompromisami dotyczącymi pełni brzmienia, przesłuchu, szumu i SDR. To rozgałęziona genealogia wag: modele współdzielą Mel-Band RoFormer, ale nie dane, funkcję celu, historię dostrajania ani końcowe brzmienie.
Synteza oparta na dwóch artykułach RoFormer, implementacji lucidrains oraz środowisku treningowym ZFTurbo/MVSep. Strzałki pokazują zależności implementacyjne, a nie oficjalne poparcie.
Nazwa lub artefakt
Co identyfikuje
Jakiego pochodzenia nadal nie znamy
BS-RoFormer / Mel-Band RoFormer
Projekt projekcji pasmowej, RoPE i osiowego modelowania sekwencji.
Osoba lub zespół trenujący konkretny checkpoint, dane, docelowe ścieżki i zbiór ewaluacyjny.
Plik checkpointu do pobrania
Jeden zestaw parametrów, który zwykle wymaga zgodnej konfiguracji.
Czy pochodzi od autorów artykułu, z treningu społecznościowego, czy z późniejszego dostrajania.
Hostowany przepływ Mel-Band / BS-RoFormer
Usługa wybrała wagi, podział na bloki, nakładanie i format wyjścia.
Wyników hostowanego przepływu nie można przedstawiać jako wyników SDX23 ani oryginalnego artykułu.
Jedna nazwa architektury może dziś oznaczać system konkursowy, ablację z artykułu, checkpoint wokalny, checkpoint czterościeżkowy albo platformowy zespół modeli. Precyzyjny tekst musi ujawniać trzy rzeczy: kto zaproponował architekturę, skąd pochodzą obecne wagi i jaka konfiguracja inferencji dostarcza wynik. Bez wszystkich trzech określenia takie jak „oficjalny model ByteDance” lub „konkursowy wynik Mel-Band dla czterech ścieżek” po cichu łączą różne artefakty z różnych momentów tej historii.
Kontrolowane porównanie: Mel nie zastępuje BS na każdej ścieżce
Najczystszym dowodem jest kontrolowane porównanie z artykułu Mel-Band z 2023 roku, a nie mieszanina stron MVSep i niepowiązanych checkpointów społecznościowych. Każdy poniższy wiersz wykorzystuje MUSDB18HQ bez dodatkowych utworów. Przy tej samej głębokości główną zmianą jest projekcja: heurystyczne, nienakładające się pasma BS-RoFormer zastąpiono 60 nakładającymi się pasmami mel.
Wynik pokazuje kompromis, a nie pełne zwycięstwo. Dla L=6 wynik wokalu rośnie z 10.78 do 11.21 dB, a perkusji z 9.61 do 9.91 dB, podczas gdy bas spada z 11.43 do 9.64 dB, a pozostałe instrumenty nieznacznie z 7.86 do 7.81 dB. Dla L=9 wokal zyskuje 0.58 dB, pozostałe instrumenty 0.13 dB, perkusja traci 0.32 dB, a wyniku basu nie podano, ponieważ trening postępował zbyt wolno.
Model z artykułu (MUSDB18HQ, bez dodatkowych danych)
Wokal
Bas
Perkusja
Pozostałe
Średni SDR
Parametry
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
nie podano
9.34
7.93
nie podano
94.8M
Artykuł wiąże wynik basu z mapowaniem częstotliwości. BS-RoFormer celowo przydziela wąskie pasma niskim częstotliwościom, podczas gdy projekcja mel lepiej służy wokalowi i niektórym celom innym niż bas. Użyteczny wniosek inżynieryjny jest więc zależny od zadania: projekcja mel to mocny wybór dla wokalu, ale sama motywacja psychoakustyczna nie dowodzi przewagi w separacji czterościeżkowej.
SCNet i cel czterościeżkowy
SCNet patrzy na widmo przede wszystkim przez pryzmat informacji. Wśród autorów artykułu są Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu i Helen Meng; strona tytułowa wymienia wśród afiliacji Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab oraz The Chinese University of Hong Kong. Pod względem architektury SCNet jawnie dzieli spektrogram mieszaniny na podpasma i używa kompresji rzadkiej do obsługi różnej gęstości informacji w tych pasmach. Mówiąc prościej, nie skupia niemal całej pojemności na zakresie wokalu. Kieruje model ku obszarom czasowo-częstotliwościowym, które rzeczywiście przenoszą użyteczny sygnał instrumentalny.
Ma to znaczenie dla czterech ścieżek. Bas znajduje się nisko, ale niesie ważne harmoniczne. Perkusja łączy bardzo krótkie transjenty z talerzami i brzmieniem pomieszczenia. Pozostałe mogą jednocześnie zawierać gitarę, fortepian, smyczki, syntezatory i efekty. Modelowanie podpasm pozwala lepiej dopasować obróbkę do różnych obszarów częstotliwości, a kompresja rzadka odciąga uwagę od pustych lub ubogich informacyjnie regionów.
Artykuł SCNet opisuje cały system jako koder audio, sieć separującą opartą na dwutorowym RNN oraz dekoder audio. Koder odwzorowuje mieszaninę na reprezentacje podpasm w dziedzinie częstotliwości, sieć separująca modeluje strukturę w czasie i częstotliwości, a dekoder rekonstruuje docelowe ścieżki.
Huge-SCNet-4stems V1.2 należy do tej linii. Jego kontrakt wyjściowy obejmuje zrównoważony zestaw plików z wokalem, perkusją, basem i pozostałymi instrumentami, które można dalej wykorzystać w remiksowaniu lub transkrypcji, zamiast celu optymalizowanego wyłącznie pod wokal.
Trzeba też odróżnić artykuł SCNet od checkpointu Huge-SCNet-4stems V1.2. Artykuł przedstawia architekturę kompresji rzadkiej, projekt podpasm i wynik badawczy na MUSDB18-HQ; artefaktem do pobrania jest publiczny checkpoint Hugging Face huge_scnet_4stems_v1.2.ckpt. Ten checkpoint społecznościowy nie może przejąć wyniku 9.0 dB z MUSDB18-HQ podanego w artykule, ponieważ dane i pochodzenie publikacji są różne.
Granicę kodu również należy traktować osobno. Autorzy artykułu publikują thuhcsi/SCNet jako oficjalne repozytorium implementacji, ale repozytorium informuje, że kod treningowy nadal wymaga uzupełnienia, i wskazuje HTDemucs, Music-Source-Separation-Training oraz SCNet-PyTorch jako tymczasowe środowiska treningowe. Huge-SCNet-4stems V1.2 należy więc opisywać jako publiczny wybór checkpointu czterościeżkowego w linii SCNet, a nie jako oficjalny pakiet modelu z artykułu SCNet.
MVSep Ensemble jako platformowy przepływ pracy
MVSep Ensemble 2025.06.30 reprezentuje platformowy przepływ wykorzystujący wiele modeli. Publiczna strona algorytmu wymienia więcej niż jedną rodzinę modeli. Ścieżka wokalna może korzystać z UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL i innych rozwiązań, podczas gdy bas, perkusja i pozostałe mogą wywoływać odmienne modele Demucs lub modele pokrewne.
Siła takiego zespołu modeli wynika ze specjalizacji: materiał z dominującym wokalem trafia do specjalistów wokalnych, materiał bogaty w niskie częstotliwości i transjenty — do mocniejszych separatorów instrumentalnych, a następnie wyniki są łączone. Rozwiązanie może wyznaczać górny pułap jakości, ale nie jest jednym checkpointem ani samodzielnym modelem, który użytkownik odtworzy po pobraniu pojedynczego pliku.
MVSep podaje dla zespołu z 2025.06.30 średni SDR równy 13.67. Liczba ta jest użyteczna jako pułap hostowanej platformy, ale nie powinna trafiać do tego samego wiersza co samodzielny checkpoint. Odzwierciedla serwerowy przepływ pracy, który przed utworzeniem wyniku końcowego może połączyć ścieżki wokalu, instrumentalu, basu, perkusji, pozostałych i dodatkowych instrumentów.
Z tego powodu omówienie pojedynczego modelu czterościeżkowego do pobrania musi pozostawić zespoły platformowe poza kategorią pojedynczych modeli. W przeciwnym razie porównanie przesuwa się z architektury modelu na hostowany przepływ pracy.
Publiczne porównanie modeli czterościeżkowych
Poniższa tabela wykorzystuje dane z przywołanych publicznych stron modeli i benchmarków. Wyniki pomagają umiejscowić każdy model względem tego samego celu czterościeżkowego. Nie należy ich traktować jako bezwzględnego werdyktu dla każdego utworu, gatunku czy sposobu odsłuchu.
Zakres źródeł jest celowo wąski: wiersz Huge-SCNet-4stems V1.2 z wynikiem 10.02 dB pochodzi z publicznego zestawienia HF / MVSep; SCNet XL IHF, BS Roformer i HTDemucs4 wykorzystują publiczne wiersze ZFTurbo / MVSep Multisong. Nie jest to tabela mieszająca wyniki MUSDB18-HQ z artykułu SCNet, strony wokalne Mel-Band i oceny hostowanego przepływu MVSep Ensemble.
Model
Średni SDR
Wokal
Perkusja
Bas
Pozostałe
Jak interpretować wynik
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Publiczny checkpoint Huge-SCNet do czterech ścieżek w przywołanej tabeli referencyjnej.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Mocny samodzielny kandydat czterościeżkowy, szczególnie dla perkusji i basu.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Przydatny punkt odniesienia dla czterościeżkowej linii RoFormer z podziałem pasm.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Dojrzały, klasyczny model bazowy, który nie wyznacza już pułapu obecnej jakości separacji czterościeżkowej.
Jak interpretować wyniki
Wyższy SDR zwykle oznacza mniejsze zniekształcenie względem ścieżki referencyjnej. Średni SDR nie zastępuje jednak odsłuchu i nie może sprowadzić każdej ścieżki do jednej odpowiedzi. Jeden model może być mocny w basie i perkusji, a inny lepiej zachowywać czystość wokalu. Kategoria pozostałe jest szczególnie trudna, ponieważ obejmuje wiele instrumentów.
Wartość Huge-SCNet-4stems V1.2 wynika z jasno określonych granic artefaktu: jednej nazwy publicznego checkpointu, standardowego wyjścia czterościeżkowego i możliwych do prześledzenia publicznych danych referencyjnych. SCNet XL IHF pozostaje ważnym punktem porównania. MVSep Ensemble nadal stanowi hostowaną referencję górnego pułapu jakości. Odpowiadają na różne pytania.
Punktem wyjścia powinien być cel. Separacja wokalna służy do uzyskania najczystszego wokalu. Separacja czterościeżkowa dostarcza edytowalny wokal, perkusję, bas i pozostałe. Separacja sześciościeżkowa ma zastosowanie, gdy gitara i fortepian potrzebują osobnych plików.
Granica wyjścia: równowaga czterech ścieżek a szczegółowość sześciu
Separacja sześciościeżkowa dzieli kategorię pozostałe dalej na gitarę, fortepian i resztę. Jest bardziej wrażliwa na szarpnięcia strun gitary, ataki fortepianu, fakturę klawiszy i harmoniczne wysokich częstotliwości. Checkpoint BS Roformer SW do sześciu ścieżek reprezentuje więc inny cel i kontrakt treningowy niż Huge-SCNet-4stems V1.2.
Te stwierdzenia należą do odrębnych warstw: RoFormer opisuje rodzinę architektur, Mel-Band koncentruje się na reprezentacji wokalu, SCNet równoważy cztery ścieżki, a zespoły MVSep łączą hostowane komponenty. Każda warstwa odpowiada na inne pytanie o architekturę, cel wyjściowy, publiczną dostępność, formę przepływu pracy lub kontrakt inferencji.
Wniosek: wybieraj architekturę, nie modne hasło
Separacja na cztery ścieżki nie jest podkładem pod inną nazwą ani miejscem, w którym najpopularniejszy model wokalny stosuje się do każdego instrumentu. Wymaga od modelu równowagi między wokalem, perkusją, basem i pozostałymi, zwłaszcza transjentami perkusji, niskimi częstotliwościami basu, wysokimi harmonicznymi instrumentów oraz mieszaniną instrumentów w kategorii pozostałe.
Huge-SCNet-4stems V1.2 zajmuje jasno określoną pozycję wokół tego standardowego celu czterościeżkowego. Mel-Band RoFormer pozostaje ważny dla zrozumienia separacji wokalu, a MVSep Ensemble jest nadal użyteczny jako hostowana referencja jakości. Każdy z nich należy do innej warstwy historii badań i wdrożeń.