ข่าวโมเดล / การแยกแหล่งเสียงดนตรี
สรุป
การแยกแหล่งเสียงดนตรีด้วย AI ก้าวพ้นคำถามง่ายๆ ว่าจะดึงเสียงร้องออกจากมิกซ์ได้หรือไม่แล้ว สำหรับการรีมิกซ์ การสุ่มตัวอย่างเสียง การฝึกซ้อม Music-to-MIDI เสียงเชิงพื้นที่ และการทำความสะอาดวัตถุดิบ คำถามที่ใช้ประโยชน์ได้จริงคือผลลัพธ์ยังนำไปแก้ไขต่อได้หรือไม่ การแยกสี่สเต็มมาตรฐานยึดเป้าหมายที่เข้มงวดกว่านั้น โดยแยกมิกซ์เต็มออกเป็น vocals, drums, bass และ other แทนที่จะสร้างเพียงไฟล์เสียงร้องกับดนตรีประกอบ
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer และ Huge-SCNet-4stems V1.2 เป็นตัวแทนของแนวทางสี่สเต็มที่ต่างกัน ความสามารถด้านเสียงร้องเพียงอย่างเดียวไม่ได้กำหนดคุณภาพของสี่สเต็ม เอนเซมเบิลระดับแพลตฟอร์มอาจทำคะแนนได้สูงทั้งที่ไม่ใช่โมเดลเดี่ยวซึ่งดาวน์โหลดได้ ขณะที่เช็กพอยต์สาธารณะมอบอาร์ติแฟกต์ที่ทำซ้ำได้
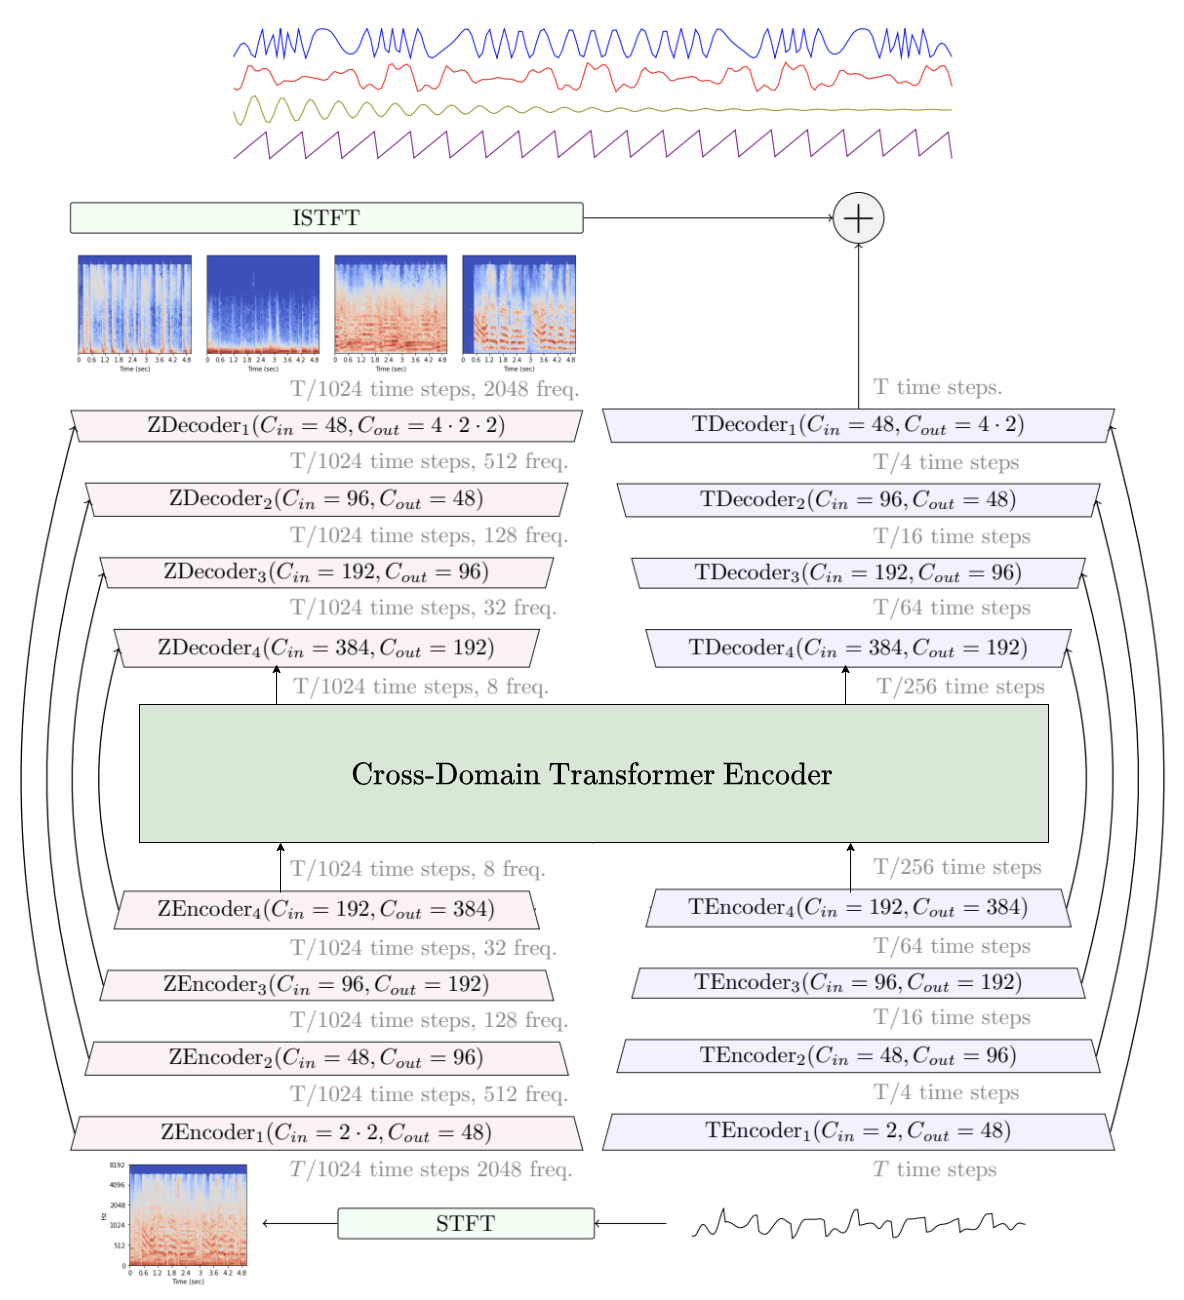
HTDemucs แผนภาพโครงสร้างอย่างเป็นทางการของรายงาน: สองกิ่งของโดเมนรูปคลื่นและโดเมนสเปกตรัมมาบรรจบกันภายในแบบจำลอง การออกแบบที่เป็นตัวแทนของขั้นตอน "โดเมนคู่" ในไทม์ไลน์ด้านล่างมีลักษณะดังนี้ (ที่มา: กระดาษ Hybrid Transformers, arXiv:2211.08553)
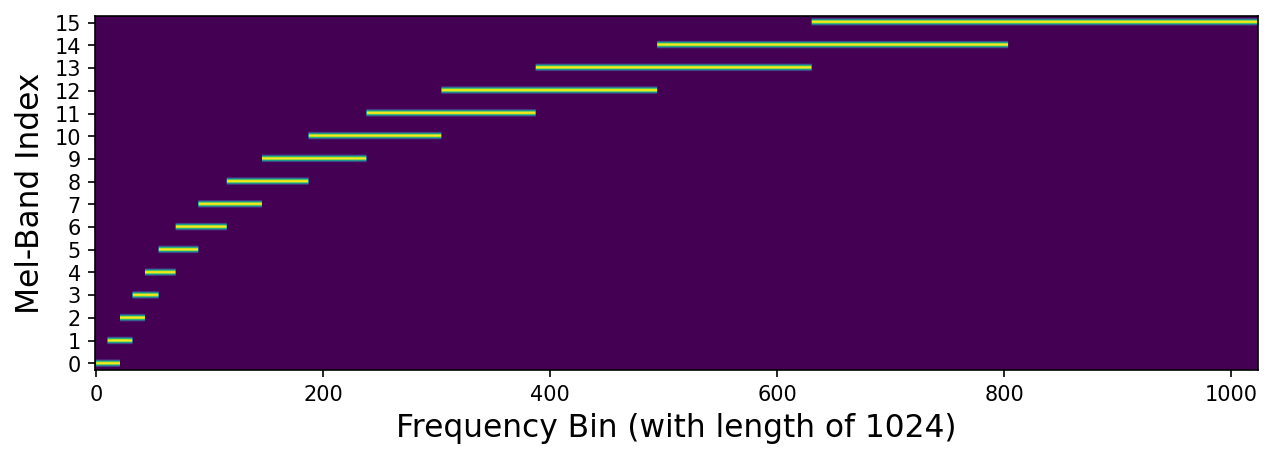
แผนภาพอย่างเป็นทางการของ Mel-Band RoFormer Paper: วิธีแมปสเปกตรัมกับแบนด์ย่อยที่ทับซ้อนกันซึ่งจัดในระดับเมล ย่านความถี่ย่อยที่ได้รับในความถี่กลางถึงต่ำจะมีความหนาแน่นมากกว่า ดังนั้นรายละเอียดเสียงร้องจึงแสดงออกมาในรายละเอียดที่ละเอียดยิ่งขึ้น (ที่มา: arXiv:2310.01809)
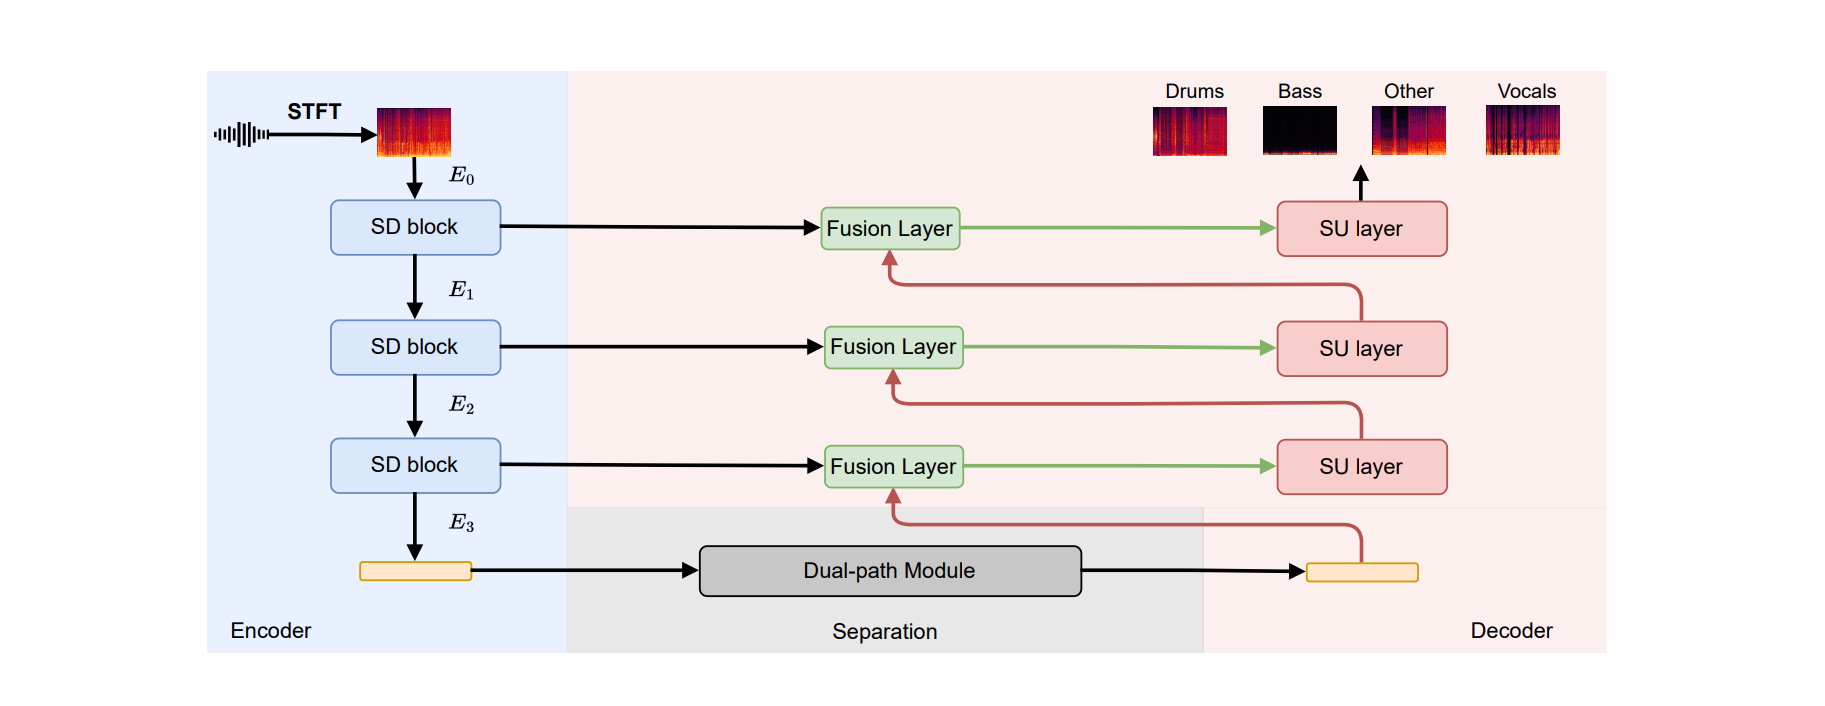
แผนภาพสถาปัตยกรรมอย่างเป็นทางการของกระดาษ SCNet: ตำแหน่งของโมดูลการบีบอัดแบบกระจายระหว่างตัวเข้ารหัสและเครือข่ายการแยกนั้นชัดเจนในทันที โดยบีบอัดพื้นที่ที่มีความหนาแน่นของข้อมูลต่ำก่อน จากนั้นจึงปล่อยให้พลังในการประมวลผลอยู่ที่ขอบเขตเสียงที่หนาแน่น (ที่มา: กระดาษ SCNet, arXiv:2401.13276)
หน้าอัลกอริทึมสาธารณะและลีดเดอร์บอร์ดของ MVSep เป็นจุดอ้างอิงที่พบได้ทั่วไปในงานแยกแหล่งเสียงดนตรี หน้าเหล่านี้บันทึกผลลัพธ์และการกำหนดค่า จึงไม่ควรตีความเวิร์กโฟลว์แบบเอนเซมเบิลว่าเป็นโมเดลเดี่ยวหนึ่งโมเดล
สี่สเต็มไม่ใช่อีกชื่อหนึ่งของแทร็กดนตรีประกอบ
การแยกสี่สเต็มมาตรฐานโดยทั่วไปหมายถึง vocals, drums, bass และ other โดย vocals คือแทร็กเสียงร้อง drums คือชุดกลอง bass คือพาร์ตเบส ส่วน other เก็บเครื่องดนตรีที่เหลือ ได้แก่ กีตาร์ เปียโน เครื่องสาย ซินธิไซเซอร์ เครื่องเป่าทองเหลือง เอฟเฟกต์ และอื่นๆ แทร็กดนตรีประกอบที่ได้ยินหลังปิดเสียงร้อง แท้จริงคือผลรวมของ drums, bass และ other
เป้าหมายนี้มาจากชุดข้อมูลหลักและธรรมเนียมการประเมินในงานแยกแหล่งเสียงดนตรี MUSDB18 และ MUSDB18-HQ กำหนดทิศทางการฝึกและประเมินโมเดลโดยอิงสี่สเต็มนี้มาเป็นเวลานาน เมื่อชุมชนกล่าวถึง 4-stem โดยทั่วไปจึงหมายถึงเป้าหมายเอาต์พุตนี้
ความแตกต่างดังกล่าวส่งผลต่อการเลือกเครื่องมือ หากต้องการเสียงร้องสะอาดหรือดนตรีบรรเลงที่ไม่มีเสียงร้อง ตัวแยกเสียงร้องแบบสองสเต็มย่อมตรงจุดกว่า หากต้องการฝึกกลอง วิเคราะห์เบส สุ่มตัวอย่างเสียง รีมิกซ์ หรือทำความสะอาดวัตถุดิบที่ยังแก้ไขได้ สี่สเต็มจะมีประโยชน์กว่า other ไม่ใช่ดนตรีประกอบที่ด้อยกว่า แต่เป็นตะกร้ารวมเครื่องดนตรีที่ยากที่สุดในระบบ
สี่ช่วงพัฒนาการจาก U-Net ถึง SCNet
การแยกแหล่งเสียงดนตรีคือความพยายามกู้คืนหลายแหล่งเสียงจากรูปคลื่นผสมหนึ่งชุดตลอดมิติเวลาและความถี่ โมเดลยุคก่อนสร้างผลลัพธ์ที่ฟังได้ แต่ยังมีข้อบกพร่องที่คุ้นเคย ได้แก่ เสียงร้องรั่ว เสียงกลองปน เบสขุ่น ความถี่สูงเลือน หรือคุณภาพเฟสที่เหมือนฉีกขาดในช่วงเรียบเรียงดนตรีหนาแน่น
ประวัตินี้อธิบายว่าเหตุใดการเลือกโมเดลจึงลดทอนเหลือเพียงคุณภาพเสียงร้องไม่ได้ การแยกสี่สเต็มต้องรักษาทั้งทรานเชียนต์ของกลอง ความถี่มูลฐานและฮาร์มอนิกของเบส ขอบเขตเสียงร้อง และรายละเอียดความถี่สูงภายใน other
การกำหนดช่วงเวลาก็ยึดตามขอบเขตของแหล่งข้อมูลเช่นกัน งานวิจัย SCNet เผยแพร่ต่อสาธารณะในเดือนมกราคม 2024 ขณะที่ Huge-SCNet-4stems V1.2 อยู่ในบริบทของเช็กพอยต์สาธารณะที่ตามมาภายหลัง ไทม์ไลน์นี้จึงใช้ช่วง 2024-2026 แทนการชวนให้เข้าใจว่า SCNet เพิ่งปรากฏหลังปี 2025
Mel-Band RoFormer: จุดแข็งด้านเสียงร้องและข้อจำกัดของสี่สเต็ม
Mel-Band RoFormer เสนอโดยทีม Speech, Audio, and Music Intelligence (SAMI) ของ ByteDance ผู้เขียนงานวิจัยคือ Ju-Chiang Wang, Wei-Tsung Lu และ Minz Won โดยหน้าชื่อเรื่องระบุสังกัดเป็น SAMI, ByteDance หน้าชุมชนบางแห่งสรุปสายงานนี้ว่า ByteDance AI Labs แต่ถ้อยคำที่ตรงกับแหล่งข้อมูลที่สุดคือผู้เขียนงานวิจัยและ SAMI, ByteDance
โมเดลนี้น่าสนใจเพราะจัดรูปย่านความถี่ให้ใกล้เคียงการได้ยินของมนุษย์ หูไวต่อความถี่ต่ำและกลางมากกว่า ซึ่งเป็นบริเวณของความถี่มูลฐานเสียงร้อง พยัญชนะ ลมหายใจ และเบาะแสระดับเสียงจำนวนมาก การฉายย่านเมลทำให้ช่วงนี้มีตัวแทนที่ละเอียดขึ้น ช่วยให้โมเดลติดตามเสียงร้องนำ เสียงประสาน การไล้โน้ต วิบราโต และหางรีเวิร์บได้
ตระกูล RoFormer ใช้การเข้ารหัสตำแหน่งแบบหมุน หรือ RoPE กับทั้งลำดับเวลาและลำดับย่านย่อย ทำให้คะแนนแอตเทนชันขึ้นอยู่กับตำแหน่งสัมพัทธ์ การไล้โน้ต เสียงค้าง และวลีซ้ำเป็นภาพเชิงโครงสร้างที่ช่วยให้เข้าใจคุณสมบัตินี้ แต่งานวิจัยทดสอบโดยตรงเพียงโมเดลควบคุมที่มี RoPE เทียบกับไม่มี RoPE และไม่ได้รายงานตัวชี้วัดแยกสำหรับการไล้โน้ตหรือฮาร์โมนียาว
เส้นทางสัญญาณที่กำหนดไว้ในงานวิจัย
BS-RoFormer แปลงรูปคลื่นผสมเป็นสเปกโทรแกรมเชิงซ้อนก่อน การฉายย่านและ Transformer แบบลำดับชั้นประมาณค่ามาสก์เชิงซ้อน จากนั้นนำมาสก์ไปใช้กับสเปกตรัมของเสียงผสม แล้วสร้างรูปคลื่นเป้าหมายคืนด้วย STFT ย้อนกลับ Mel-RoFormer เปลี่ยนการฉายภายใน fθ โดยใช้ย่านเมลที่ซ้อนทับกันแทนการแบ่งแบบฮิวริสติกที่ไม่ซ้อนทับ ไม่ได้แทนที่เส้นทางการสร้างคืนทั้งหมด
ด้วยเหตุนี้ Mel-Band RoFormer จึงเป็นแนวทางที่แข็งแรงสำหรับงานแยกเสียงร้อง/ดนตรีประกอบ เสียงร้องนำ/เสียงประสาน และการสกัดเสียงร้องสะอาด ปัญหาคือการแยกสี่สเต็มไม่ได้มีเพียงเสียงร้อง แต่ยังต้องแยก drums, bass และ other ซึ่ง other มักมีรายละเอียดเครื่องดนตรีความถี่สูงที่จัดการยากที่สุด
หลังเผยแพร่งานวิจัย: RoFormer กลายเป็นระบบนิเวศเครื่องมือเปิดได้อย่างไร
BS-RoFormer ปรากฏในเดือนกันยายน 2023 พร้อมหลักฐานสองประเภทในงานวิจัยฉบับเดียว ระบบ L=12 ที่ใหญ่กว่า ซึ่งฝึกด้วย MUSDB18HQ และเพลงภายในองค์กร 500 เพลง บันทึกผลงานส่งประกวด SDX23 อันดับหนึ่งของ SAMI-ByteDance ส่วนโมเดลขนาดเล็กกว่าที่ใช้เฉพาะ MUSDB18HQ ให้การทดลองตัดองค์ประกอบแบบควบคุมสำหรับ RoPE การแบ่งย่าน และการสร้างคืนแบบซ้อนทับแล้วเฉลี่ย งานวิจัยเผยแพร่สถาปัตยกรรม เงื่อนไขการฝึก และตารางผลลัพธ์ แต่ไม่ได้แนบเช็กพอยต์ SDX23 ต้นฉบับหรือลิงก์ไปยังคลังโค้ดฝึกและอินเฟอเรนซ์ของ ByteDance/SAMI
Mel-Band RoFormer ตามมาในเดือนตุลาคม 2023 โดยคง RoPE Transformer การสร้างแบบจำลองลำดับภายในและระหว่างย่าน มาสก์เชิงซ้อน และการสร้างรูปคลื่นคืนไว้ แต่แทนที่การแบ่งแบบไม่ซ้อนทับที่ออกแบบด้วยมือด้วยย่านเมลซ้อนทับ 60 ย่าน ช่วงห่างหนึ่งเดือนนี้มีความหมาย เพราะเป็นการปรับแก้การฉายความถี่ต่อสาธารณะตามข้อจำกัดที่งานก่อนหน้าระบุไว้เอง ไม่ใช่แพ็กเกจเช็กพอยต์ทางการชุดที่สองซึ่งเผยแพร่พร้อมตัวบท
โค้ดที่เรียกใช้ได้สะสมอยู่นอกงานวิจัย คลังโค้ดของ lucidrains แปลงแผนภาพและสมการเป็นคลาสโมเดล PyTorch พร้อมเชิญชวนผู้อื่นให้สร้างตัวแยกนี้ซ้ำอย่างเปิดเผย การรองรับสเตอริโอ เอาต์พุตหลายสเต็ม และรุ่น Mel-Band ทำให้โครงสร้างนำกลับมาใช้ได้ แต่โค้ดเพียงอย่างเดียวไม่อาจกู้คืนเพลงภายในองค์กร สถานะออปติไมเซอร์ ระยะเวลาฝึก หรือพารามิเตอร์การแข่งขันชุดสุดท้าย
จากนั้น Music-Source-Separation-Training มอบพื้นที่ทำงานร่วมให้โครงสร้างที่นำกลับมาใช้ได้นี้ ทั้งตัวโหลดชุดข้อมูล การเพิ่มข้อมูล การฝึก การตรวจสอบ การฝึกต่อจากเช็กพอยต์ อินเฟอเรนซ์แบบแบ่งช่วง การซ้อนทับ และเอนเซมเบิล README ให้เครดิต lucidrains ที่สร้างโมเดล RoFormer จากงานวิจัยขึ้นใหม่ และเปิดรับโมเดลจากชุมชน สถาปัตยกรรมเดียวจึงฝึกเพื่อแยกเสียงร้อง/ดนตรีบรรเลง สี่สเต็ม สเต็มย่อยของกลอง หรือเป้าหมายเฉพาะทางอื่นๆ ได้ โดยไม่มีน้ำหนักชุมชนชุดเดียวที่เป็นมาตรฐานกลาง
โมเดลเสียงร้องของ Kimberley Jensen ทำให้กระบวนการนี้เห็นภาพชัด คลังโค้ดระบุว่าโมเดลฝึกด้วยข้อมูลมากขึ้นโดยใช้โค้ดของ ZFTurbo ใช้ช่วงเสียงแปดวินาทีเป็นค่าเริ่มต้น และเปิดพารามิเตอร์ num_overlap เพื่อลดข้อบกพร่องตรงรอยต่อ โดยแลกกับอินเฟอเรนซ์ที่นานขึ้น อีกทั้งยังให้เครดิตผู้ร่วมสร้างชุดข้อมูล รายละเอียดเหล่านี้อธิบายว่าเหตุใดเช็กพอยต์ที่ดาวน์โหลดได้จึงมีลักษณะเฉพาะซึ่งชื่อสถาปัตยกรรมเพียงอย่างเดียวบรรยายไม่ได้
หน้า MVSep ปัจจุบันระบุว่า Kimberley Jensen เป็นผู้สร้างน้ำหนักสาธารณะคุณภาพสูงรุ่นแรก จากนั้นจึงอธิบายการปรับแก้และฝึกน้ำหนักเปิดต่อในภายหลัง หน้าเดียวกันยังมีรุ่นของ Bas Curtiz, unwa, becruily, gabox และรายอื่นๆ ซึ่งมีจุดแลกเปลี่ยนด้านความเต็มของเสียง เสียงรั่ว สัญญาณรบกวน และ SDR ต่างกัน นี่คือลำดับวงศ์น้ำหนักที่แตกแขนง โมเดลเหล่านี้ใช้ Mel-Band RoFormer ร่วมกัน แต่ไม่ได้ใช้ข้อมูล วัตถุประสงค์ ประวัติการปรับละเอียด หรือเสียงสุดท้ายร่วมกัน
9.80 dB BS-RoFormer L=6, ใช้เฉพาะ MUSDB18HQ, OA (overlap & average) และการประเมินแบบอิงค่ามัธยฐานของงานวิจัย11.99 dB BS-RoFormer L=12, OA, MUSDB18HQ ร่วมกับเพลงภายในองค์กร 500 เพลง แบ่ง 450/50 สำหรับฝึกและตรวจสอบ9.97 global SDR ผลทดสอบส่วนตัว SDX23 ของ BS-RoFormer ด้วย TC (truncate & concat) โดยสี่สเต็มได้ 11.36 / 11.15 / 10.27 / 7.08 dB
ลำดับวงศ์น้ำหนักเปิดของ RoFormer ที่แตกแขนง
งานวิจัยสองฉบับนำไปสู่สถาปัตยกรรมที่ใช้ซ้ำได้ จากนั้นโค้ดและโครงสร้างพื้นฐานการฝึกของชุมชนแตกแขนงเป็นน้ำหนักสำหรับเสียงร้อง สี่สเต็ม หลายสเต็ม และการปรับแต่งระดับแพลตฟอร์ม
RoFormer หลังการเผยแพร่: หนึ่งสถาปัตยกรรม หลายน้ำหนักหลายสาย เส้นเชื่อมหมายถึงการพึ่งพาด้านการนำไปใช้หรือการฝึก ไม่ใช่การรับรองอย่างเป็นทางการ
บันทึกที่เผยแพร่แล้ว
2023.09 · BS-RoFormer
ระบบ SDX23 + การทดลองตัดองค์ประกอบ
การแบ่งย่าน · RoPE · มาสก์เชิงซ้อน
2023.10 · Mel-RoFormer
การปรับแก้เป็นย่านเมลซ้อนทับ
การเปรียบเทียบสี่สเต็มแบบควบคุม
ไม่ได้แนบมากับงานวิจัย
เช็กพอยต์ SDX23 ต้นฉบับ
เพลงภายในองค์กร 500 เพลง + สถานะออปติไมเซอร์
คลังโค้ดฝึกทางการของ ByteDance/SAMI
โครงสร้างที่ใช้ซ้ำได้
แกนกลางร่วม
RoPE Transformer หลายย่าน
การฉาย → การสร้างแบบจำลองลำดับตามแกน
มาสก์เชิงซ้อน → การสร้างคืนด้วย iSTFT
การออกแบบที่ทำซ้ำได้ แต่น้ำหนักการแข่งขันกู้คืนไม่ได้
lucidrains · การนำไปใช้ด้วย PyTorch
คลาสโมเดล สเตอริโอ หลายสเต็ม
Music-Source-Separation-Training
ข้อมูล การเพิ่มข้อมูล การฝึก การตรวจสอบ
ช่วงเสียง การซ้อนทับ TTA เอนเซมเบิล
ตระกูลน้ำหนักจากชุมชน
Kimberley Jensen · เสียงร้อง / ดนตรีบรรเลง
ข้อมูลมากขึ้น · ช่วง 8 วินาที · ปรับการซ้อนทับได้
เช็กพอยต์สาธารณะ การกำหนดค่า สคริปต์อินเฟอเรนซ์
การฝึกซ้ำของ MVSep + รุ่นจากชุมชน
ตัวเลือกด้านความเต็ม / เสียงรั่ว / SDR ต่างกัน
หลายน้ำหนัก ไม่ใช่เช็กพอยต์มาตรฐานหนึ่งชุด
แขนงสี่สเต็ม หกสเต็ม กลอง และโมเดลเฉพาะทาง
เป้าหมายและข้อมูลฝึกเปลี่ยนความสามารถ
สถาปัตยกรรมร่วมไม่ได้หมายถึงคะแนนร่วม
พฤติกรรมอินเฟอเรนซ์แตกแขนงอีกครั้งหลังการฝึก
เช็กพอยต์ · ช่วงเสียง / การซ้อนทับ · TTA / เอนเซมเบิล · สัญญาเอาต์พุตสเต็ม · การประมวลผลภายหลัง
ผู้ฟังได้ยินเช็กพอยต์ร่วมกับตัวเลือกอินเฟอเรนซ์ ไม่ใช่ชื่องานวิจัยเพียงอย่างเดียว
การสังเคราะห์จากงานวิจัย RoFormer สองฉบับ การนำไปใช้ของ lucidrains และเฟรมเวิร์กฝึก ZFTurbo/MVSep ลูกศรแสดงการพึ่งพาด้านการนำไปใช้ ไม่ใช่การรับรองอย่างเป็นทางการ
ชื่อสถาปัตยกรรมหนึ่งชื่ออาจหมายถึงระบบการแข่งขัน การทดลองตัดองค์ประกอบในงานวิจัย เช็กพอยต์เสียงร้อง เช็กพอยต์สี่สเต็ม หรือเอนเซมเบิลระดับแพลตฟอร์มก็ได้แล้ว เนื้อหาที่แม่นยำต้องเปิดเผยสามสิ่ง ได้แก่ ใครเสนอสถาปัตยกรรม น้ำหนักปัจจุบันมาจากไหน และสูตรอินเฟอเรนซ์ใดสร้างผลลัพธ์ หากขาดข้อใดข้อหนึ่ง วลีอย่าง “โมเดลทางการของ ByteDance” หรือ “คะแนนแข่งขันสี่สเต็มของ Mel-Band” จะนำอาร์ติแฟกต์ต่างชิ้นจากคนละช่วงเวลาของประวัติศาสตร์นี้มาต่อกันโดยไม่บอกกล่าว
การเปรียบเทียบแบบควบคุม: Mel ไม่ได้แทนที่ BS ในทุกสเต็ม
หลักฐานที่ชัดที่สุดคือการเปรียบเทียบแบบควบคุมในงานวิจัย Mel-Band ปี 2023 ไม่ใช่การผสมหน้าต่างๆ ของ MVSep กับเช็กพอยต์ชุมชนที่ไม่เกี่ยวข้อง ทุกแถวด้านล่างใช้ MUSDB18HQ โดยไม่มีเพลงเพิ่มเติม ภายในแต่ละระดับความลึก การเปลี่ยนหลักคือการฉาย โดยแทนย่านแบบฮิวริสติกที่ไม่ซ้อนทับของ BS-RoFormer ด้วยย่านเมลซ้อนทับ 60 ย่าน
ผลลัพธ์คือจุดแลกเปลี่ยน ไม่ใช่ชัยชนะทุกด้าน ที่ L=6 vocals เพิ่มจาก 10.78 เป็น 11.21 dB และ drums เพิ่มจาก 9.61 เป็น 9.91 dB ขณะที่ bass ลดจาก 11.43 เป็น 9.64 dB และ other ลดเล็กน้อยจาก 7.86 เป็น 7.81 dB ที่ L=9 vocals เพิ่ม 0.58 dB และ other เพิ่ม 0.13 dB ส่วน drums ลด 0.32 dB ขณะที่ไม่มีรายงาน bass เพราะการฝึกคืบหน้าช้าเกินไป
งานวิจัยเชื่อมโยงผลของ bass กับการแมปความถี่ BS-RoFormer จงใจจัดสรรย่านละเอียดในความถี่ต่ำ ขณะที่การฉายเมลเป็นประโยชน์ต่อเสียงร้องและเป้าหมายบางประเภทที่ไม่ใช่เบสมากกว่า ข้อสรุปทางวิศวกรรมที่ใช้ประโยชน์ได้จึงขึ้นอยู่กับงาน การฉายเมลเป็นตัวเลือกที่แข็งแรงสำหรับเสียงร้อง แต่เหตุผลทางจิตอะคูสติกเพียงอย่างเดียวไม่ได้พิสูจน์ความเหนือกว่าในสี่สเต็ม
SCNet กับเป้าหมายสี่สเต็ม
SCNet มองสเปกตรัมโดยให้ความสำคัญกับข้อมูลมากขึ้น ผู้เขียนงานวิจัยประกอบด้วย Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu และ Helen Meng ส่วนหน้าชื่อเรื่องระบุสังกัด ได้แก่ Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab, The Chinese University of Hong Kong และแห่งอื่นๆ ในเชิงสถาปัตยกรรม SCNet แบ่งสเปกโทรแกรมของเสียงผสมเป็นย่านย่อยอย่างชัดเจน และใช้การบีบอัดแบบเบาบางเพื่อรับมือความหนาแน่นข้อมูลที่ต่างกันของแต่ละย่าน กล่าวอย่างง่ายคือไม่ได้ทุ่มความจุเกือบทั้งหมดให้ช่วงเสียงร้อง แต่ผลักให้โมเดลมุ่งไปยังบริเวณเวลา-ความถี่ที่มีสัญญาณเครื่องดนตรีซึ่งเป็นประโยชน์จริง
จุดนี้สำคัญต่อสี่สเต็ม เบสอยู่ในย่านต่ำแต่มีฮาร์มอนิกสำคัญ กลองผสานทรานเชียนต์ที่สั้นมากเข้ากับฉาบและเสียงห้อง other อาจมีทั้งกีตาร์ เปียโน เครื่องสาย ซินธิไซเซอร์ และเอฟเฟกต์พร้อมกัน การสร้างแบบจำลองย่านย่อยช่วยให้แต่ละช่วงความถี่ได้รับการจัดการเฉพาะเจาะจงขึ้น ขณะที่การบีบอัดแบบเบาบางช่วยไม่ให้แอตเทนชันไปอยู่ที่บริเวณว่างหรือมีข้อมูลน้อย
งานวิจัย SCNet อธิบายระบบทั้งหมดเป็นตัวเข้ารหัสเสียง เครือข่ายแยกที่ใช้ dual-path RNN และตัวถอดรหัสเสียง ตัวเข้ารหัสแมปเสียงผสมเป็นตัวแทนย่านย่อยในโดเมนความถี่ เครือข่ายแยกสร้างแบบจำลองโครงสร้างตลอดเวลาและความถี่ ส่วนตัวถอดรหัสสร้างสเต็มเป้าหมายคืน
Huge-SCNet-4stems V1.2 อยู่ในแนวทางนี้ สัญญาเอาต์พุตคือชุดไฟล์ vocals, drums, bass และ other ที่สมดุล ซึ่งนำไปรีมิกซ์หรือถอดโน้ตต่อได้ แทนที่จะเป็นเป้าหมายที่ปรับให้เหมาะกับเสียงร้องเพียงอย่างเดียว
สิ่งสำคัญอีกประการคือการแยกงานวิจัย SCNet ออกจากเช็กพอยต์ Huge-SCNet-4stems V1.2 งานวิจัยมอบสถาปัตยกรรมการบีบอัดแบบเบาบาง การออกแบบย่านย่อย และผลวิจัยบน MUSDB18-HQ ส่วนอาร์ติแฟกต์ที่ดาวน์โหลดได้คือเช็กพอยต์ Hugging Face สาธารณะ huge_scnet_4stems_v1.2.ckpt เช็กพอยต์ชุมชนนี้ไม่อาจสืบทอดผล 9.0 dB บน MUSDB18-HQ ของงานวิจัยได้ เพราะข้อมูลและที่มาของการเผยแพร่ต่างกัน
ต้องแยกขอบเขตโค้ดออกจากกันด้วย ผู้เขียนงานวิจัยเผยแพร่ thuhcsi/SCNet เป็นคลังโค้ดการนำไปใช้อย่างเป็นทางการ แต่คลังระบุว่าโค้ดฝึกยังทำไม่เสร็จ และชี้ผู้อ่านไปยัง HTDemucs, Music-Source-Separation-Training และ SCNet-PyTorch ในฐานะเฟรมเวิร์กฝึกชั่วคราว ดังนั้นจึงควรบรรยาย Huge-SCNet-4stems V1.2 ว่าเป็นตัวเลือกเช็กพอยต์สี่สเต็มสาธารณะในสายทาง SCNet ไม่ใช่แพ็กเกจโมเดลทางการจากงานวิจัย SCNet
MVSep Ensemble ในฐานะเวิร์กโฟลว์ระดับแพลตฟอร์ม
MVSep Ensemble 2025.06.30 เป็นเวิร์กโฟลว์หลายโมเดลระดับแพลตฟอร์ม หน้าอัลกอริทึมสาธารณะระบุตระกูลโมเดลมากกว่าหนึ่งตระกูล เส้นทางเสียงร้องอาจใช้ UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL และแนวทางอื่น ส่วน bass, drums และ other อาจเรียกใช้ Demucs หรือโมเดลที่เกี่ยวข้องต่างชุดกัน
จุดแข็งของเอนเซมเบิลประเภทนี้มาจากความเชี่ยวชาญเฉพาะทาง กล่าวคือส่งวัตถุดิบที่เด่นด้านเสียงร้องให้ผู้เชี่ยวชาญเสียงร้อง ส่งวัตถุดิบที่เด่นด้านความถี่ต่ำและทรานเชียนต์ให้ตัวแยกเครื่องดนตรีที่แข็งแรงกว่า แล้วรวมผลเข้าด้วยกัน จึงใช้เป็นค่าอ้างอิงเพดานคุณภาพได้ แต่ไม่ใช่เช็กพอยต์หนึ่งชุดหรือโมเดลเดี่ยวที่ผู้ใช้ทำซ้ำได้ด้วยการดาวน์โหลดไฟล์เดียว
MVSep ระบุ SDR เฉลี่ยของเอนเซมเบิล 2025.06.30 ไว้ที่ 13.67 ตัวเลขนี้มีประโยชน์ในฐานะเพดานของแพลตฟอร์มแบบโฮสต์ แต่ไม่ควรวางในแถวเดียวกับเช็กพอยต์เดี่ยว เพราะสะท้อนเวิร์กโฟลว์ฝั่งเซิร์ฟเวอร์ที่ผสานเส้นทางเสียงร้อง เครื่องดนตรี bass, drums, other และเส้นทางเฉพาะเครื่องดนตรีเพิ่มเติมก่อนสร้างผลสุดท้ายได้
ด้วยเหตุนี้ การอภิปรายโมเดลสี่สเต็มเดี่ยวที่ดาวน์โหลดได้จึงต้องแยกเอนเซมเบิลระดับแพลตฟอร์มออกจากหมวดโมเดลเดี่ยว มิฉะนั้นการเปรียบเทียบจะเปลี่ยนจากสถาปัตยกรรมโมเดลเป็นเวิร์กโฟลว์แบบโฮสต์
การเปรียบเทียบสี่สเต็มสาธารณะ
ตารางด้านล่างใช้ตัวเลขจากหน้าโมเดลและหน้าเบนช์มาร์กสาธารณะที่อ้างถึง คะแนนช่วยระบุตำแหน่งของแต่ละโมเดลภายใต้เป้าหมายสี่สเต็มเดียวกัน ไม่ควรอ่านเป็นคำตัดสินเด็ดขาดสำหรับทุกเพลง ทุกแนว หรือทุกกรณีการฟัง
ขอบเขตแหล่งข้อมูลถูกจำกัดไว้อย่างตั้งใจ แถว 10.02 dB ของ Huge-SCNet-4stems V1.2 มาจากแหล่งอ้างอิง HF / MVSep สาธารณะ ส่วน SCNet XL IHF, BS Roformer และ HTDemucs4 ใช้แถว ZFTurbo / MVSep Multisong สาธารณะ นี่ไม่ใช่ตารางผสมระหว่างผล MUSDB18-HQ จากงานวิจัย SCNet หน้าเสียงร้อง Mel-Band และคะแนนเวิร์กโฟลว์แบบโฮสต์ของ MVSep Ensemble
วิธีอ่านคะแนน
SDR ที่สูงขึ้นโดยทั่วไปหมายถึงความเพี้ยนเทียบกับสเต็มอ้างอิงน้อยลง แต่ SDR เฉลี่ยใช้แทนการฟังไม่ได้ และไม่อาจทำให้ทุกสเต็มเหลือคำตอบเดียว โมเดลหนึ่งอาจแข็งแรงด้าน bass และ drums ขณะที่อีกโมเดลรักษา vocals ได้สะอาดกว่า other ยากเป็นพิเศษเพราะมีเครื่องดนตรีหลายชนิด
คุณค่าของ Huge-SCNet-4stems V1.2 อยู่ที่ขอบเขตอาร์ติแฟกต์อันชัดเจน ได้แก่ ชื่อเช็กพอยต์สาธารณะหนึ่งชื่อ เอาต์พุตสี่สเต็มมาตรฐาน และตัวเลขอ้างอิงสาธารณะที่ตรวจสอบย้อนกลับได้ SCNet XL IHF ยังคงเป็นตัวเปรียบเทียบสำคัญ ส่วน MVSep Ensemble ยังคงเป็นแหล่งอ้างอิงเพดานคุณภาพแบบโฮสต์ ทั้งสองตอบคนละคำถามกัน
ผู้ใช้ควรเริ่มจากเป้าหมาย ใช้การแยกเสียงร้องเมื่อต้องการเสียงร้องสะอาดที่สุด ใช้การแยกสี่สเต็มเมื่อต้องการ vocals, drums, bass และ other ที่นำไปแก้ไขได้ และใช้การแยกหกสเต็มเมื่อกีตาร์กับเปียโนต้องแยกเป็นคนละไฟล์
ขอบเขตเอาต์พุต: สมดุลสี่สเต็มเทียบกับรายละเอียดหกสเต็ม
การแยกหกสเต็มแบ่ง other ต่อเป็นกีตาร์ เปียโน และ other ที่เหลือ โดยไวต่อการดีดกีตาร์ การกระแทกโน้ตเปียโน พื้นผิวคีย์บอร์ด และฮาร์มอนิกความถี่สูงมากขึ้น เช็กพอยต์หกสเต็ม BS Roformer SW จึงมีเป้าหมายและสัญญาการฝึกต่างจาก Huge-SCNet-4stems V1.2
คำกล่าวเหล่านี้อยู่คนละชั้นกัน RoFormer อธิบายตระกูลสถาปัตยกรรม Mel-Band มุ่งที่ตัวแทนเสียงร้อง SCNet สร้างสมดุลสี่สเต็ม และเอนเซมเบิล MVSep ผสานองค์ประกอบที่โฮสต์ไว้ แต่ละแบบตอบคำถามต่างกันเกี่ยวกับสถาปัตยกรรม เป้าหมายเอาต์พุต การเข้าถึงแบบสาธารณะ รูปแบบเวิร์กโฟลว์ หรือสัญญาอินเฟอเรนซ์
บทสรุป: เลือกสถาปัตยกรรม ไม่ใช่คำยอดนิยม
การแยกสี่สเต็มไม่ใช่ดนตรีประกอบที่เปลี่ยนชื่อ และไม่ใช่พื้นที่สำหรับนำโมเดลเสียงร้องยอดนิยมที่สุดไปใช้กับเครื่องดนตรีทุกชิ้น โจทย์นี้กำหนดให้โมเดลสร้างสมดุลระหว่าง vocals, drums, bass และ other โดยเฉพาะทรานเชียนต์กลอง เสียงต่ำของเบส ฮาร์มอนิกสูงของเครื่องดนตรี และตะกร้าเครื่องดนตรีผสมภายใน other
Huge-SCNet-4stems V1.2 มีตำแหน่งชัดเจนรอบเป้าหมายสี่สเต็มมาตรฐานนี้ Mel-Band RoFormer ยังคงสำคัญต่อการทำความเข้าใจการแยกเสียงร้อง ส่วน MVSep Ensemble ยังคงมีประโยชน์ในฐานะแหล่งอ้างอิงคุณภาพแบบโฮสต์ แต่ละแบบอยู่คนละชั้นในประวัติศาสตร์การวิจัยและการนำไปใช้