Separazione audio a quattro stem: perché Huge-SCNet è adatto al target MSS · TelkNet
Modello
Separazione audio a quattro stem: perché Huge-SCNet è adatto al target MSS
Lo strumento TelkNet per quattro stem usa Huge-SCNet-4stems V1.2 per separare un mix completo in voci, batteria, basso e altro. L’articolo spiega la scelta tramite storia MSS, punti di forza e limiti di Mel-Band RoFormer, modellazione a sottobande SCNet e punteggi pubblici.
Novità sui modelli / Separazione delle sorgenti musicali
Data della notizia: 2026-06-30
Modello attuale a quattro stem: Huge-SCNet-4stems V1.2
Output standard: vocals / drums / bass / other
Tema: architettura MSS, limiti di Mel-Band RoFormer, compromessi di SCNet
Riepilogo
La separazione delle sorgenti musicali tramite IA ha superato la semplice domanda se sia possibile estrarre una voce da un mix. Per remix, campionamento, esercizio, Music-to-MIDI, audio spaziale e pulizia del materiale, la domanda utile è se il risultato rimanga modificabile. La separazione standard in quattro stem segue questo obiettivo più rigoroso: divide un mix completo in vocals, drums, bass e other, anziché produrre soltanto file vocali e di accompagnamento.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer e Huge-SCNet-4stems V1.2 rappresentano approcci diversi alla separazione in quattro stem. La sola qualità vocale non determina la qualità complessiva. Un ensemble di piattaforma può ottenere punteggi elevati senza essere un modello autonomo scaricabile, mentre un checkpoint pubblico offre un artefatto riproducibile.
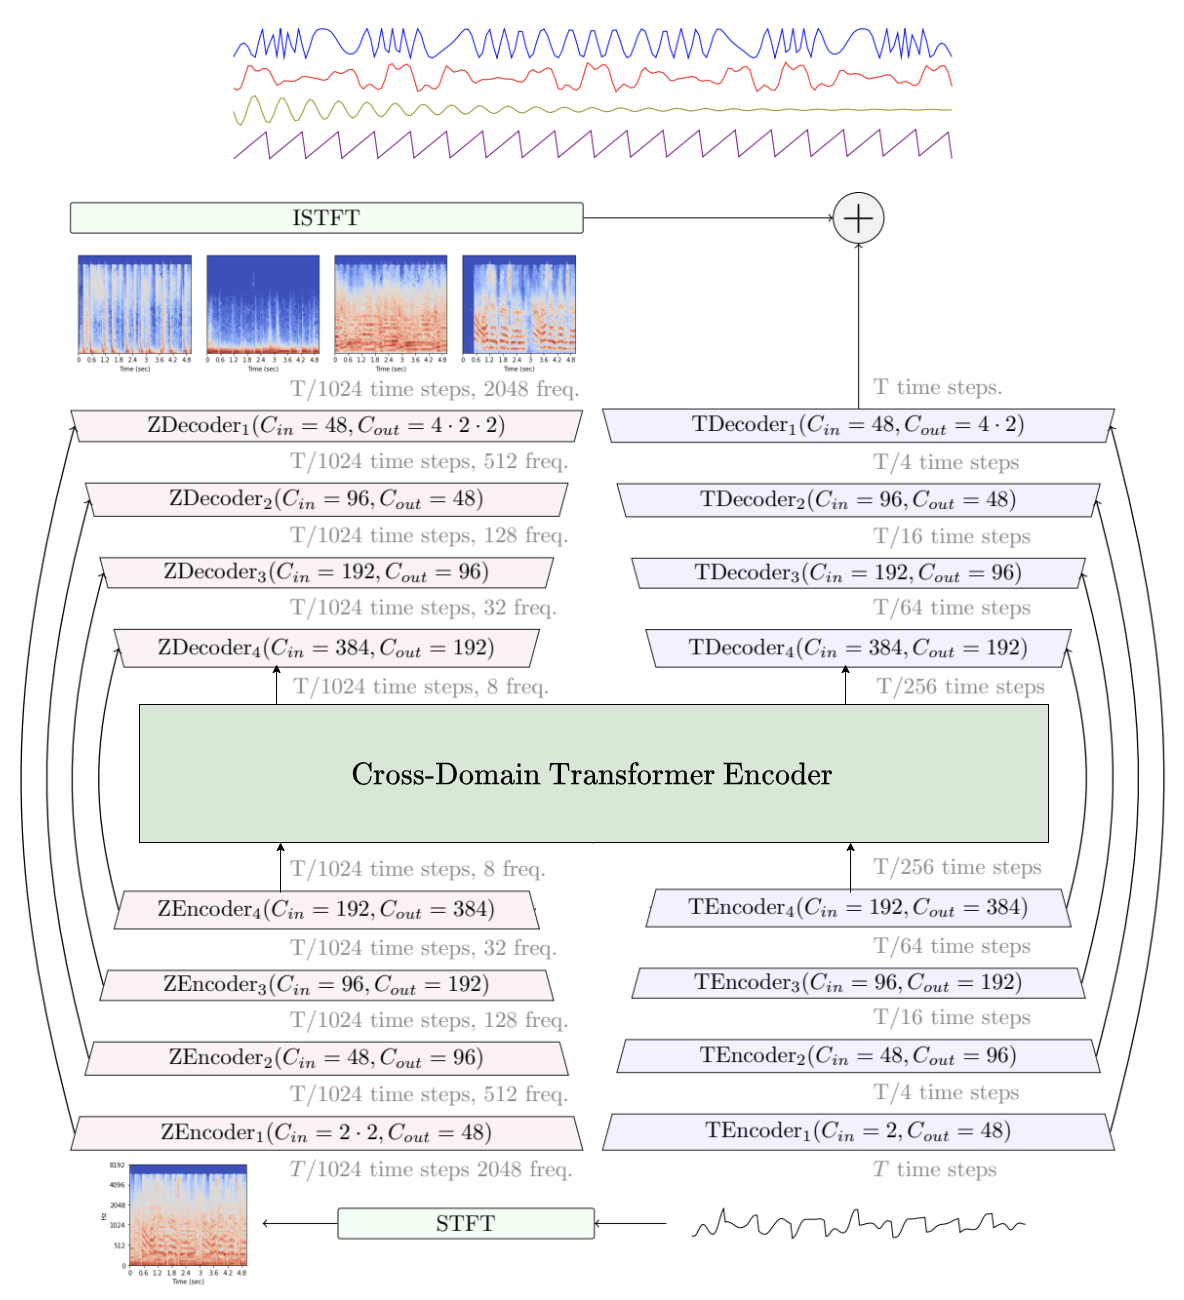
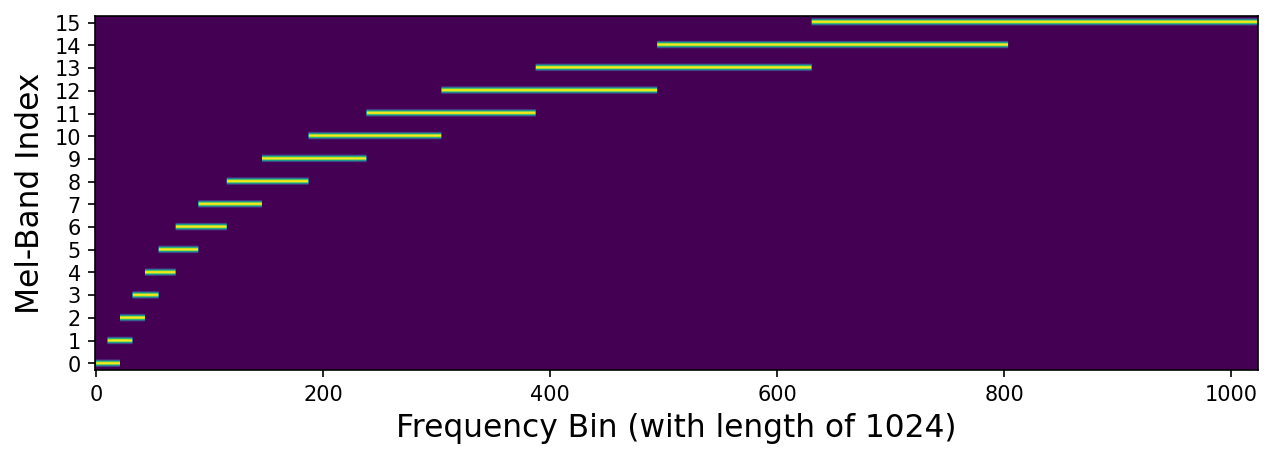
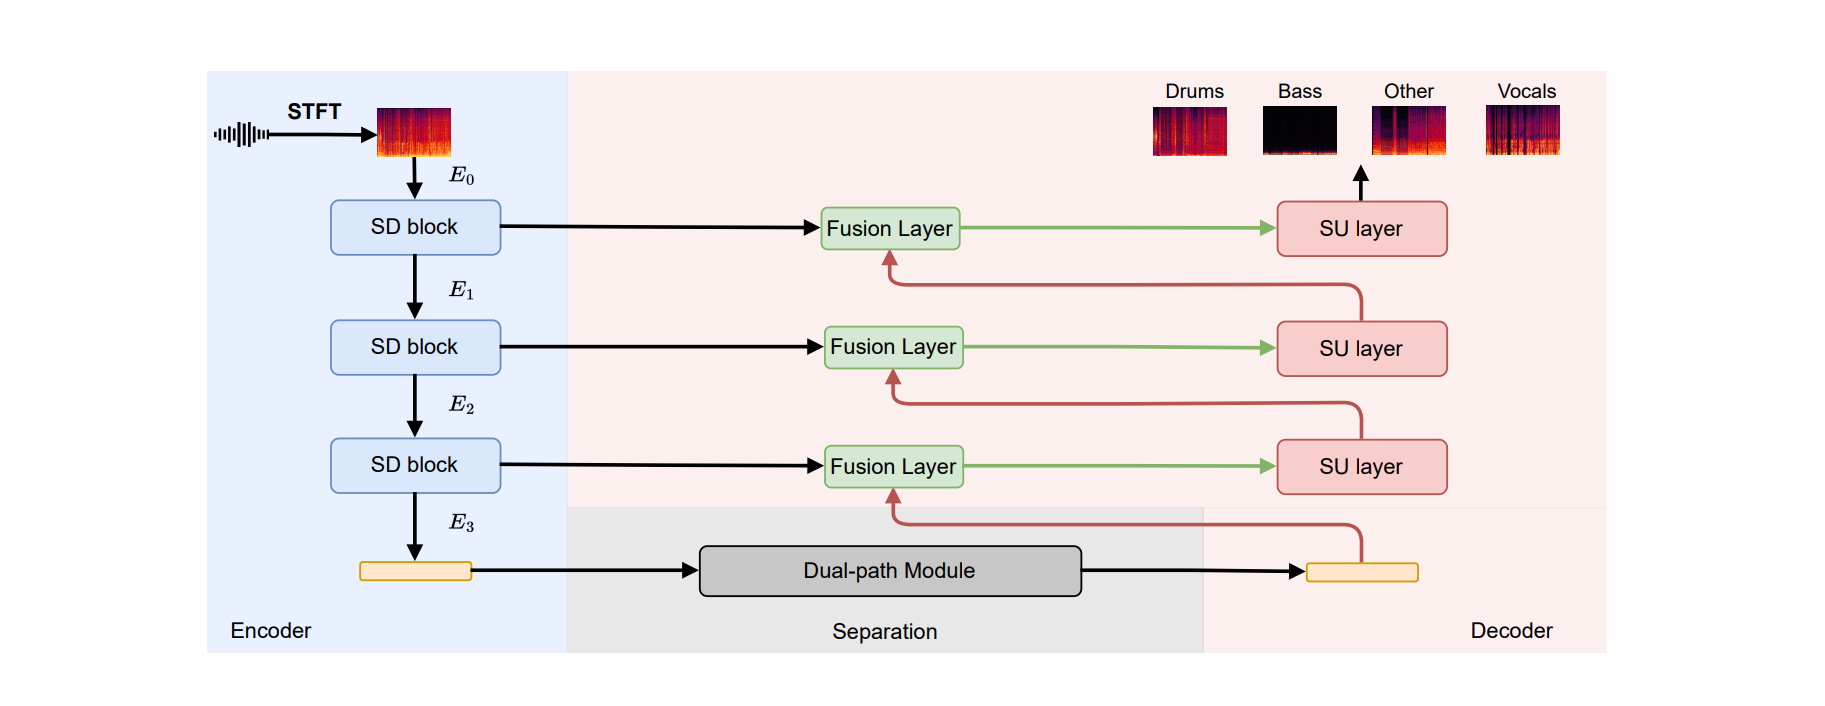
HTDemucs Il diagramma strutturale ufficiale dell'articolo: i due rami del dominio della forma d'onda e del dominio dello spettro convergono all'interno del modello. Il design rappresentativo della fase "doppio dominio" nella sequenza temporale seguente è simile a questo (fonte: documento Hybrid Transformers, arXiv:2211.08553).Mel-Band RoFormer Diagramma ufficiale del paper: come i contenitori spettrali vengono mappati su sottobande sovrapposte organizzate su scala mel. Le sottobande ottenute nella frequenza medio-bassa sono più dense, quindi i dettagli vocali sono espressi in modo più fine (fonte: arXiv:2310.01809).Diagramma dell'architettura ufficiale del documento SCNet: la posizione del modulo di compressione sparsa tra il codificatore e la rete di separazione è chiara a colpo d'occhio: comprime prima le aree a bassa densità di informazioni e poi lascia la potenza di calcolo agli affollati confini vocali (fonte: documento SCNet, arXiv:2401.13276).
Le pagine pubbliche degli algoritmi e le classifiche di MVSep sono riferimenti comuni nella separazione delle sorgenti musicali. Documentano risultati e configurazioni; un workflow ensemble non va interpretato come un singolo modello autonomo.
Quattro stem non sono un altro nome per le tracce di accompagnamento
La separazione standard in quattro stem indica in genere vocals, drums, bass e other. Vocals è la traccia cantata, drums la batteria, bass la parte di basso, mentre other raccoglie gli strumenti restanti: chitarra, pianoforte, archi, sintetizzatori, ottoni, effetti e altro. La base che si ascolta dopo aver silenziato la voce è in realtà la somma di drums, bass e other.
Questo obiettivo deriva dai principali dataset e dalla tradizione di valutazione della separazione delle sorgenti musicali. MUSDB18 e MUSDB18-HQ hanno da tempo plasmato l’addestramento e la valutazione dei modelli attorno a questi quattro stem. Quando la comunità parla di 4-stem, di solito intende questo obiettivo di output.
La distinzione cambia la scelta dello strumento. Se l’obiettivo è una voce pulita o una base strumentale senza voce, un separatore vocale a due stem è più diretto. Se servono esercizio alla batteria, analisi del basso, campionamento, remix o pulizia di materiale modificabile, quattro stem sono più utili. Other non è una base più debole: è il contenitore strumentale più difficile del sistema.
Quattro fasi da U-Net a SCNet
La separazione delle sorgenti musicali tenta di recuperare più sorgenti da un’unica forma d’onda mixata nel tempo e nelle frequenze. I primi modelli potevano produrre risultati ascoltabili, ma gli artefatti erano noti: infiltrazioni vocali, rientro della batteria, basso impastato, alte frequenze sfumate o una fase lacerata negli arrangiamenti densi.
Periodo
Approccio rappresentativo
Progresso
Problema residuo
2020-2021
VR Architecture / U-Net
Ha trattato gli spettrogrammi come immagini, rendendo pratica la separazione basilare tra voce e accompagnamento.
Le finestre convoluzionali locali faticavano con il contesto musicale lungo e le relazioni di fase.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Ha combinato la modellazione della forma d’onda e dello spettrogramma, migliorando qualità e stabilità della ricostruzione.
Climax densi, forte riverbero e transienti complessi potevano ancora produrre artefatti.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Ha usato suddivisione in bande, RoPE e una modellazione tempo-frequenza più potente per voci, armonie, glissati e note sostenute.
Un’allocazione delle frequenze favorevole alla voce non è automaticamente la migliore per tutti gli strumenti dei quattro stem.
Ha usato modellazione a sottobande e compressione sparsa per concentrarsi sulle regioni tempo-frequenza ricche di informazioni.
L’obiettivo resta la separazione standard in quattro stem, non un output a sei stem o un ensemble di piattaforma.
Questa storia spiega perché la scelta del modello non può ridursi alla qualità vocale. La separazione in quattro stem deve preservare anche i transienti della batteria, fondamentali e armoniche del basso, confini vocali e dettagli ad alta frequenza contenuti in other.
Anche la cronologia è circoscritta alle fonti: il paper SCNet è stato pubblicato nel gennaio 2024, mentre Huge-SCNet-4stems V1.2 appartiene al successivo contesto dei checkpoint pubblici. Per questo la linea temporale usa 2024-2026, senza suggerire che SCNet stesso sia apparso solo dopo il 2025.
Mel-Band RoFormer: forza vocale e limiti nei quattro stem
Mel-Band RoFormer è stato proposto dal team Speech, Audio, and Music Intelligence (SAMI) di ByteDance. Gli autori del paper sono Ju-Chiang Wang, Wei-Tsung Lu e Minz Won; l’affiliazione sul frontespizio è indicata come SAMI, ByteDance. Le pagine della comunità talvolta riassumono questa linea come ByteDance AI Labs, ma la formulazione più precisa rispetto alla fonte è quella degli autori del paper e di SAMI, ByteDance.
Il modello è interessante perché modella le bande di frequenza in modo più vicino all’udito umano. L’orecchio è più sensibile alle frequenze basse e medie, dove si trovano fondamentali vocali, consonanti, respiro e molti indizi di altezza. La proiezione mel-band offre una rappresentazione più fine di quest’area, aiutando il modello a seguire voci principali e di accompagnamento, glissati, vibrato e code di riverbero.
La famiglia RoFormer usa l’encoding posizionale rotatorio, o RoPE, sia sulle sequenze temporali sia su quelle delle sottobande. I punteggi di attention dipendono così dalla posizione relativa. Glissati, note sostenute e frasi ripetute sono intuizioni strutturali utili per questa proprietà, ma il paper verifica direttamente solo modelli controllati con e senza RoPE; non riporta metriche separate per glissati o armonie lunghe.
Percorso del segnale definito nel paper
BS-RoFormer converte prima la forma d’onda del mix in uno spettrogramma complesso. La proiezione in bande e il Transformer gerarchico stimano una maschera complessa, che viene applicata allo spettro del mix; la STFT inversa ricostruisce quindi la forma d’onda obiettivo. Mel-RoFormer modifica la proiezione all’interno di fθ: bande mel sovrapposte sostituiscono la suddivisione euristica non sovrapposta. Non sostituisce l’intero percorso di ricostruzione.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: lo spettrogramma complesso del mix, comprese le componenti reale e immaginaria.
fθ: proiezione in bande, Transformer intra- e inter-banda e stima della maschera.
M̂: la maschera obiettivo complessa usata per recuperare magnitudine e fase.
ŷ: la forma d’onda ricostruita dalla STFT inversa e vincolata durante l’addestramento dalle loss sulla forma d’onda e sullo spettro.
Ecco perché Mel-Band RoFormer è un approccio solido per voce/accompagnamento, voce principale/cori ed estrazione vocale pulita. Il problema è che la separazione in quattro stem non riguarda soltanto la voce. Deve separare anche drums, bass e other, e other contiene spesso i dettagli strumentali ad alta frequenza più difficili.
Dopo i paper: come RoFormer è diventato un ecosistema aperto di strumenti
BS-RoFormer è apparso nel settembre 2023 con due tipi di evidenze nello stesso paper. Il sistema più grande L=12, addestrato su MUSDB18HQ più 500 brani interni, documentava la proposta di SAMI-ByteDance classificata al primo posto in SDX23. Modelli più piccoli limitati a MUSDB18HQ fornivano ablation controllate per RoPE, suddivisione in bande e ricostruzione overlap-and-average. Il paper pubblicava architettura, condizioni di addestramento e tabelle dei risultati. Non allegava il checkpoint SDX23 originale né collegava un repository ByteDance/SAMI per addestramento e inferenza.
Mel-Band RoFormer è seguito nell’ottobre 2023. Ha mantenuto Transformer RoPE, modellazione delle sequenze intra- e inter-banda, maschere complesse e ricostruzione della forma d’onda, ma ha sostituito la suddivisione manuale non sovrapposta con 60 bande mel sovrapposte. L’intervallo di un mese è importante: era una revisione pubblica della proiezione in frequenza, motivata dal limite dello stesso paper precedente, non un secondo pacchetto di checkpoint ufficiale pubblicato insieme al testo.
Il codice eseguibile si è accumulato fuori dai paper. Il repository lucidrains ha trasformato diagrammi ed equazioni in classi di modelli PyTorch e ha invitato apertamente altri a riprodurre il separatore. Gestione stereo, più stem di output e variante Mel-Band hanno reso la struttura riutilizzabile, ma il solo codice non poteva ricostruire i brani interni, lo stato dell’ottimizzatore, la durata dell’addestramento o i parametri finali della competizione.
Music-Source-Separation-Training ha poi dato a questa struttura riutilizzabile un laboratorio comune: loader dei dataset, augmentation, addestramento, validazione, ripresa dei checkpoint, inferenza a segmenti, sovrapposizione ed ensembling. Il README riconosce a lucidrains la ricreazione dei modelli RoFormer dai paper e accetta proposte di modelli della comunità. Una stessa architettura poteva ora essere addestrata per separazione voce/strumentale, quattro stem, sotto-stem di batteria o altri obiettivi specialistici. Non esisteva un unico peso comunitario canonico.
Il modello vocale di Kimberley Jensen ha reso concreto il processo. Il repository afferma che è stato addestrato su più dati con il codice di ZFTurbo, usa per impostazione predefinita un segmento di otto secondi ed espone num_overlap per ridurre gli artefatti di giunzione al costo di un’inferenza più lunga. Riconosce inoltre i contributori al dataset. Questi dettagli spiegano perché un checkpoint scaricabile possieda un carattere che il solo nome dell’architettura non può descrivere.
L’attuale pagina MVSep attribuisce a Kimberley Jensen i primi pesi pubblici di alta qualità, quindi descrive modifiche successive e ulteriore addestramento dei pesi aperti. Bas Curtiz, unwa, becruily, gabox e altre edizioni compaiono nella stessa pagina con compromessi diversi tra pienezza, bleed, rumore e SDR. È una genealogia ramificata dei pesi: i modelli condividono Mel-Band RoFormer, ma non dati, obiettivo, storia del fine-tuning o suono finale.
Sintesi basata sui due paper RoFormer, sull’implementazione lucidrains e sul framework di addestramento ZFTurbo/MVSep. Le frecce mostrano dipendenze di implementazione, non approvazioni ufficiali.
Nome o artefatto
Che cosa identifica
Che cosa richiede ancora una provenienza
BS-RoFormer / Mel-Band RoFormer
Proiezione in bande, RoPE e progetto di modellazione sequenziale assiale.
Chi ha addestrato il checkpoint concreto, i dati, gli stem obiettivo e il set di valutazione.
Un file di checkpoint scaricabile
Un set di parametri che normalmente dipende da una configurazione corrispondente.
Se proviene dagli autori del paper, dall’addestramento della comunità o da un fine-tuning successivo.
Un workflow Mel-Band / BS-RoFormer ospitato
Il servizio ha scelto pesi, segmentazione, sovrapposizione e output.
I punteggi del workflow ospitato non possono essere rinominati come risultati SDX23 o del paper originale.
Un nome di architettura può ora indicare un sistema da competizione, un’ablation di un paper, un checkpoint vocale, un checkpoint a quattro stem o un ensemble di piattaforma. Un testo accurato deve esporre tre elementi: chi ha proposto l’architettura, da dove provengono i pesi attuali e quale ricetta di inferenza produce il risultato. Senza tutti e tre, espressioni come «modello ByteDance ufficiale» o «punteggio da competizione Mel-Band a quattro stem» uniscono silenziosamente artefatti diversi provenienti da momenti differenti di questa storia.
Confronto controllato: Mel non sostituisce BS su ogni stem
L’evidenza più chiara è il confronto controllato del paper Mel-Band del 2023, non un insieme di pagine MVSep e checkpoint comunitari non correlati. Ogni riga seguente usa MUSDB18HQ senza brani aggiuntivi. A parità di profondità, il cambiamento principale è la proiezione: le bande euristiche non sovrapposte di BS-RoFormer vengono sostituite da 60 bande mel sovrapposte.
Il risultato è un compromesso, non una vittoria totale. A L=6, vocals sale da 10.78 a 11.21 dB e drums da 9.61 a 9.91 dB, mentre bass scende da 11.43 a 9.64 dB e other cala leggermente da 7.86 a 7.81 dB. A L=9, vocals guadagna 0.58 dB e other 0.13 dB, drums perde 0.32 dB, mentre bass non è riportato perché l’addestramento procedeva troppo lentamente.
Modello del paper (MUSDB18HQ, senza dati aggiuntivi)
Vocals
Bass
Drums
Other
SDR medio
Parametri
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
non riportato
9.34
7.93
non riportato
94.8M
Il paper collega il risultato sul basso alla mappatura delle frequenze. BS-RoFormer assegna deliberatamente bande fini alle basse frequenze, mentre la proiezione mel è più utile per le voci e alcuni obiettivi diversi dal basso. La conclusione ingegneristica dipende quindi dal compito: la proiezione mel è una scelta vocale forte, ma la sola motivazione psicoacustica non dimostra il predominio sui quattro stem.
SCNet e l’obiettivo a quattro stem
SCNet adotta una visione dello spettro più orientata all’informazione. Tra gli autori del paper figurano Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu e Helen Meng; il frontespizio elenca tra le affiliazioni Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab e The Chinese University of Hong Kong. Dal punto di vista architetturale, SCNet divide esplicitamente lo spettrogramma del mix in sottobande e usa la compressione sparsa per gestirne le diverse densità di informazione. In termini semplici, non concentra quasi tutta la capacità sulla gamma vocale. Spinge il modello a focalizzarsi sulle regioni tempo-frequenza che contengono davvero un segnale strumentale utile.
Questo è importante per quattro stem. Il basso occupa le frequenze basse ma contiene armoniche rilevanti. La batteria combina transienti molto brevi con piatti e suono ambientale. Other può contenere contemporaneamente chitarra, pianoforte, archi, sintetizzatori ed effetti. La modellazione a sottobande offre un trattamento più mirato alle diverse regioni di frequenza, mentre la compressione sparsa evita di dedicare attention alle aree vuote o povere di informazione.
Il paper SCNet descrive il sistema completo come un audio encoder, una rete di separazione basata su dual-path RNN e un audio decoder. L’encoder mappa il mix in rappresentazioni a sottobande nel dominio delle frequenze, la rete di separazione modella la struttura nel tempo e nelle frequenze, quindi il decoder ricostruisce gli stem obiettivo.
Huge-SCNet-4stems V1.2 appartiene a questo approccio. Il suo contratto di output è un insieme bilanciato di file vocals, drums, bass e other, utilizzabili in seguito per remix o trascrizione, invece di un obiettivo ottimizzato soltanto per la voce.
È inoltre importante distinguere il paper SCNet dal checkpoint Huge-SCNet-4stems V1.2. Il paper fornisce l’architettura di compressione sparsa, il progetto delle sottobande e il risultato di ricerca MUSDB18-HQ; l’artefatto scaricabile è il checkpoint pubblico Hugging Face huge_scnet_4stems_v1.2.ckpt. Questo checkpoint comunitario non può ereditare il risultato di 9.0 dB su MUSDB18-HQ del paper, perché dati e provenienza della pubblicazione sono diversi.
Anche il confine del codice va mantenuto separato. Gli autori del paper pubblicano thuhcsi/SCNet come repository ufficiale dell’implementazione, ma il repository afferma che il codice di addestramento deve ancora essere completato e rimanda temporaneamente a HTDemucs, Music-Source-Separation-Training e SCNet-PyTorch come framework di addestramento. Huge-SCNet-4stems V1.2 va quindi descritto come scelta di checkpoint pubblico a quattro stem lungo il percorso SCNet, non come pacchetto di modello ufficiale del paper SCNet.
MVSep Ensemble come workflow di piattaforma
MVSep Ensemble 2025.06.30 rappresenta un workflow multimodello a livello di piattaforma. La pagina pubblica dell’algoritmo elenca più famiglie di modelli. Il percorso vocale può usare UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL e altri approcci, mentre bass, drums e other possono richiamare diversi Demucs o modelli correlati.
La forza di questo tipo di ensemble deriva dalla specializzazione: assegna il materiale ricco di voce agli specialisti vocali, quello ricco di basse frequenze e transienti a separatori strumentali più forti, quindi fonde i risultati. Può essere un riferimento per il tetto qualitativo, ma non è un singolo checkpoint né un modello autonomo che un utente possa riprodurre scaricando un solo file.
MVSep indica per l’ensemble del 2025.06.30 un SDR medio di 13.67. Il valore è utile come limite superiore di una piattaforma ospitata, ma non va collocato nella stessa riga di un checkpoint autonomo. Riflette un workflow lato server che può combinare percorsi vocali, strumentali, bass, drums, other e altri percorsi specifici per strumento prima di produrre il risultato finale.
Per questo, quando si parla di un singolo modello a quattro stem scaricabile, gli ensemble di piattaforma devono restare fuori dalla categoria dei modelli singoli. Altrimenti il confronto si sposta dall’architettura del modello al workflow ospitato.
Confronto pubblico tra modelli a quattro stem
La tabella seguente usa valori tratti dalle pagine pubbliche citate dei modelli e dei benchmark. I punteggi aiutano a collocare ogni modello sotto lo stesso obiettivo a quattro stem. Non vanno letti come un verdetto assoluto per ogni brano, genere o caso di ascolto.
L’ambito delle fonti è volutamente ristretto: la riga da 10.02 dB di Huge-SCNet-4stems V1.2 proviene dal riferimento pubblico HF / MVSep; SCNet XL IHF, BS Roformer e HTDemucs4 usano righe pubbliche ZFTurbo / MVSep Multisong. Non è una tabella mista di risultati MUSDB18-HQ del paper SCNet, pagine vocali Mel-Band e punteggi del workflow ospitato MVSep Ensemble.
Modello
SDR medio
Vocals
Drums
Bass
Other
Come interpretarlo
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Checkpoint pubblico Huge-SCNet a quattro stem nella tabella di riferimento citata.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Solido candidato autonomo a quattro stem, soprattutto per batteria e basso.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Utile riferimento a quattro stem per l’approccio RoFormer con suddivisione in bande.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Baseline classica e matura, ma non il limite della qualità attuale a quattro stem.
Come leggere i punteggi
Un SDR più alto indica in genere una minore distorsione rispetto allo stem di riferimento. Tuttavia, l’SDR medio non può sostituire l’ascolto né appiattire ogni stem in un’unica risposta. Un modello può essere forte su basso e batteria, mentre un altro mantiene più pulite le voci. Other è particolarmente difficile perché contiene molti strumenti.
Il valore di Huge-SCNet-4stems V1.2 è il suo chiaro confine di artefatto: un nome di checkpoint pubblico, un output standard a quattro stem e valori pubblici di riferimento tracciabili. SCNet XL IHF resta un confronto importante. MVSep Ensemble resta un riferimento ospitato per il tetto qualitativo. Rispondono a domande diverse.
Gli utenti dovrebbero partire dall’obiettivo. Usare la separazione vocale per ottenere la voce più pulita. Usare la separazione in quattro stem per vocals, drums, bass e other modificabili. Usare la separazione in sei stem quando chitarra e pianoforte devono avere file distinti.
Confine dell’output: equilibrio a quattro stem contro dettaglio a sei stem
La separazione in sei stem divide ulteriormente other in chitarra, pianoforte e other residuo. È più sensibile a pennate di chitarra, attacchi di pianoforte, texture di tastiera e armoniche ad alta frequenza. Un checkpoint BS Roformer SW a sei stem rappresenta quindi un obiettivo e un contratto di addestramento diversi da Huge-SCNet-4stems V1.2.
Queste affermazioni appartengono a livelli separati: RoFormer descrive una famiglia di architetture, Mel-Band mira alla rappresentazione vocale, SCNet bilancia quattro stem e gli ensemble MVSep combinano componenti ospitati. Ciascuno risponde a una domanda diversa su architettura, obiettivo di output, disponibilità pubblica, forma del workflow o contratto di inferenza.
Conclusione: scegliere l’architettura, non la parola di moda
La separazione in quattro stem non è una base rinominata né un luogo dove applicare il modello vocale più popolare a ogni strumento. Chiede al modello di bilanciare vocals, drums, bass e other, in particolare transienti della batteria, basse frequenze del basso, armoniche strumentali alte e il contenitore misto di strumenti dentro other.
Huge-SCNet-4stems V1.2 occupa una posizione chiara attorno a questo obiettivo standard a quattro stem. Mel-Band RoFormer resta importante per comprendere la separazione vocale, mentre MVSep Ensemble rimane utile come riferimento qualitativo ospitato. Ciascuno appartiene a un livello diverso della storia della ricerca e della distribuzione.