Four-Stem-Audiotrennung: warum Huge-SCNet zum MSS-Ziel passt · TelkNet
Modell
Four-Stem-Audiotrennung: warum Huge-SCNet zum MSS-Ziel passt
Das aktuelle TelkNet-Werkzeug für vier Stems nutzt Huge-SCNet-4stems V1.2, um einen kompletten Mix in Vocals, Drums, Bass und Other zu trennen. Der Artikel erklärt die Wahl über MSS-Architektur, Mel-Band-RoFormer-Grenzen, SCNet-Subband-Modellierung und öffentliche Vier-Stem-Werte.
Thema: MSS-Architektur, Grenzen von Mel-Band RoFormer, Abwägungen bei SCNet
Zusammenfassung
Die KI-gestützte Musikquellentrennung ist über die einfache Frage hinausgegangen, ob sich eine Gesangsspur aus einem Mix herauslösen lässt. Für Remixe, Sampling, Übung, Music-to-MIDI, räumliches Audio und die Bereinigung von Material ist entscheidend, ob das Ergebnis weiter bearbeitet werden kann. Die standardmäßige Vier-Stem-Trennung verfolgt dieses strengere Ziel: Sie teilt einen vollständigen Mix in vocals, drums, bass und other, statt lediglich Gesangs- und Begleitdateien zu erzeugen.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer und Huge-SCNet-4stems V1.2 stehen für unterschiedliche Vier-Stem-Ansätze. Die Gesangsleistung allein bestimmt nicht die Qualität einer Vier-Stem-Trennung. Ein Plattform-Ensemble kann hohe Werte erreichen, ohne ein herunterladbares Einzelmodell zu sein, während ein öffentlicher Checkpoint ein reproduzierbares Artefakt bereitstellt.
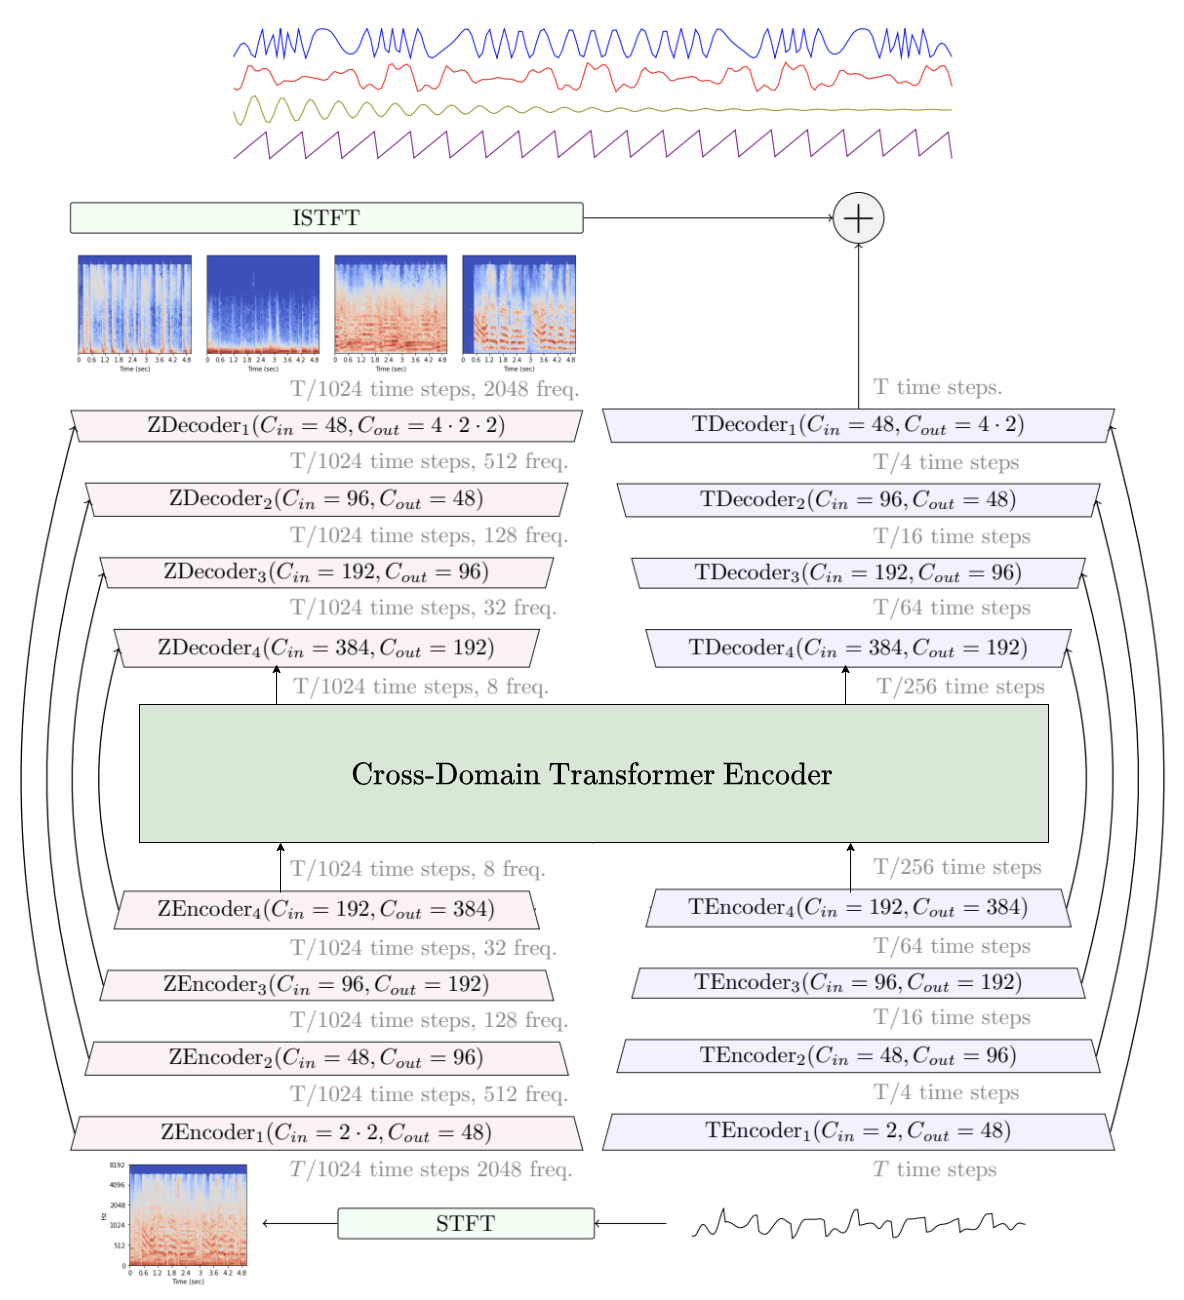
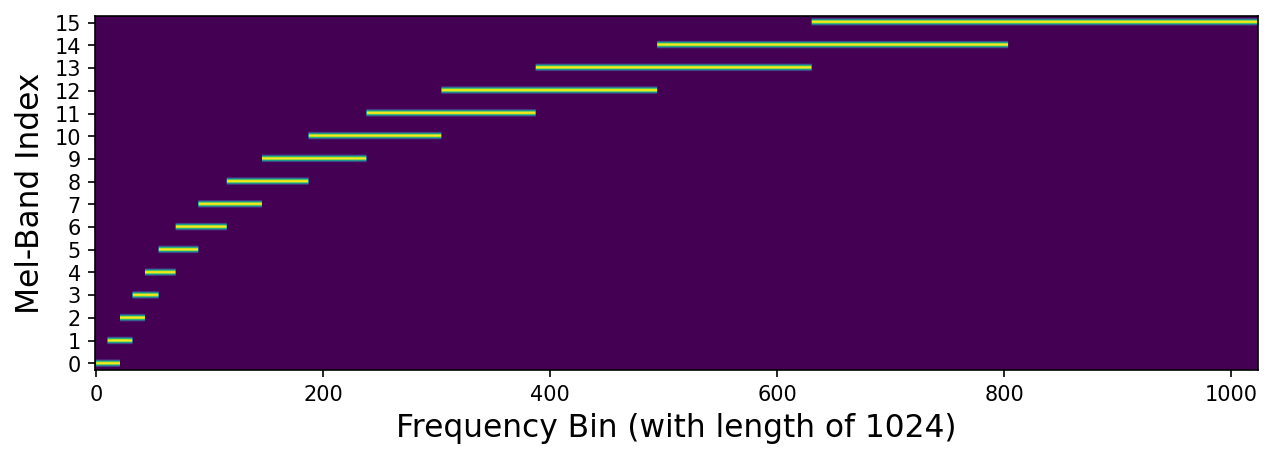
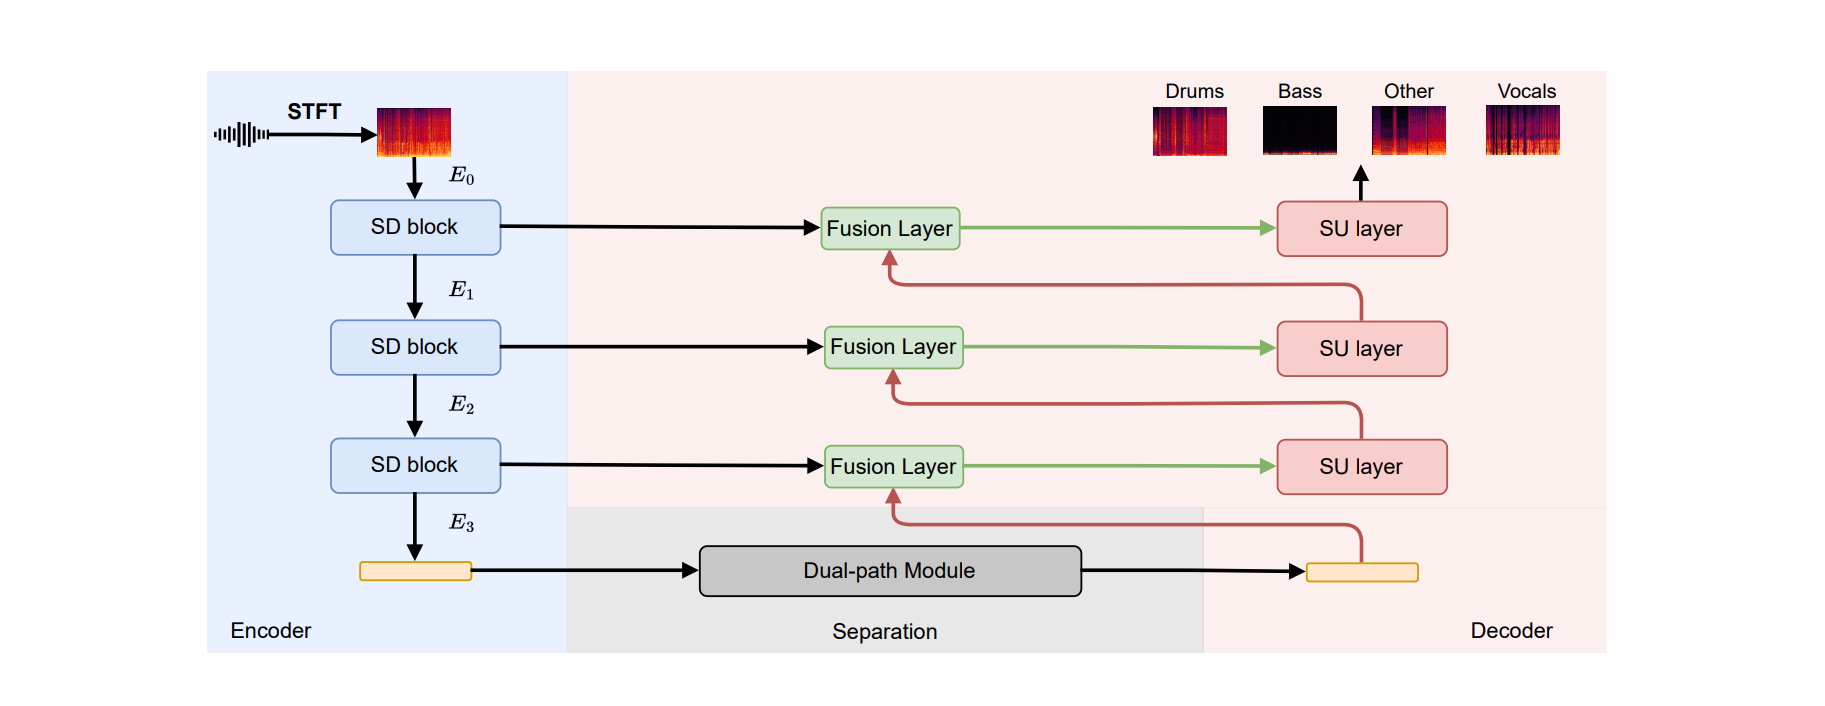
HTDemucs Das offizielle Strukturdiagramm des Papiers: Die beiden Zweige der Wellenformdomäne und der Spektrumdomäne laufen innerhalb des Modells zusammen. Das repräsentative Design der „Dual Domain“-Stufe in der Zeitleiste unten sieht folgendermaßen aus (Quelle: Hybrid Transformers-Papier, arXiv:2211.08553).Offizielles Diagramm des Mel-Band RoFormer Papers: Wie Spektralbereiche überlappenden Teilbändern zugeordnet werden, die auf einer Mel-Skala organisiert sind. Die im mittleren bis tiefen Frequenzbereich erhaltenen Teilbänder sind dichter, sodass die Gesangsdetails detaillierter ausgedrückt werden (Quelle: arXiv:2310.01809).Offizielles Architekturdiagramm des SCNet-Papiers: Die Position des Sparse-Komprimierungsmoduls zwischen dem Encoder und dem Trennungsnetzwerk ist auf einen Blick klar: Zuerst werden Bereiche mit geringer Informationsdichte komprimiert und dann wird die Rechenleistung den überfüllten Sprachgrenzen überlassen (Quelle: SCNet-Papier, arXiv:2401.13276).
Die öffentlichen Algorithmusseiten und Ranglisten von MVSep sind verbreitete Bezugspunkte in der Musikquellentrennung. Sie dokumentieren Ergebnisse und Konfigurationen; ein Ensemble-Workflow darf nicht als ein einzelnes eigenständiges Modell verstanden werden.
Vier Stems sind kein anderer Name für Begleitspuren
Die standardmäßige Vier-Stem-Trennung bezeichnet gewöhnlich vocals, drums, bass und other. Vocals ist die Gesangsspur, drums das Schlagzeug, bass die Bassstimme, und other enthält die übrigen Instrumente: Gitarre, Klavier, Streicher, Synthesizer, Blechbläser, Effekte und mehr. Die Begleitung, die nach dem Stummschalten des Gesangs zu hören ist, besteht tatsächlich aus der Summe von drums, bass und other.
Dieses Ziel stammt aus den wichtigsten Datensätzen und der Bewertungstradition der Musikquellentrennung. MUSDB18 und MUSDB18-HQ prägen seit Langem Training und Bewertung von Modellen rund um diese vier Stems. Wenn die Community von 4-stem spricht, meint sie gewöhnlich dieses Ausgabeziel.
Die Unterscheidung verändert die Werkzeugwahl. Wenn eine saubere Gesangsspur oder ein Instrumental ohne Gesang das Ziel ist, ist ein Zwei-Stem-Gesangstrenner direkter. Geht es um Schlagzeugübungen, Bassanalyse, Sampling, Remixe oder die Bereinigung von weiter bearbeitbarem Material, sind vier Stems nützlicher. Other ist keine schwächere Begleitspur, sondern der schwierigste Instrumentenkorb des Systems.
Vier Entwicklungsstufen von U-Net bis SCNet
Bei der Musikquellentrennung wird versucht, mehrere Quellen aus einer gemischten Wellenform über Zeit und Frequenz hinweg wiederherzustellen. Frühere Modelle konnten hörbare Ergebnisse erzeugen, doch die Artefakte waren bekannt: durchdringender Gesang, Übersprechen des Schlagzeugs, verwaschener Bass, verschmierte hohe Frequenzen oder eine zerrissene Phasenqualität in dichten Arrangements.
Zeitraum
Repräsentativer Ansatz
Fortschritt
Verbleibendes Problem
2020-2021
VR Architecture / U-Net
Spektrogramme wurden wie Bilder behandelt, wodurch eine grundlegende Trennung von Gesang und Begleitung praktisch einsetzbar wurde.
Lokale Faltungsfenster hatten Schwierigkeiten mit langem musikalischem Kontext und Phasenbeziehungen.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Wellenform- und Spektrogrammmodellierung wurden kombiniert, wodurch Rekonstruktionsqualität und Stabilität stiegen.
Dichte Höhepunkte, starker Nachhall und komplexe Transienten konnten weiterhin Artefakte erzeugen.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Bandaufteilung, RoPE und eine stärkere Zeit-Frequenz-Modellierung wurden für Gesang, Harmonien, Glissandi und gehaltene Töne eingesetzt.
Eine auf Gesang ausgerichtete Frequenzzuweisung ist nicht automatisch für alle Instrumente einer Vier-Stem-Trennung optimal.
Subbandmodellierung und Sparse Compression richten die Verarbeitung auf informationsreiche Zeit-Frequenz-Bereiche.
Das Ziel bleibt die standardmäßige Vier-Stem-Trennung, nicht die Ausgabe von sechs Stems oder ein Plattform-Ensemble.
Diese Entwicklung erklärt, warum die Modellauswahl nicht auf die Gesangsqualität reduziert werden kann. Eine Vier-Stem-Trennung muss auch Schlagzeugtransienten, Grundtöne und Obertöne des Basses, Gesangsgrenzen sowie die hochfrequenten Details in other bewahren.
Auch die zeitliche Einordnung bleibt an die Quelle gebunden: Die SCNet-Arbeit erschien im Januar 2024 öffentlich, während Huge-SCNet-4stems V1.2 in den späteren Kontext öffentlicher Checkpoints gehört. Deshalb verwendet diese Zeitleiste 2024-2026, statt anzudeuten, SCNet selbst sei erst nach 2025 erschienen.
Mel-Band RoFormer: Stärken beim Gesang und Grenzen bei vier Stems
Mel-Band RoFormer wurde vom Team Speech, Audio, and Music Intelligence (SAMI) von ByteDance vorgeschlagen. Die Autoren der Arbeit sind Ju-Chiang Wang, Wei-Tsung Lu und Minz Won; auf der Titelseite wird als Zugehörigkeit SAMI, ByteDance genannt. Community-Seiten fassen diese Linie mitunter als ByteDance AI Labs zusammen, doch die genaueste Quellenangabe sind die Autoren der Arbeit und SAMI, ByteDance.
Das Modell ist attraktiv, weil es die Frequenzbänder näher am menschlichen Hören formt. Das Ohr reagiert empfindlicher auf tiefe und mittlere Frequenzen, in denen Grundtöne des Gesangs, Konsonanten, Atemgeräusche und viele Tonhöhenhinweise liegen. Die Mel-Band-Projektion stellt diesen Bereich feiner dar und hilft dem Modell, Lead- und Begleitgesang, Glissandi, Vibrato und Nachhallfahnen zu verfolgen.
Die RoFormer-Familie verwendet Rotary Position Encoding, kurz RoPE, sowohl für die Zeit- als auch für die Subbandsequenzen. Dadurch hängen die Attention-Werte von der relativen Position ab. Glissandi, gehaltene Töne und wiederholte Phrasen bieten eine nützliche strukturelle Anschauung dieser Eigenschaft, doch die Arbeit testet direkt nur kontrollierte Modelle mit und ohne RoPE; getrennte Messwerte für Glissandi oder lange Harmonien werden nicht berichtet.
Der in der Arbeit definierte Signalweg
BS-RoFormer wandelt die gemischte Wellenform zunächst in ein komplexes Spektrogramm um. Seine Bandprojektion und der hierarchische Transformer schätzen eine komplexe Maske, diese Maske wird auf das gemischte Spektrum angewendet, und die inverse STFT rekonstruiert die Zielwellenform. Mel-RoFormer verändert die Projektion innerhalb von fθ: Überlappende Mel-Bänder ersetzen die heuristische, nicht überlappende Aufteilung. Der gesamte Rekonstruktionsweg wird dadurch nicht ersetzt.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: das komplexe Spektrogramm des Mixes einschließlich Real- und Imaginärkomponenten.
fθ: Bandprojektion, Transformer innerhalb und zwischen den Bändern sowie Maskenschätzung.
M̂: die komplexe Zielmaske zur Wiederherstellung von Betrag und Phase.
ŷ: die durch inverse STFT rekonstruierte Wellenform, die während des Trainings durch Wellenform- und Spektralverluste eingeschränkt wird.
Deshalb ist Mel-Band RoFormer ein starker Ansatz für Gesang/Begleitung, Lead-/Begleitgesang und die saubere Extraktion von Gesang. Das Problem ist, dass es bei der Vier-Stem-Trennung nicht nur um Gesang geht. Auch drums, bass und other müssen getrennt werden, wobei other häufig die schwierigsten hochfrequenten Instrumentendetails enthält.
Nach den Arbeiten: Wie RoFormer zu einem offenen Werkzeug-Ökosystem wurde
BS-RoFormer erschien im September 2023 mit zwei Arten von Belegen in einer Arbeit. Das größere System L=12, das mit MUSDB18HQ und 500 internen Songs trainiert wurde, dokumentierte den erstplatzierten SDX23-Beitrag von SAMI-ByteDance. Kleinere Modelle ausschließlich für MUSDB18HQ lieferten kontrollierte Ablationen zu RoPE, Bandaufteilung und Rekonstruktion durch Overlap-and-Average. Die Arbeit veröffentlichte Architektur, Trainingsbedingungen und Ergebnistabellen. Sie enthielt jedoch weder den ursprünglichen SDX23-Checkpoint noch einen Verweis auf ein Trainings- und Inferenz-Repository von ByteDance/SAMI.
Mel-Band RoFormer folgte im Oktober 2023. RoPE-Transformer, Sequenzmodellierung innerhalb und zwischen den Bändern, komplexe Masken und Wellenformrekonstruktion blieben erhalten, doch die manuell entworfene, nicht überlappende Aufteilung wurde durch 60 überlappende Mel-Bänder ersetzt. Der Abstand von einem Monat ist bedeutsam: Es handelte sich um eine öffentliche Überarbeitung der Frequenzprojektion, die aus einer in der früheren Arbeit benannten Einschränkung hervorging, und nicht um ein zweites offizielles Checkpoint-Paket, das zusammen mit dem Text veröffentlicht wurde.
Ausführbarer Code entstand außerhalb der Arbeiten. Das Repository von lucidrains überführte Diagramme und Gleichungen in PyTorch-Modellklassen und lud andere ausdrücklich ein, den Trenner zu reproduzieren. Stereoverarbeitung, mehrere Ausgabestems und die Mel-Band-Variante machten die Struktur wiederverwendbar, doch Code allein konnte weder die internen Songs noch Optimiererzustand, Trainingsdauer oder endgültige Wettbewerbsparameter rekonstruieren.
Music-Source-Separation-Training stellte dieser wiederverwendbaren Struktur anschließend eine gemeinsame Werkstatt bereit: Datensatzlader, Augmentation, Training, Validierung, Fortsetzung von Checkpoints, segmentierte Inferenz, Überlappung und Ensembling. Die README nennt lucidrains für die Rekonstruktion der RoFormer-Modelle aus den Arbeiten und nimmt Community-Modelle an. Eine Architektur konnte nun für Gesang/Instrumental, vier Stems, Schlagzeug-Unterstems oder andere Spezialziele trainiert werden. Ein einziges kanonisches Community-Gewicht gab es nicht.
Das Gesangsmodell von Kimberley Jensen machte diesen Prozess konkret. Laut Repository wurde es mit ZFTurbos Code auf mehr Daten trainiert, verwendet standardmäßig einen achtsekündigen Abschnitt und stellt num_overlap bereit, um Verbindungsartefakte auf Kosten einer längeren Inferenz zu verringern. Außerdem werden die Beitragenden zum Datensatz genannt. Diese Details erklären, warum ein herunterladbarer Checkpoint einen Charakter besitzt, den ein Architekturname allein nicht beschreiben kann.
Die aktuelle MVSep-Seite schreibt die ersten hochwertigen öffentlichen Gewichte Kimberley Jensen zu und beschreibt anschließend spätere Änderungen und das fortgesetzte Training der offenen Gewichte. Bas Curtiz, unwa, becruily, gabox und weitere Editionen erscheinen auf derselben Seite mit unterschiedlichen Abwägungen bei Fülle, Übersprechen, Rauschen und SDR. Dies ist eine verzweigte Gewichtsgenealogie: Die Modelle teilen Mel-Band RoFormer, nicht aber ihre Daten, Ziele, Fine-Tuning-Verläufe oder den endgültigen Klang.
Zusammenfassung auf Grundlage der beiden RoFormer-Arbeiten, der Implementierung von lucidrains und des Trainingsframeworks von ZFTurbo/MVSep. Die Pfeile zeigen Implementierungsabhängigkeiten und keine offizielle Bestätigung.
Name oder Artefakt
Was damit identifiziert wird
Wofür weiterhin ein Herkunftsnachweis nötig ist
BS-RoFormer / Mel-Band RoFormer
Bandprojektion, RoPE und axiales Sequenzmodellierungsdesign.
Der konkrete Checkpoint-Trainer, die Daten, Ziel-Stems und der Bewertungssatz.
Eine herunterladbare Checkpoint-Datei
Ein Parametersatz, der gewöhnlich von einer passenden Konfiguration abhängt.
Ob er von den Autoren der Arbeit, aus Community-Training oder späterem Fine-Tuning stammt.
Ein gehosteter Mel-Band-/BS-RoFormer-Workflow
Der Dienst hat Gewichte, Segmentierung, Überlappung und Ausgaben ausgewählt.
Werte des gehosteten Workflows dürfen nicht als SDX23- oder ursprüngliche Arbeitsergebnisse umbenannt werden.
Ein Architekturname kann heute ein Wettbewerbssystem, eine Ablation aus einer Arbeit, einen Gesangs-Checkpoint, einen Vier-Stem-Checkpoint oder ein Plattform-Ensemble bezeichnen. Eine genaue Beschreibung muss drei Dinge offenlegen: Wer die Architektur vorgeschlagen hat, woher die aktuellen Gewichte stammen und welches Inferenzrezept das Ergebnis liefert. Fehlt eine dieser Angaben, verbinden Formulierungen wie „offizielles ByteDance-Modell“ oder „Mel-Band-Vier-Stem-Wettbewerbswert“ stillschweigend unterschiedliche Artefakte aus verschiedenen Zeitpunkten dieser Entwicklung.
Kontrollierter Vergleich: Mel ersetzt BS nicht bei jedem Stem
Den saubersten Nachweis liefert der kontrollierte Vergleich in der Mel-Band-Arbeit von 2023, nicht eine Mischung aus MVSep-Seiten und unabhängigen Community-Checkpoints. Jede folgende Zeile verwendet MUSDB18HQ ohne zusätzliche Songs. Innerhalb jeder Tiefe ist die wichtigste Änderung die Projektion: Die heuristischen, nicht überlappenden Bänder von BS-RoFormer werden durch 60 überlappende Mel-Bänder ersetzt.
Das Ergebnis ist eine Abwägung, kein vollständiger Durchmarsch. Bei L=6 steigen vocals von 10.78 auf 11.21 dB und drums von 9.61 auf 9.91 dB, während bass von 11.43 auf 9.64 dB fällt und other leicht von 7.86 auf 7.81 dB sinkt. Bei L=9 gewinnt vocals 0.58 dB und other 0.13 dB, drums verliert 0.32 dB, und bass wird nicht berichtet, weil das Training zu langsam vorankam.
Modell der Arbeit (MUSDB18HQ, keine Zusatzdaten)
Vocals
Bass
Drums
Other
Durchschnittlicher SDR
Parameter
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
nicht berichtet
9.34
7.93
nicht berichtet
94.8M
Die Arbeit verbindet das Bassergebnis mit der Frequenzzuordnung. BS-RoFormer weist tiefen Frequenzen bewusst feine Bänder zu, während die Mel-Projektion für Gesang und einige Ziele außerhalb des Basses hilfreicher ist. Die nützliche technische Schlussfolgerung ist daher aufgabenspezifisch: Die Mel-Projektion ist eine starke Wahl für Gesang, doch eine psychoakustische Begründung allein beweist keine Überlegenheit bei vier Stems.
SCNet und das Vier-Stem-Ziel
SCNet betrachtet das Spektrum stärker unter Informationsgesichtspunkten. Zu den Autoren der Arbeit gehören Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu und Helen Meng; auf der Titelseite werden Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab und The Chinese University of Hong Kong als Zugehörigkeiten aufgeführt. Architektonisch teilt SCNet das gemischte Spektrogramm ausdrücklich in Subbänder und verwendet Sparse Compression, um die unterschiedliche Informationsdichte dieser Bänder zu verarbeiten. Einfacher gesagt: Es konzentriert nicht annähernd die gesamte Kapazität auf den Gesangsbereich. Das Modell wird auf Zeit-Frequenz-Bereiche gelenkt, die tatsächlich nutzbare Instrumentensignale tragen.
Das ist für vier Stems wichtig. Der Bass liegt tief, trägt aber bedeutende Obertöne. Schlagzeug kombiniert sehr kurze Transienten mit Becken und Raumklang. Other kann gleichzeitig Gitarre, Klavier, Streicher, Synthesizer und Effekte enthalten. Die Subbandmodellierung ermöglicht eine gezieltere Behandlung verschiedener Frequenzbereiche, während Sparse Compression die Aufmerksamkeit von leeren oder informationsarmen Bereichen fernhält.
Die SCNet-Arbeit beschreibt das vollständige System als Audio-Encoder, ein auf Dual-Path RNN basierendes Trennnetzwerk und einen Audio-Decoder. Der Encoder bildet den Mix auf Subbanddarstellungen im Frequenzbereich ab, das Trennnetzwerk modelliert Strukturen über Zeit und Frequenz, und der Decoder rekonstruiert die Ziel-Stems.
Huge-SCNet-4stems V1.2 gehört zu diesem Ansatz. Sein Ausgabevertrag ist ein ausgewogenes Set aus vocals, drums, bass und other, das anschließend für Remixe oder Transkription weiterverwendet werden kann, statt ein ausschließlich auf Gesang optimiertes Ziel zu verfolgen.
Ebenso wichtig ist die Trennung zwischen der SCNet-Arbeit und dem Checkpoint Huge-SCNet-4stems V1.2. Die Arbeit liefert die Sparse-Compression-Architektur, das Subbanddesign und das MUSDB18-HQ-Forschungsergebnis; das herunterladbare Artefakt ist der öffentliche Hugging-Face-Checkpoint huge_scnet_4stems_v1.2.ckpt. Dieser Community-Checkpoint kann das Ergebnis von 9.0 dB auf MUSDB18-HQ aus der Arbeit nicht übernehmen, weil Daten und Veröffentlichungshistorie abweichen.
Auch die Codegrenze muss separat behandelt werden. Die Autoren der Arbeit veröffentlichen thuhcsi/SCNet als offizielles Implementierungs-Repository, doch laut Repository muss der Trainingscode noch vervollständigt werden; übergangsweise werden HTDemucs, Music-Source-Separation-Training und SCNet-PyTorch als Trainingsframeworks empfohlen. Huge-SCNet-4stems V1.2 sollte daher als öffentlicher Vier-Stem-Checkpoint auf dem SCNet-Ansatz beschrieben werden, nicht als offizielles Modellpaket der SCNet-Arbeit.
MVSep Ensemble als Plattform-Workflow
MVSep Ensemble 2025.06.30 steht für einen plattformweiten Workflow mit mehreren Modellen. Die öffentliche Algorithmusseite nennt mehr als eine Modellfamilie. Der Gesangsweg kann UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL und weitere Ansätze verwenden, während bass, drums und other unterschiedliche Demucs- oder verwandte Modelle aufrufen können.
Die Stärke eines solchen Ensembles entsteht durch Spezialisierung: gesangsreiches Material wird Gesangsspezialisten zugewiesen, Material mit vielen tiefen Frequenzen und Transienten stärkeren Instrumententrennern, anschließend werden die Ergebnisse zusammengeführt. Es kann als Referenz für die Qualitätsobergrenze dienen, ist aber weder ein einzelner Checkpoint noch ein eigenständiges Modell, das sich durch den Download einer Datei reproduzieren lässt.
MVSep gibt für das Ensemble vom 2025.06.30 einen durchschnittlichen SDR von 13.67 an. Diese Zahl ist als Obergrenze einer gehosteten Plattform nützlich, darf aber nicht in dieselbe Zeile wie ein einzelner Checkpoint gestellt werden. Sie bildet einen serverseitigen Workflow ab, der vor dem Endergebnis Gesang, Instrumental, Bass, Schlagzeug, other und zusätzliche instrumentspezifische Pfade kombinieren kann.
Deshalb müssen Plattform-Ensembles bei der Diskussion eines herunterladbaren einzelnen Vier-Stem-Modells außerhalb der Einzelmodellkategorie bleiben. Andernfalls verschiebt sich der Vergleich von der Modellarchitektur zu einem gehosteten Workflow.
Öffentlicher Vier-Stem-Vergleich
Die folgende Tabelle verwendet Werte aus den zitierten öffentlichen Modell- und Benchmarkseiten. Die Werte helfen dabei, jedes Modell unter demselben Vier-Stem-Ziel einzuordnen. Sie sind nicht als absolutes Urteil für jeden Song, jedes Genre oder jeden Hörfall zu lesen.
Der Quellenumfang ist bewusst eng: Die Zeile Huge-SCNet-4stems V1.2 mit 10.02 dB stammt aus der öffentlichen HF-/MVSep-Referenz; SCNet XL IHF, BS Roformer und HTDemucs4 verwenden öffentliche Zeilen von ZFTurbo / MVSep Multisong. Dies ist keine gemischte Tabelle aus MUSDB18-HQ-Ergebnissen der SCNet-Arbeit, Mel-Band-Gesangsseiten und Werten des gehosteten MVSep Ensemble-Workflows.
Modell
Durchschnittlicher SDR
Vocals
Drums
Bass
Other
Einordnung
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Öffentlicher Vier-Stem-Checkpoint von Huge-SCNet in der zitierten Referenztabelle.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Starker eigenständiger Vier-Stem-Kandidat, besonders für Schlagzeug und Bass.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Nützliche Vier-Stem-Referenz für den Band-Split-RoFormer-Ansatz.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Ausgereifte klassische Basislinie, aber nicht die Obergrenze der heutigen Vier-Stem-Qualität.
Wie die Werte zu lesen sind
Ein höherer SDR bedeutet gewöhnlich weniger Verzerrung gegenüber dem Referenz-Stem. Der durchschnittliche SDR kann jedoch das Hören nicht ersetzen und nicht jeden Stem zu einer einzigen Antwort einebnen. Ein Modell kann bei Bass und Schlagzeug stark sein, während ein anderes den Gesang sauberer hält. Other ist besonders schwierig, weil es viele Instrumente enthält.
Der Wert von Huge-SCNet-4stems V1.2 liegt in seiner klaren Artefaktgrenze: ein öffentlicher Checkpoint-Name, eine standardmäßige Vier-Stem-Ausgabe und nachvollziehbare öffentliche Referenzwerte. SCNet XL IHF bleibt ein wichtiger Vergleich. MVSep Ensemble bleibt eine gehostete Referenz für die Qualitätsobergrenze. Sie beantworten unterschiedliche Fragen.
Nutzer sollten beim Ziel beginnen. Für möglichst sauberen Gesang eignet sich die Gesangstrennung. Für bearbeitbare vocals, drums, bass und other eignet sich die Vier-Stem-Trennung. Wenn Gitarre und Klavier eigene Dateien benötigen, ist die Sechs-Stem-Trennung passend.
Ausgabegrenze: Vier-Stem-Ausgewogenheit gegenüber Sechs-Stem-Detail
Bei der Sechs-Stem-Trennung wird other weiter in Gitarre, Klavier und das verbleibende other aufgeteilt. Sie reagiert empfindlicher auf Gitarrenanschläge, Klavierattacken, Keyboardtexturen und hochfrequente Obertöne. Ein Sechs-Stem-Checkpoint BS Roformer SW stellt daher ein anderes Ziel und einen anderen Trainingsvertrag dar als Huge-SCNet-4stems V1.2.
Diese Aussagen gehören auf getrennte Ebenen: RoFormer beschreibt eine Architekturfamilie, Mel-Band zielt auf die Gesangsdarstellung, SCNet gleicht vier Stems aus, und MVSep-Ensembles kombinieren gehostete Komponenten. Jede Ebene beantwortet eine andere Frage zu Architektur, Ausgabeziel, öffentlicher Verfügbarkeit, Workflowform oder Inferenzvertrag.
Fazit: Die Architektur wählen, nicht das Schlagwort
Eine Vier-Stem-Trennung ist weder eine umbenannte Begleitspur noch ein Ort, an dem das populärste Gesangsmodell auf jedes Instrument angewendet wird. Das Modell muss vocals, drums, bass und other ausbalancieren, insbesondere Schlagzeugtransienten, tiefe Bassfrequenzen, hohe instrumentale Obertöne und den gemischten Instrumentenkorb in other.
Huge-SCNet-4stems V1.2 nimmt rund um dieses standardmäßige Vier-Stem-Ziel eine klare Position ein. Mel-Band RoFormer bleibt für das Verständnis der Gesangstrennung wichtig, während MVSep Ensemble als gehostete Qualitätsreferenz nützlich bleibt. Beide gehören zu unterschiedlichen Ebenen der Forschungs- und Bereitstellungsgeschichte.