Séparation audio quatre stems : pourquoi Huge-SCNet correspond à la cible MSS · TelkNet
Modèle
Séparation audio quatre stems : pourquoi Huge-SCNet correspond à la cible MSS
L’outil quatre stems actuel de TelkNet utilise Huge-SCNet-4stems V1.2 pour diviser un mix complet en voix, batterie, basse et autres. L’article explique ce choix par l’historique MSS, les forces et limites de Mel-Band RoFormer, la modélisation en sous-bandes de SCNet et les scores publics quatre stems.
Actualité des modèles / Séparation de sources musicales
Date de l’actualité : 2026-06-30
Modèle quatre stems actuel : Huge-SCNet-4stems V1.2
Sortie standard : vocals / drums / bass / other
Sujet : architecture MSS, limites de Mel-Band RoFormer, compromis de SCNet
Résumé
La séparation de sources musicales par IA a dépassé la simple question de savoir si une voix peut être extraite d’un mix. Pour le remix, l’échantillonnage, la pratique, Music-to-MIDI, l’audio spatial et le nettoyage de matériaux, la question utile est de savoir si le résultat reste modifiable. La séparation standard en quatre stems poursuit cet objectif plus strict : diviser un mix complet en vocals, drums, bass et other, au lieu de produire uniquement des fichiers de voix et d’accompagnement.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer et Huge-SCNet-4stems V1.2 représentent différentes approches à quatre stems. La qualité vocale ne détermine pas à elle seule celle d’une séparation en quatre stems. Un ensemble de plateforme peut obtenir un score élevé sans être un modèle autonome téléchargeable, tandis qu’un checkpoint public fournit un artefact reproductible.
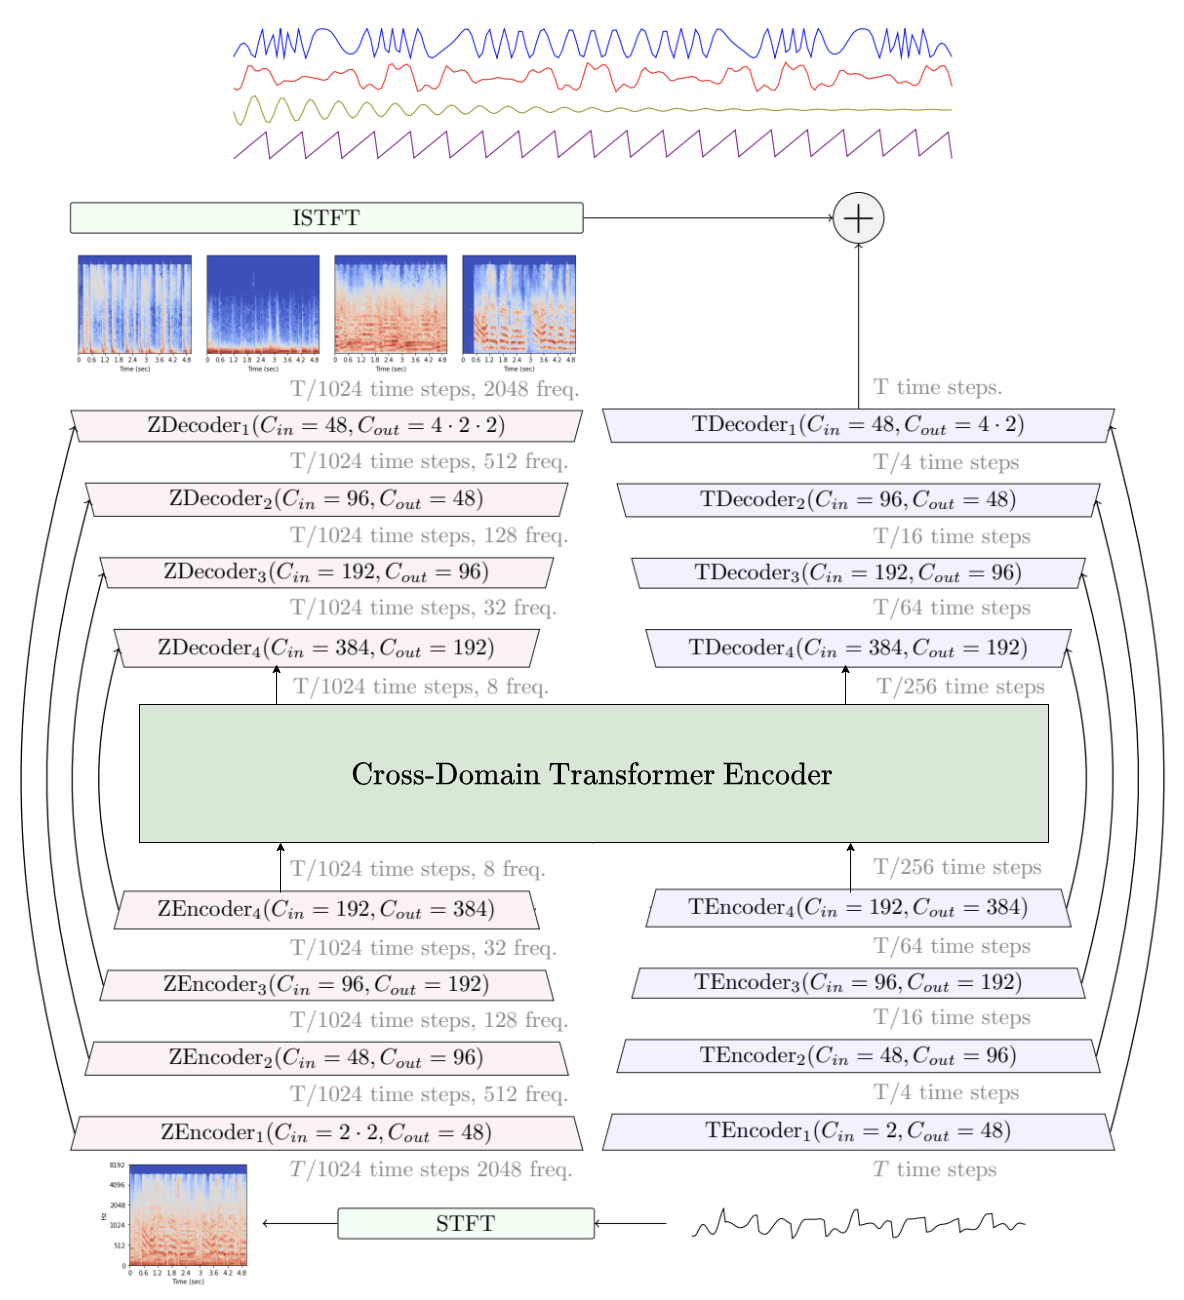
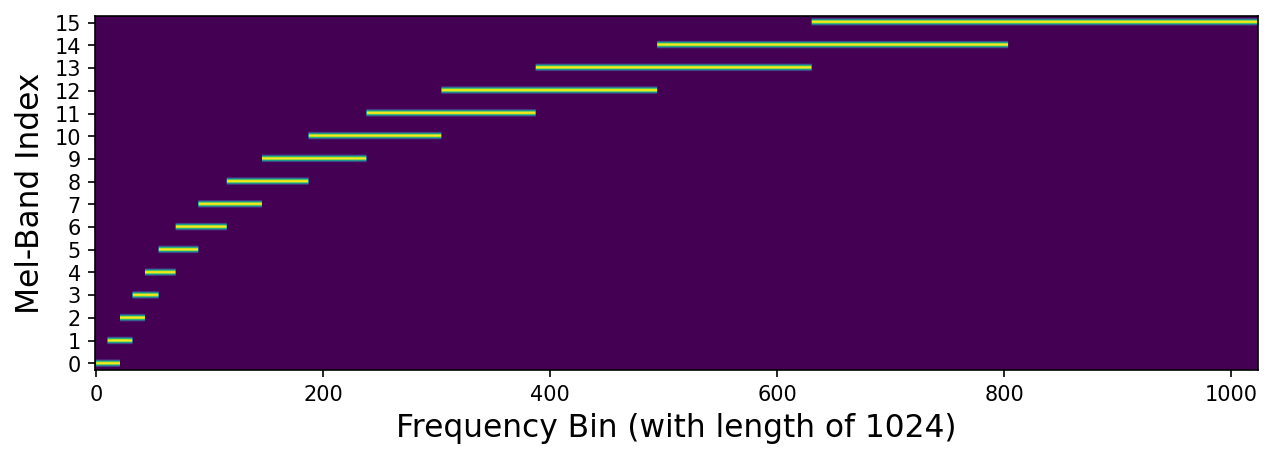
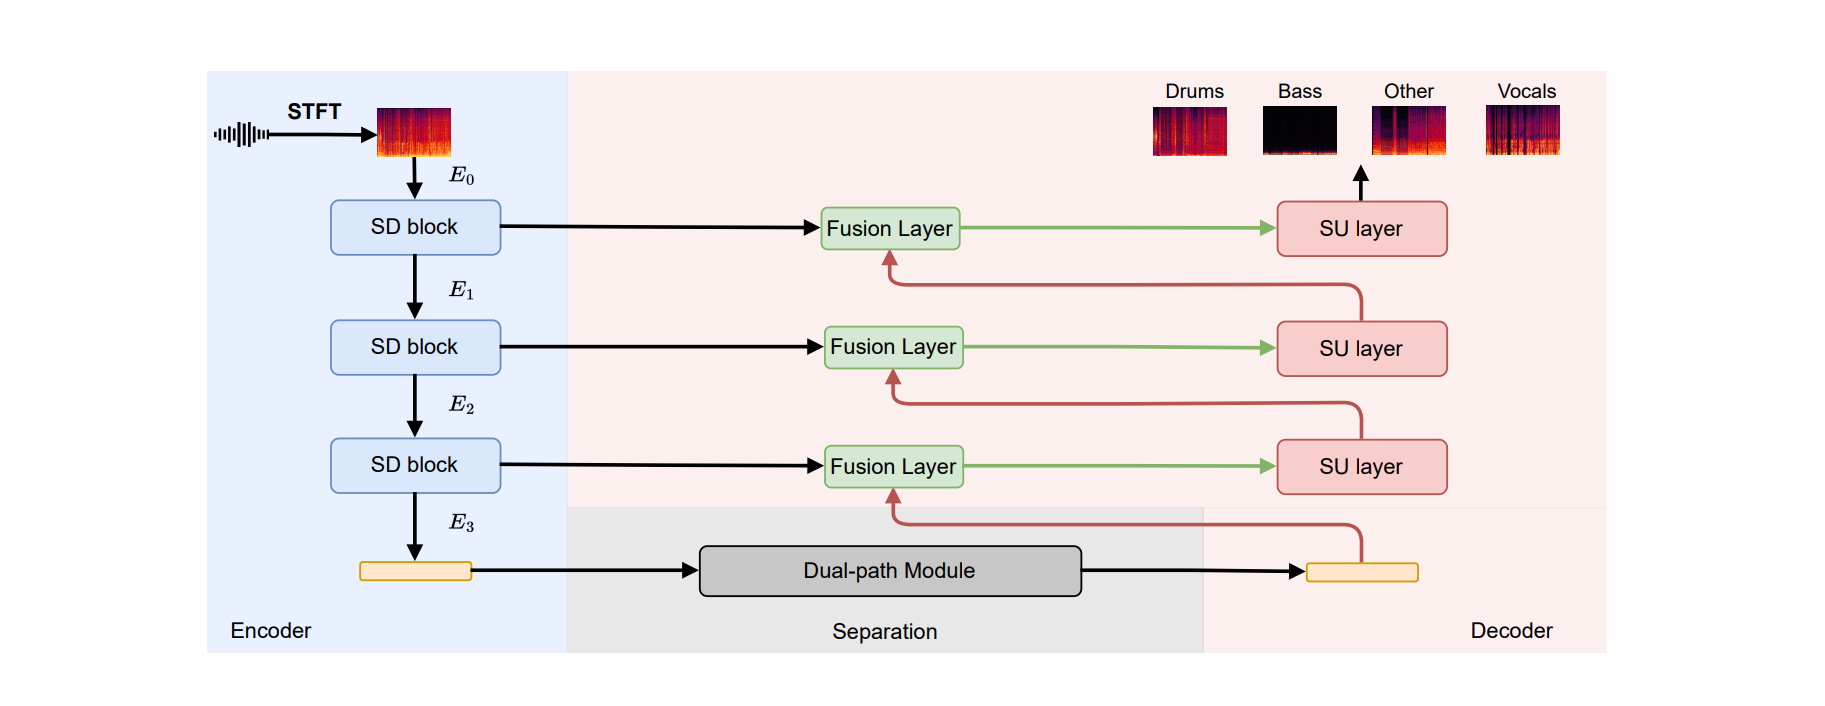
HTDemucs Le schéma de structure officiel de l'article : les deux branches du domaine de forme d'onde et du domaine spectral convergent à l'intérieur du modèle. La conception représentative de l'étape « double domaine » dans la chronologie ci-dessous ressemble à ceci (source : article Hybrid Transformers, arXiv : 2211.08553).Mel-Band RoFormer Paper Schéma officiel : comment les groupes spectraux sont mappés à des sous-bandes superposées organisées sur une échelle Mel. Les sous-bandes obtenues dans les fréquences moyennes-basses sont plus denses, donc les détails vocaux sont exprimés avec plus de détails (source : arXiv : 2310.01809).SCNet : la position du module de compression clairsemée entre l'encodeur et le réseau de séparation est claire en un coup d'œil - compressant d'abord les zones à faible densité d'informations, puis laissant la puissance de calcul aux limites vocales encombrées (source : article SCNet, arXiv :2401.13276).
Les pages publiques d’algorithmes et les classements de MVSep sont des références courantes dans la séparation de sources musicales. Ils documentent les résultats et les configurations ; un workflow d’ensemble ne doit pas être interprété comme un modèle autonome unique.
Quatre stems ne sont pas un autre nom pour les pistes d’accompagnement
La séparation standard en quatre stems désigne généralement vocals, drums, bass et other. Vocals est la piste chantée, drums la batterie, bass la partie de basse et other rassemble les instruments restants : guitare, piano, cordes, synthétiseurs, cuivres, effets et autres. La piste d’accompagnement entendue après avoir coupé la voix correspond en réalité à la somme de drums, bass et other.
Cet objectif provient des principaux jeux de données et de la tradition d’évaluation de la séparation de sources musicales. MUSDB18 et MUSDB18-HQ structurent depuis longtemps l’entraînement et l’évaluation des modèles autour de ces quatre stems. Lorsque la communauté parle de 4-stem, elle désigne généralement cet objectif de sortie.
Cette distinction change le choix de l’outil. Si l’objectif est une voix propre ou un instrumental sans voix, un séparateur vocal à deux stems est plus direct. Si l’objectif est la pratique de la batterie, l’analyse de la basse, l’échantillonnage, le remix ou le nettoyage de matériaux modifiables, quatre stems sont plus utiles. Other n’est pas une piste d’accompagnement affaiblie ; c’est le panier d’instruments le plus difficile du système.
Quatre étapes de U-Net à SCNet
La séparation de sources musicales cherche à récupérer plusieurs sources à partir d’une forme d’onde mixée, dans le temps et les fréquences. Les modèles antérieurs pouvaient produire des sorties écoutables, mais leurs artefacts étaient familiers : fuite de voix, repisse de batterie, basse brouillonne, hautes fréquences estompées ou phase déchirée dans les arrangements denses.
Période
Approche représentative
Progrès
Problème restant
2020-2021
VR Architecture / U-Net
Traitement des spectrogrammes comme des images, rendant pratique la séparation élémentaire entre voix et accompagnement.
Les fenêtres de convolution locales géraient difficilement le contexte musical long et les relations de phase.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Combinaison de la modélisation de la forme d’onde et du spectrogramme, améliorant la qualité et la stabilité de la reconstruction.
Les climax denses, la forte réverbération et les transitoires complexes pouvaient encore produire des artefacts.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Utilisation du découpage en bandes, de RoPE et d’une modélisation temps-fréquence renforcée pour les voix, harmonies, glissés et tenues.
Une allocation fréquentielle qui favorise les voix n’est pas automatiquement optimale pour tous les instruments d’une séparation en quatre stems.
Utilisation de la modélisation en sous-bandes et de la compression parcimonieuse pour se concentrer sur les régions temps-fréquence riches en informations.
L’objectif reste la séparation standard en quatre stems, et non une sortie à six stems ou un ensemble de plateforme.
Cette histoire explique pourquoi le choix d’un modèle ne peut pas se réduire à la qualité vocale. La séparation en quatre stems doit aussi préserver les transitoires de batterie, les fondamentales et harmoniques de la basse, les limites de la voix et les détails haute fréquence contenus dans other.
La chronologie reste elle aussi circonscrite aux sources : l’article SCNet a été rendu public en janvier 2024, tandis que Huge-SCNet-4stems V1.2 appartient au contexte ultérieur des checkpoints publics. C’est pourquoi cette chronologie utilise 2024-2026 au lieu de laisser entendre que SCNet lui-même n’est apparu qu’après 2025.
Mel-Band RoFormer : force vocale et limites des quatre stems
Mel-Band RoFormer a été proposé par l’équipe Speech, Audio, and Music Intelligence (SAMI) de ByteDance. Les auteurs de l’article sont Ju-Chiang Wang, Wei-Tsung Lu et Minz Won, avec une affiliation indiquée en page de titre comme SAMI, ByteDance. Les pages communautaires résument parfois cette filiation sous le nom ByteDance AI Labs, mais la formulation la plus précise par rapport aux sources reste les auteurs de l’article et SAMI, ByteDance.
Le modèle est attrayant parce qu’il organise les bandes de fréquences d’une façon plus proche de l’audition humaine. L’oreille est plus sensible aux basses et moyennes fréquences, où se trouvent les fondamentales de la voix, les consonnes, le souffle et de nombreux indices de hauteur. La projection en bandes mel offre une représentation plus fine de cette zone, ce qui aide le modèle à suivre les voix principales et d’accompagnement, les glissés, le vibrato et les queues de réverbération.
La famille RoFormer emploie l’encodage positionnel rotatif, ou RoPE, sur les séquences temporelles comme sur celles des sous-bandes. Les scores d’attention dépendent ainsi de la position relative. Les glissés, les tenues et les phrases répétées donnent une intuition structurelle utile de cette propriété, mais l’article ne teste directement que des modèles contrôlés avec et sans RoPE ; il ne rapporte aucune métrique distincte pour les glissés ou les longues harmonies.
Chemin du signal défini dans l’article
BS-RoFormer convertit d’abord la forme d’onde du mix en spectrogramme complexe. Sa projection en bandes et son Transformer hiérarchique estiment un masque complexe, ce masque est appliqué au spectre du mix, puis la STFT inverse reconstruit la forme d’onde cible. Mel-RoFormer modifie la projection à l’intérieur de fθ : des bandes mel qui se chevauchent remplacent le découpage heuristique sans chevauchement. Il ne remplace pas l’ensemble du chemin de reconstruction.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: le spectrogramme complexe du mix, comprenant ses composantes réelle et imaginaire.
fθ: la projection en bandes, les Transformers intra- et inter-bandes et l’estimation du masque.
M̂: le masque cible complexe servant à récupérer la magnitude et la phase.
ŷ: la forme d’onde reconstruite par STFT inverse et contrainte pendant l’entraînement par des pertes sur la forme d’onde et le spectre.
C’est pourquoi Mel-Band RoFormer est une voie solide pour la séparation voix/accompagnement, voix principale/voix d’accompagnement et l’extraction d’une voix propre. Le problème est que la séparation en quatre stems ne concerne pas uniquement la voix. Elle doit aussi séparer drums, bass et other, et other contient souvent les détails instrumentaux haute fréquence les plus difficiles.
Après les articles : comment RoFormer est devenu un écosystème d’outils ouverts
BS-RoFormer est apparu en septembre 2023 avec deux types de preuves dans un même article. Le système L=12, plus grand et entraîné sur MUSDB18HQ ainsi que 500 morceaux internes, documentait la soumission de SAMI-ByteDance classée première à SDX23. De plus petits modèles limités à MUSDB18HQ fournissaient des ablations contrôlées pour RoPE, le découpage en bandes et la reconstruction par chevauchement et moyenne. L’article publiait l’architecture, les conditions d’entraînement et les tableaux de résultats. Il ne joignait pas le checkpoint SDX23 original et ne donnait aucun lien vers un dépôt d’entraînement et d’inférence ByteDance/SAMI.
Mel-Band RoFormer a suivi en octobre 2023. Il conservait les Transformers RoPE, la modélisation de séquences intra- et inter-bandes, les masques complexes et la reconstruction de forme d’onde, mais remplaçait le découpage manuel sans chevauchement par 60 bandes mel superposées. L’intervalle d’un mois compte : il s’agissait d’une révision publique de la projection fréquentielle motivée par la limite du précédent article, et non d’un second paquet de checkpoint officiel publié avec le texte.
Du code exécutable s’est accumulé en dehors des articles. Le dépôt lucidrains a transformé les schémas et les équations en classes de modèles PyTorch et invité ouvertement d’autres personnes à reproduire le séparateur. La gestion stéréo, les multiples stems de sortie et la variante Mel-Band ont rendu la structure réutilisable, mais le code seul ne pouvait pas reconstituer les morceaux internes, l’état de l’optimiseur, la durée d’entraînement ou les paramètres finaux de la compétition.
Music-Source-Separation-Training a ensuite offert un atelier commun à cette structure réutilisable : chargement des jeux de données, augmentation, entraînement, validation, reprise de checkpoint, inférence par segments, chevauchement et combinaison de modèles. Son README attribue à lucidrains la recréation des modèles RoFormer à partir des articles et accepte les soumissions de modèles communautaires. Une même architecture pouvait désormais être entraînée pour séparer voix et instrumental, quatre stems, des sous-stems de batterie ou d’autres cibles spécialisées. Il n’existait aucun poids communautaire canonique unique.
Le modèle vocal de Kimberley Jensen a rendu le processus concret. Le dépôt indique qu’il a été entraîné sur davantage de données avec le code de ZFTurbo, qu’il utilise par défaut un segment de huit secondes et qu’il expose num_overlap pour réduire les artefacts de raccord au prix d’une inférence plus longue. Il crédite également les contributeurs au jeu de données. Ces détails expliquent pourquoi un checkpoint téléchargeable possède un caractère qu’un nom d’architecture seul ne peut pas décrire.
La page MVSep actuelle attribue les premiers poids publics de haute qualité à Kimberley Jensen, puis décrit la modification ultérieure et la poursuite de l’entraînement des poids ouverts. Bas Curtiz, unwa, becruily, gabox et d’autres éditions figurent sur la même page avec des compromis différents en matière de densité, de repisse, de bruit et de SDR. Il s’agit d’une généalogie de poids ramifiée : les modèles partagent Mel-Band RoFormer, mais pas leurs données, leur objectif, leur historique de fine-tuning ou leur son final.
Synthèse fondée sur les deux articles RoFormer, l’implémentation lucidrains et le framework d’entraînement ZFTurbo/MVSep. Les flèches indiquent une dépendance d’implémentation, pas une approbation officielle.
Nom ou artefact
Ce qu’il identifie
Ce qui exige encore une provenance
BS-RoFormer / Mel-Band RoFormer
Projection en bandes, RoPE et conception de modélisation séquentielle axiale.
L’entraîneur concret du checkpoint, les données, les stems cibles et le jeu d’évaluation.
Un fichier de checkpoint téléchargeable
Un jeu de paramètres qui dépend normalement d’une configuration correspondante.
S’il provient des auteurs de l’article, d’un entraînement communautaire ou d’un fine-tuning ultérieur.
Un workflow Mel-Band / BS-RoFormer hébergé
Le service a sélectionné les poids, le découpage, le chevauchement et les sorties.
Les scores du workflow hébergé ne peuvent pas être rebaptisés résultats SDX23 ou résultats de l’article original.
Un même nom d’architecture peut désormais désigner un système de compétition, une ablation d’article, un checkpoint vocal, un checkpoint quatre stems ou un ensemble de plateforme. Un texte exact doit révéler trois choses : qui a proposé l’architecture, d’où viennent les poids actuels et quelle recette d’inférence produit le résultat. Sans ces trois éléments, des expressions telles que « modèle ByteDance officiel » ou « score de compétition quatre stems Mel-Band » assemblent discrètement des artefacts différents issus de moments distincts de cette histoire.
Comparaison contrôlée : Mel ne remplace pas BS sur tous les stems
La preuve la plus nette est la comparaison contrôlée de l’article Mel-Band de 2023, et non un mélange de pages MVSep et de checkpoints communautaires sans rapport. Chaque ligne ci-dessous utilise MUSDB18HQ sans morceaux supplémentaires. À profondeur égale, le principal changement concerne la projection : les bandes heuristiques sans chevauchement de BS-RoFormer sont remplacées par 60 bandes mel superposées.
Le résultat est un compromis, pas une victoire totale. À L=6, vocals passe de 10.78 à 11.21 dB et drums de 9.61 à 9.91 dB, tandis que bass chute de 11.43 à 9.64 dB et other recule légèrement de 7.86 à 7.81 dB. À L=9, vocals gagne 0.58 dB et other 0.13 dB, drums perd 0.32 dB et bass n’est pas rapporté parce que l’entraînement progressait trop lentement.
Modèle de l’article (MUSDB18HQ, sans données supplémentaires)
Vocals
Bass
Drums
Other
SDR moyen
Paramètres
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
non rapporté
9.34
7.93
non rapporté
94.8M
L’article relie le résultat de la basse à la cartographie des fréquences. BS-RoFormer attribue délibérément des bandes fines aux basses fréquences, tandis que la projection mel est plus utile pour les voix et certaines cibles hors basse. La conclusion d’ingénierie utile dépend donc de la tâche : la projection mel est un excellent choix vocal, mais la motivation psychoacoustique seule ne prouve pas une domination sur quatre stems.
SCNet et l’objectif à quatre stems
SCNet adopte une vision du spectre davantage centrée sur l’information. Les auteurs de l’article comprennent Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu et Helen Meng ; la page de titre mentionne notamment Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab et The Chinese University of Hong Kong parmi les affiliations. Sur le plan architectural, SCNet divise explicitement le spectrogramme du mix en sous-bandes et utilise une compression parcimonieuse pour gérer leurs différentes densités d’information. Plus simplement, il ne concentre pas presque toute sa capacité sur la plage vocale. Il pousse le modèle à privilégier les régions temps-fréquence qui transportent réellement un signal instrumental utile.
Cela compte pour quatre stems. La basse occupe les fréquences basses, mais transporte des harmoniques importantes. La batterie combine des transitoires très courts avec les cymbales et le son de la pièce. Other peut contenir simultanément guitare, piano, cordes, synthétiseurs et effets. La modélisation en sous-bandes offre un traitement plus ciblé aux différentes régions fréquentielles, tandis que la compression parcimonieuse détourne l’attention des régions vides ou pauvres en informations.
L’article SCNet décrit le système complet comme un encodeur audio, un réseau de séparation fondé sur un RNN à double chemin et un décodeur audio. L’encodeur projette le mix vers des représentations en sous-bandes dans le domaine fréquentiel, le réseau de séparation modélise les structures dans le temps et les fréquences, puis le décodeur reconstruit les stems cibles.
Huge-SCNet-4stems V1.2 appartient à cette voie. Son contrat de sortie est un ensemble équilibré de fichiers vocals, drums, bass et other qui peuvent ensuite servir au remix ou à la transcription, plutôt qu’un objectif optimisé uniquement pour la voix.
Il est également important de distinguer l’article SCNet du checkpoint Huge-SCNet-4stems V1.2. L’article fournit l’architecture de compression parcimonieuse, la conception des sous-bandes et le résultat de recherche MUSDB18-HQ ; l’artefact téléchargeable est le checkpoint public Hugging Face huge_scnet_4stems_v1.2.ckpt. Ce checkpoint communautaire ne peut pas hériter du résultat de 9.0 dB sur MUSDB18-HQ de l’article, car les données et la provenance de publication diffèrent.
La frontière du code doit elle aussi rester séparée. Les auteurs de l’article publient thuhcsi/SCNet comme dépôt d’implémentation officiel, mais le dépôt indique que le code d’entraînement reste à terminer et oriente temporairement les lecteurs vers HTDemucs, Music-Source-Separation-Training et SCNet-PyTorch comme frameworks d’entraînement. Huge-SCNet-4stems V1.2 doit donc être décrit comme un choix de checkpoint public à quatre stems sur la voie SCNet, et non comme le paquet de modèle officiel de l’article SCNet.
MVSep Ensemble en tant que workflow de plateforme
MVSep Ensemble 2025.06.30 représente un workflow multimodèle au niveau de la plateforme. La page publique de l’algorithme énumère plusieurs familles de modèles. La voie vocale peut utiliser UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL et d’autres approches, tandis que bass, drums et other peuvent appeler différents modèles Demucs ou apparentés.
La force de ce type d’ensemble vient de la spécialisation : confier les matériaux riches en voix aux spécialistes vocaux, ceux riches en basses fréquences et en transitoires à des séparateurs instrumentaux plus puissants, puis fusionner les résultats. Il peut servir de référence pour le plafond de qualité, mais il ne s’agit ni d’un checkpoint unique ni d’un modèle autonome qu’un utilisateur peut reproduire en téléchargeant un seul fichier.
MVSep attribue à l’ensemble du 2025.06.30 un SDR moyen de 13.67. Ce chiffre est utile comme plafond de plateforme hébergée, mais ne doit pas figurer sur la même ligne qu’un checkpoint autonome. Il reflète un workflow côté serveur capable de combiner les voies vocales, instrumentales, bass, drums, other et d’autres voies propres à certains instruments avant de produire le résultat final.
Pour cette raison, l’analyse d’un modèle autonome téléchargeable à quatre stems doit maintenir les ensembles de plateforme hors de la catégorie des modèles uniques. Sinon, la comparaison glisse de l’architecture du modèle vers le workflow hébergé.
Comparaison publique de modèles à quatre stems
Le tableau ci-dessous reprend les chiffres des pages publiques de modèles et de benchmarks citées. Les scores aident à situer chaque modèle sous le même objectif à quatre stems. Ils ne doivent pas être lus comme un verdict absolu pour chaque morceau, genre ou cas d’écoute.
Le périmètre des sources est volontairement étroit : la ligne Huge-SCNet-4stems V1.2 à 10.02 dB provient de la référence publique HF / MVSep ; SCNet XL IHF, BS Roformer et HTDemucs4 utilisent les lignes publiques ZFTurbo / MVSep Multisong. Ce tableau ne mélange pas les résultats MUSDB18-HQ de l’article SCNet, les pages vocales Mel-Band et les scores du workflow hébergé MVSep Ensemble.
Modèle
SDR moyen
Vocals
Drums
Bass
Other
Interprétation
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Checkpoint public Huge-SCNet à quatre stems dans le tableau de référence cité.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Solide candidat autonome à quatre stems, notamment pour la batterie et la basse.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Référence utile à quatre stems pour la voie RoFormer à découpage en bandes.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Baseline classique et éprouvée, mais plus le plafond actuel de qualité à quatre stems.
Comment lire les scores
Un SDR plus élevé signifie généralement moins de distorsion par rapport au stem de référence. Mais le SDR moyen ne peut pas remplacer l’écoute ni réduire chaque stem à une seule réponse. Un modèle peut être performant sur la basse et la batterie, tandis qu’un autre conserve des voix plus propres. Other est particulièrement difficile parce qu’il contient de nombreux instruments.
La valeur de Huge-SCNet-4stems V1.2 réside dans la clarté de sa frontière d’artefact : un nom de checkpoint public, une sortie standard à quatre stems et des chiffres de référence publics traçables. SCNet XL IHF reste une comparaison importante. MVSep Ensemble reste une référence hébergée pour le plafond de qualité. Ils répondent à des questions différentes.
Les utilisateurs doivent commencer par l’objectif. Utilisez la séparation vocale pour obtenir la voix la plus propre. Utilisez la séparation en quatre stems pour des fichiers vocals, drums, bass et other modifiables. Utilisez la séparation en six stems lorsque la guitare et le piano doivent disposer de leurs propres fichiers.
Frontière de sortie : équilibre à quatre stems ou détail à six stems
La séparation en six stems divise davantage other en guitare, piano et other restant. Elle est plus sensible aux accords de guitare, aux attaques de piano, aux textures de clavier et aux harmoniques haute fréquence. Un checkpoint BS Roformer SW à six stems représente donc un objectif et un contrat d’entraînement différents de Huge-SCNet-4stems V1.2.
Ces affirmations appartiennent à des niveaux distincts : RoFormer décrit une famille d’architectures, Mel-Band cible la représentation vocale, SCNet équilibre quatre stems et les ensembles MVSep combinent des composants hébergés. Chacun répond à une question différente sur l’architecture, l’objectif de sortie, la disponibilité publique, la forme du workflow ou le contrat d’inférence.
Conclusion : choisir l’architecture, pas le mot à la mode
La séparation en quatre stems n’est ni une piste d’accompagnement rebaptisée ni un endroit où appliquer le modèle vocal le plus populaire à chaque instrument. Elle demande au modèle d’équilibrer vocals, drums, bass et other, notamment les transitoires de batterie, les graves de la basse, les hautes harmoniques instrumentales et le panier d’instruments mélangés dans other.
Huge-SCNet-4stems V1.2 occupe une position claire autour de cet objectif standard à quatre stems. Mel-Band RoFormer reste important pour comprendre la séparation vocale, tandis que MVSep Ensemble demeure utile comme référence de qualité hébergée. Chacun appartient à un niveau différent de l’histoire de la recherche et du déploiement.