TelkNets nåværende fire-stem-verktøy bruker Huge-SCNet-4stems V1.2 til å dele et helt miks i vokal, trommer, bass og annet. Artikkelen forklarer valget gjennom MSS-arkitektur, Mel-Band RoFormer-styrker og grenser, SCNet-subbandmodellering og offentlige fire-stem-tall.
Modellnytt / Separasjon av musikkilder
Nyhetsdato: 2026-06-30
Nåværende modell for fire stems: Huge-SCNet-4stems V1.2
Standardutdata: vocals / drums / bass / other
Tema: MSS-arkitektur, grensene til Mel-Band RoFormer, avveiningene i SCNet
Sammendrag
AI-basert separasjon av musikkilder har beveget seg forbi det enkle spørsmålet om en vokal kan trekkes ut av en miks. For remiksing, sampling, øving, Music-to-MIDI, romlig lyd og opprydding i materiale er det nyttige spørsmålet om resultatet fortsatt kan redigeres. Standard separasjon i fire stems følger dette strengere målet: En full miks deles i vocals, drums, bass og other, i stedet for bare å produsere filer med vokal og akkompagnement.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer og Huge-SCNet-4stems V1.2 representerer ulike tilnærminger til fire stems. Vokalstyrke alene avgjør ikke kvaliteten på en separasjon i fire stems. Et plattformensemble kan oppnå høy skår uten å være en nedlastbar, selvstendig modell, mens en offentlig checkpoint gir en reproduserbar artefakt.
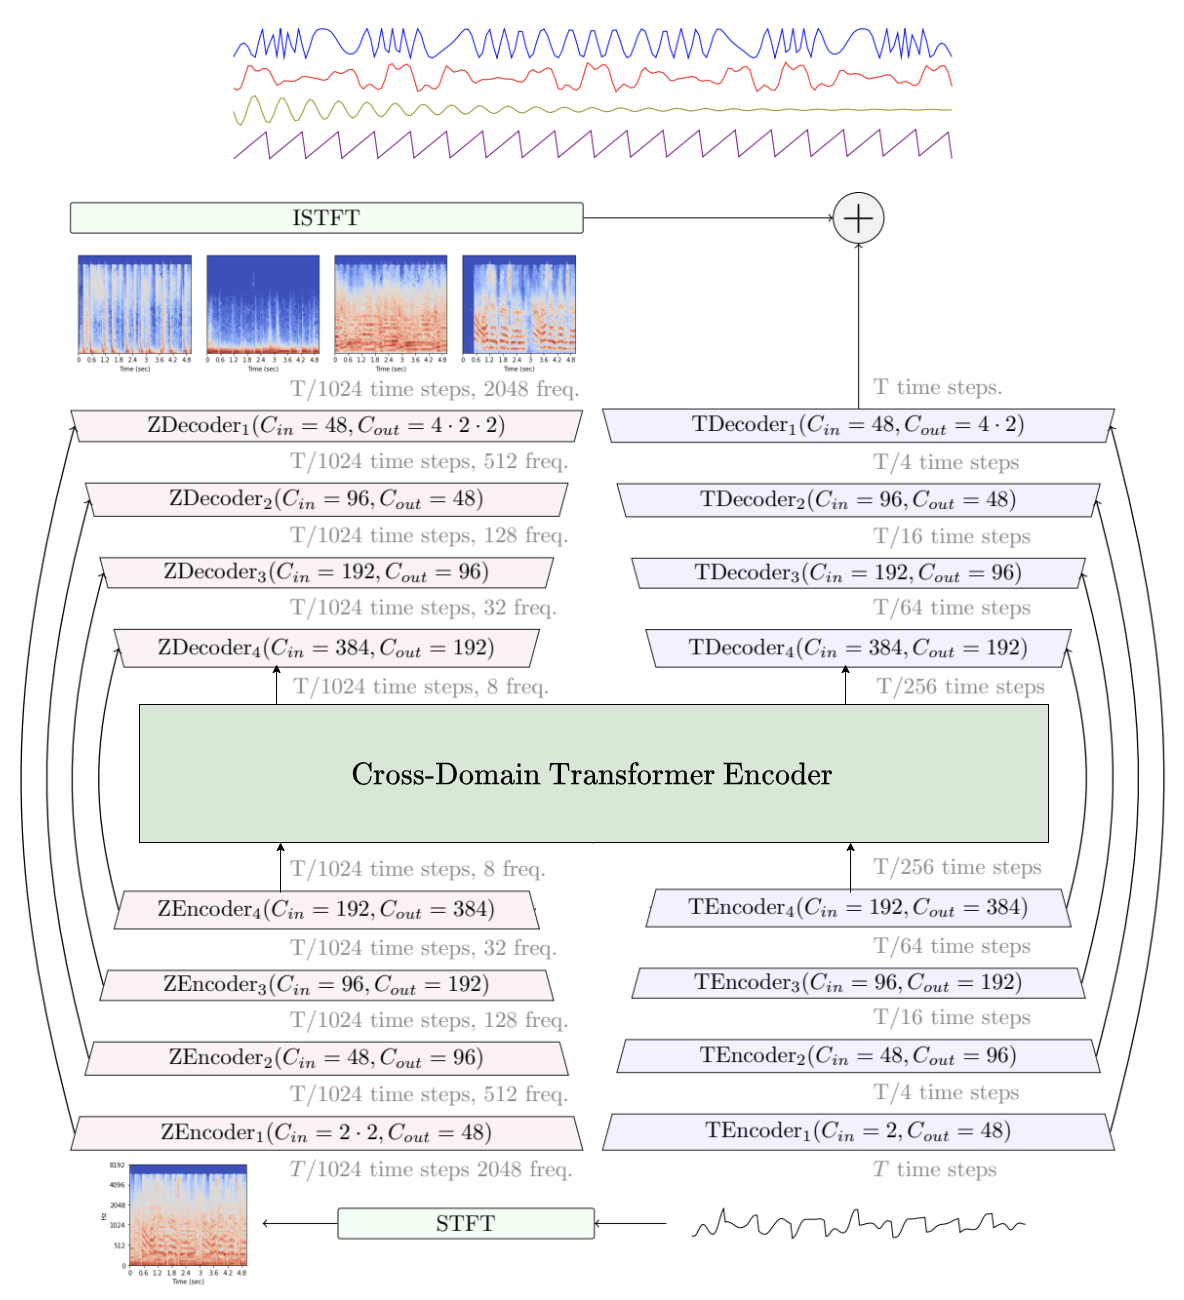
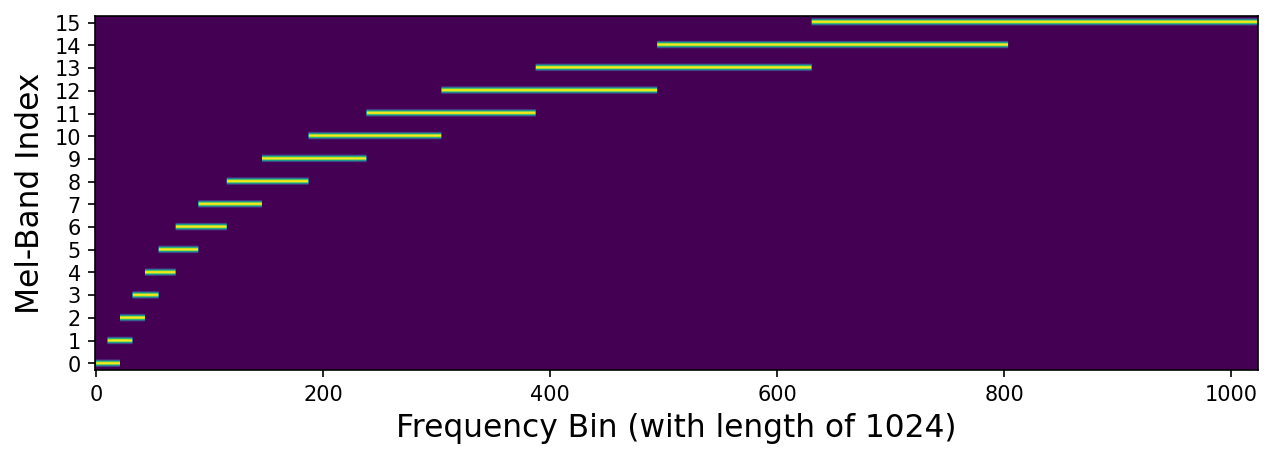
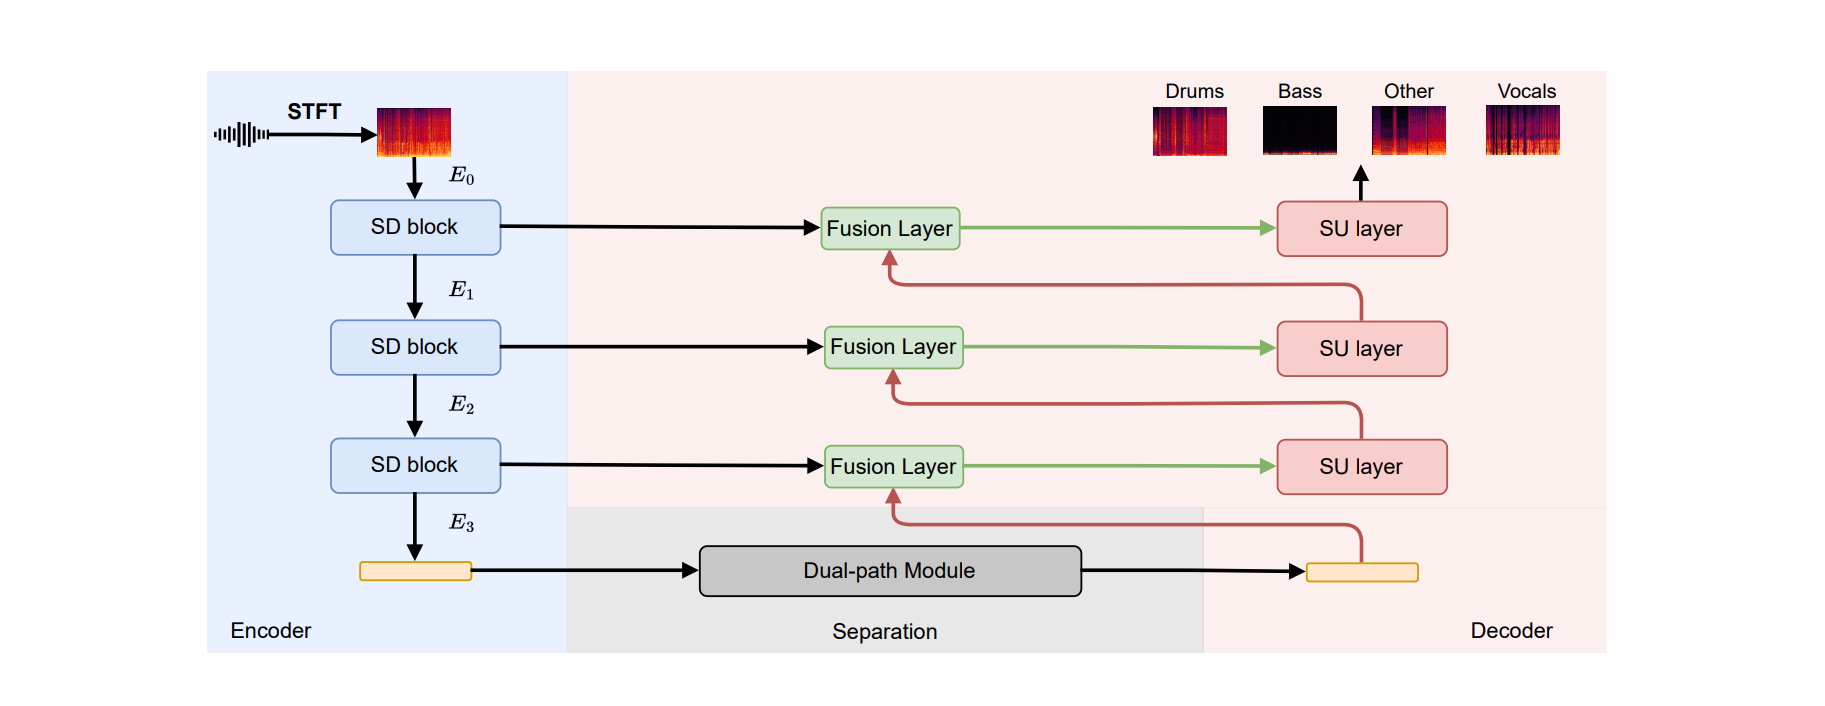
HTDemucs Det offisielle strukturdiagrammet for papiret: de to grenene til bølgeformdomenet og spektrumdomenet konvergerer inne i modellen. Den representative utformingen av "dobbelt domene"-stadiet i tidslinjen nedenfor ser slik ut (kilde: Hybrid Transformers paper, arXiv:2211.08553).Mel-Band RoFormer Paper offisielt diagram: hvordan spektrale biner er kartlagt til overlappende underbånd organisert på en mel-skala. Underbåndene som oppnås i mellom-lav frekvens er tettere, så vokaldetaljene uttrykkes i finere detaljer (kilde: arXiv:2310.01809).SCNet papir offisielt arkitekturdiagram: Plasseringen av den sparsomme komprimeringsmodulen mellom koderen og separasjonsnettverket er tydelig med et øyeblikk - først komprimerer områder med lav informasjonstetthet, og overlater deretter datakraft til overfylte stemmegrenser (kilde: SCNet paper, arXiv:2401.13276).
MVSep sine offentlige algoritmesider og resultatlister er vanlige referansepunkter innen separasjon av musikkilder. De dokumenterer resultater og konfigurasjoner; en ensemblearbeidsflyt bør ikke leses som én selvstendig modell.
Fire stems er ikke et annet navn på akkompagnementsspor
Standard separasjon i fire stems betyr vanligvis vocals, drums, bass og other. Vocals er sangsporet, drums er trommesettet, bass er bassdelen, og other inneholder de øvrige instrumentene: gitar, piano, strykere, synther, messingblåsere, effekter og mer. Akkompagnementet som høres etter at vokalen er dempet, er egentlig summen av drums, bass og other.
Dette målet kommer fra de viktigste datasettene og evalueringstradisjonen innen separasjon av musikkilder. MUSDB18 og MUSDB18-HQ har lenge formet modelltrening og evaluering rundt disse fire stemmene. Når fagmiljøet sier 4-stem, mener det vanligvis dette utdatamålet.
Forskjellen endrer valg av verktøy. Hvis målet er en ren vokal eller en instrumentalversjon uten vokal, er en vokalseparator med to stems mer direkte. Hvis målet er trommeøving, bassanalyse, sampling, remiksing eller redigerbar opprydding i materiale, er fire stems mer nyttige. Other er ikke et dårligere akkompagnementsspor; det er systemets vanskeligste samling av instrumenter.
Fire faser fra U-Net til SCNet
Separasjon av musikkilder forsøker å gjenskape flere kilder fra én blandet bølgeform på tvers av tid og frekvens. Tidligere modeller kunne produsere resultater det gikk an å lytte til, men artefaktene var velkjente: vokallekkasje, trommegjennomslag, grumsete bass, utflytende høye frekvenser eller en opprevet fasekarakter i tette arrangementer.
Periode
Representativ retning
Fremskritt
Gjenværende problem
2020-2021
VR Architecture / U-Net
Behandlet spektrogrammer som bilder og gjorde grunnleggende separasjon av vokal og akkompagnement praktisk.
Lokale konvolusjonsvinduer slet med lang musikalsk kontekst og faseforhold.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Kombinerte modellering av bølgeform og spektrogram og forbedret rekonstruksjonskvalitet og stabilitet.
Tette klimaks, kraftig romklang og komplekse transienter kunne fortsatt gi artefakter.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Brukte bånddeling, RoPE og sterkere tids-frekvensmodellering for vokaler, harmonier, glidninger og vedvarende toner.
En frekvensfordeling som favoriserer vokaler, er ikke automatisk best for alle instrumentene i fire stems.
Brukte delbåndsmodellering og sparsom komprimering for å konsentrere seg om informasjonsrike tids-frekvensområder.
Målet er fortsatt standard separasjon i fire stems, ikke utdata i seks stems eller et plattformensemble.
Denne historien forklarer hvorfor modellvalg ikke kan reduseres til vokalkvalitet. Separasjon i fire stems må også bevare trommetransienter, bassens grunntoner og overtoner, vokalgrenser og høyfrekvensdetaljene i other.
Tidsangivelsen er også avgrenset av kildene: SCNet-artikkelen ble offentliggjort i januar 2024, mens Huge-SCNet-4stems V1.2 hører til den senere sammenhengen med offentlige checkpoints. Derfor bruker denne tidslinjen 2024-2026 i stedet for å antyde at SCNet selv først dukket opp etter 2025.
Mel-Band RoFormer: Vokalstyrke og grenser ved fire stems
Mel-Band RoFormer ble foreslått av ByteDance-teamet Speech, Audio, and Music Intelligence (SAMI). Artikkelforfatterne er Ju-Chiang Wang, Wei-Tsung Lu og Minz Won, og tilhørigheten på tittelsiden er oppført som SAMI, ByteDance. Sider i fagmiljøet oppsummerer noen ganger retningen som ByteDance AI Labs, men den mest presise kildeformuleringen er artikkelforfatterne og SAMI, ByteDance.
Modellen er attraktiv fordi den former frekvensbåndene nærmere menneskelig hørsel. Øret er mer følsomt for lave og mellomliggende frekvenser, der vokalens grunntoner, konsonanter, pust og mange tonehøydesignaler finnes. Mel-båndprojeksjon gir dette området en finere representasjon og hjelper modellen med å følge hovedvokal, bakgrunnsvokal, glidninger, vibrato og etterklangshaler.
RoFormer-familien bruker roterende posisjonskoding, eller RoPE, på både tids- og delbåndssekvensene. Dette gjør at oppmerksomhetsskårene avhenger av relativ posisjon. Glidninger, vedvarende toner og gjentatte fraser er nyttige strukturelle intuisjoner for denne egenskapen, men artikkelen tester direkte bare de kontrollerte modellene med og uten RoPE; den rapporterer ikke separate mål for glidninger eller lange harmonier.
Signalveien som defineres i artikkelen
BS-RoFormer konverterer først den blandede bølgeformen til et komplekst spektrogram. Båndprojeksjonen og den hierarkiske Transformeren estimerer en kompleks maske, masken legges på blandingens spektrum, og invers STFT rekonstruerer målbølgeformen. Mel-RoFormer endrer projeksjonen inne i fθ: overlappende mel-bånd erstatter den heuristiske, ikke-overlappende delingen. Den erstatter ikke hele rekonstruksjonsveien.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: blandingens komplekse spektrogram, inkludert reelle og imaginære komponenter.
fθ: båndprojeksjon, Transformere innenfor og mellom bånd samt maskeestimering.
M̂: den komplekse målmasken som brukes til å gjenskape magnitude og fase.
ŷ: bølgeformen som rekonstrueres med invers STFT og begrenses av bølgeforms- og spektraltap under trening.
Derfor er Mel-Band RoFormer en sterk retning for vokal/akkompagnement, hovedvokal/bakgrunnsvokal og uttrekk av ren vokal. Problemet er at separasjon i fire stems ikke bare handler om vokaler. Den må også skille drums, bass og other, og other inneholder ofte de vanskeligste høyfrekvente instrumentdetaljene.
Etter artiklene: Slik ble RoFormer et åpent verktøyøkosystem
BS-RoFormer kom i september 2023 med to typer dokumentasjon i én artikkel. Det større L=12-systemet, trent på MUSDB18HQ pluss 500 interne sanger, dokumenterte SAMI-ByteDance sitt bidrag som tok førsteplassen i SDX23. Mindre modeller som bare brukte MUSDB18HQ, leverte kontrollerte ablasjoner for RoPE, bånddeling og rekonstruksjon med overlap-and-average. Artikkelen publiserte arkitektur, treningsbetingelser og resultattabeller. Den la ikke ved den opprinnelige SDX23-checkpointen eller lenket til et trenings- og inferensdepot fra ByteDance/SAMI.
Mel-Band RoFormer fulgte i oktober 2023. Den beholdt RoPE Transformere, sekvensmodellering innenfor og mellom bånd, komplekse masker og bølgeformsrekonstruksjon, men erstattet den håndutformede, ikke-overlappende delingen med 60 overlappende mel-bånd. Mellomrommet på én måned er viktig: Dette var en offentlig revisjon av frekvensprojeksjonen, utløst av den tidligere artikkelens egen begrensning, ikke en ny offisiell checkpointpakke utgitt sammen med teksten.
Kjørbar kode samlet seg utenfor artiklene. lucidrains-depotet omsatte diagrammene og ligningene til PyTorch-modellklasser og oppfordret åpent andre til å reprodusere separatoren. Stereohåndtering, flere utdatastems og Mel-Band-varianten gjorde strukturen gjenbrukbar, men kode alene kunne ikke gjenskape de interne sangene, optimizertilstanden, treningsvarigheten eller de endelige konkurranseparameterne.
Music-Source-Separation-Training ga deretter denne gjenbrukbare strukturen et felles verksted: datasettlastere, datautvidelse, trening, validering, gjenopptakelse fra checkpoint, segmentert inferens, overlapping og ensembler. Prosjektets README krediterer lucidrains for å gjenskape RoFormer-modellene fra artiklene og tar imot modellbidrag fra fagmiljøet. Én arkitektur kunne nå trenes for separasjon av vokal/instrumental, fire stems, understems for trommer eller andre spesialiserte mål. Det fantes ikke én kanonisk vekt fra fagmiljøet.
Vokalmodellen til Kimberley Jensen gjorde prosessen konkret. Depotet opplyser at den ble trent på mer data med ZFTurbo sin kode, bruker et åtte sekunder langt segment som standard og gjør num_overlap tilgjengelig for å redusere skjøteartefakter på bekostning av lengre inferens. Det krediterer også bidragsytere til datasettet. Disse detaljene forklarer hvorfor en nedlastbar checkpoint har en karakter som et arkitekturnavn alene ikke kan beskrive.
Den nåværende MVSep-siden tilskriver Kimberley Jensen de første offentlige vektene av høy kvalitet og beskriver deretter senere endring og videre trening av de åpne vektene. Utgaver fra Bas Curtiz, unwa, becruily, gabox og andre vises på samme side med ulike avveininger mellom fylde, gjennomslag, støy og SDR. Dette er en forgrenet vektgenealogi: Modellene deler Mel-Band RoFormer, men ikke data, mål, finjusteringshistorikk eller endelig lyd.
Sammenfatning basert på de to RoFormer-artiklene, lucidrains sin implementering og treningsrammeverket ZFTurbo/MVSep. Pilene viser implementeringsavhengighet, ikke offisiell godkjenning.
Navn eller artefakt
Hva det identifiserer
Hva som fortsatt trenger dokumentert opphav
BS-RoFormer / Mel-Band RoFormer
Design med båndprojeksjon, RoPE og aksial sekvensmodellering.
Den konkrete checkpointens trener, data, målstems og evalueringssett.
En nedlastbar checkpointfil
Ett parametersett som vanligvis avhenger av en samsvarende konfigurasjon.
Om den kommer fra artikkelforfatterne, trening i fagmiljøet eller senere finjustering.
En vertet Mel-Band / BS-RoFormer-arbeidsflyt
Tjenesten har valgt vekter, segmentering, overlapping og utdata.
Skårer fra vertede arbeidsflyter kan ikke gis nye merkelapper som SDX23-resultater eller resultater fra den opprinnelige artikkelen.
Ett arkitekturnavn kan nå vise til et konkurransesystem, en ablasjon i en artikkel, en vokalcheckpoint, en checkpoint for fire stems eller et plattformensemble. Presis tekst må synliggjøre tre ting: hvem som foreslo arkitekturen, hvor de nåværende vektene kom fra, og hvilken inferensoppskrift som leverer resultatet. Uten alle tre føyer formuleringer som «offisiell ByteDance-modell» eller «Mel-Band-konkurranseskår for fire stems» stilltiende sammen ulike artefakter fra ulike tidspunkter i denne historien.
Kontrollert sammenligning: Mel erstatter ikke BS på tvers av alle stems
Det klareste beviset er den kontrollerte sammenligningen i Mel-Band-artikkelen fra 2023, ikke en blanding av MVSep-sider og urelaterte checkpoints fra fagmiljøet. Hver rad nedenfor bruker MUSDB18HQ uten ekstra sanger. Innenfor hver dybde er den viktigste endringen projeksjonen: BS-RoFormers heuristiske, ikke-overlappende bånd erstattes av 60 overlappende mel-bånd.
Resultatet er en avveining, ikke en seier over hele linjen. Ved L=6 stiger vocals fra 10.78 til 11.21 dB og drums fra 9.61 til 9.91 dB, mens bass faller fra 11.43 til 9.64 dB og other går svakt ned fra 7.86 til 7.81 dB. Ved L=9 øker vocals med 0.58 dB og other med 0.13 dB, drums taper 0.32 dB, og bass rapporteres ikke fordi treningen gikk for sakte.
Modell i artikkelen (MUSDB18HQ, ingen ekstra data)
Vocals
Bass
Drums
Other
Gjennomsnittlig SDR
Parametere
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
ikke rapportert
9.34
7.93
ikke rapportert
94.8M
Artikkelen knytter bassresultatet til frekvenskartleggingen. BS-RoFormer tildeler bevisst fine bånd ved lave frekvenser, mens mel-projeksjonen er mer nyttig for vokaler og enkelte mål som ikke er bass. Den nyttige tekniske konklusjonen er derfor oppgavespesifikk: Mel-projeksjon er et sterkt vokalvalg, men en psykoakustisk begrunnelse beviser ikke i seg selv dominans ved fire stems.
SCNet og målet med fire stems
SCNet ser på spekteret fra et mer informasjonsorientert perspektiv. Artikkelforfatterne omfatter Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu og Helen Meng; tittelsiden oppgir blant annet Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab og The Chinese University of Hong Kong som tilhørigheter. Arkitektonisk deler SCNet uttrykkelig blandingens spektrogram inn i delbånd og bruker sparsom komprimering for å håndtere den ulike informasjonstettheten i disse båndene. Enklere sagt legger den ikke nesten all kapasitet i vokalområdet. Den får modellen til å konsentrere seg om tids-frekvensområder som faktisk inneholder nyttige instrumentsignaler.
Dette er viktig for fire stems. Bassen ligger lavt, men inneholder viktige overtoner. Trommer kombinerer svært korte transienter med cymbaler og romlyd. Other kan inneholde gitar, piano, strykere, synther og effekter samtidig. Delbåndsmodellering gir ulike frekvensområder mer målrettet behandling, mens sparsom komprimering holder oppmerksomheten unna tomme områder eller områder med lite informasjon.
SCNet-artikkelen beskriver hele systemet som en lydkoder, et separasjonsnettverk basert på dual-path RNN og en lyddekoder. Koderen kartlegger blandingen til delbåndsrepresentasjoner i frekvensdomenet, separasjonsnettverket modellerer struktur på tvers av tid og frekvens, og dekoderen rekonstruerer målstemmene.
Huge-SCNet-4stems V1.2 hører til denne retningen. Utdatakontrakten er et balansert sett med filer for vocals, drums, bass og other som kan gå videre til remiksing eller transkripsjon, fremfor et mål som bare er optimalisert for vokal.
Det er også viktig å skille SCNet-artikkelen fra Huge-SCNet-4stems V1.2-checkpointen. Artikkelen leverer arkitekturen med sparsom komprimering, delbåndsdesignet og forskningsresultatet på MUSDB18-HQ; den nedlastbare artefakten er den offentlige Hugging Face-checkpointen huge_scnet_4stems_v1.2.ckpt. Denne checkpointen fra fagmiljøet kan ikke arve artikkelens resultat på 9.0 dB på MUSDB18-HQ fordi dataene og utgivelsesopphavet er forskjellige.
Kodegrensen må også holdes atskilt. Artikkelforfatterne publiserer thuhcsi/SCNet som det offisielle implementeringsdepotet, men depotet sier at treningskoden fortsatt skal fullføres, og viser leserne til HTDemucs, Music-Source-Separation-Training og SCNet-PyTorch som midlertidige treningsrammeverk. Huge-SCNet-4stems V1.2 bør derfor beskrives som et offentlig checkpointvalg for fire stems i SCNet-retningen, ikke som den offisielle modellpakken fra SCNet-artikkelen.
MVSep Ensemble som plattformarbeidsflyt
MVSep Ensemble 2025.06.30 representerer en arbeidsflyt med flere modeller på plattformnivå. Den offentlige algoritmesiden oppgir mer enn én modellfamilie. Vokalveien kan bruke UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL og andre retninger, mens bass, drums og other kan bruke forskjellige Demucs-modeller eller beslektede modeller.
Styrken til denne typen ensemble kommer fra spesialisering: Vokaltungt materiale tildeles vokalspesialister, materiale med mye lavfrekvent og transientrik informasjon tildeles sterkere instrumentseparatorer, og deretter flettes resultatene sammen. Det kan være en referanse for kvalitetstaket, men det er ikke én checkpoint og ikke en selvstendig modell som en bruker kan reprodusere ved å laste ned én fil.
MVSep oppgir gjennomsnittlig SDR for ensemblet fra 2025.06.30 til 13.67. Tallet er nyttig som et tak for en vertet plattform, men bør ikke plasseres i samme rad som en selvstendig checkpoint. Det gjenspeiler en arbeidsflyt på serversiden som kan kombinere vokal, instrumental, bass, drums, other og flere instrumentspesifikke veier før sluttresultatet produseres.
Derfor må plattformensembler holdes utenfor enkeltmodellkategorien når temaet er én nedlastbar modell for fire stems. Ellers flyttes sammenligningen fra modellarkitektur til en vertet arbeidsflyt.
Offentlig sammenligning av fire stems
Tabellen nedenfor bruker tall fra de siterte offentlige modell- og benchmarksidene. Skårene bidrar til å plassere hver modell under det samme målet med fire stems. De bør ikke leses som en absolutt dom for enhver sang, sjanger eller lyttesituasjon.
Kildeomfanget er bevisst smalt: Raden på 10.02 dB for Huge-SCNet-4stems V1.2 kommer fra den offentlige HF/MVSep-referansen; SCNet XL IHF, BS Roformer og HTDemucs4 bruker offentlige ZFTurbo/MVSep Multisong-rader. Dette er ikke en blandet tabell med SCNet-artikkelens MUSDB18-HQ-resultater, Mel-Bands vokalsider og skårer fra MVSep Ensembles vertede arbeidsflyt.
Modell
Gjennomsnittlig SDR
Vocals
Drums
Bass
Other
Slik skal den leses
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Offentlig Huge-SCNet-checkpoint for fire stems i den siterte referansetabellen.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
En sterk selvstendig kandidat for fire stems, særlig for drums og bass.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Nyttig referanse for fire stems i retningen med bånddelt RoFormer.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Moden klassisk grunnlinje, men ikke taket for dagens kvalitet ved fire stems.
Slik leses skårene
Høyere SDR betyr vanligvis mindre forvrengning mot referansestemmen. Men gjennomsnittlig SDR kan ikke erstatte lytting, og det kan ikke flate ut hver stem til ett svar. Én modell kan være sterk på bass og drums, mens en annen holder vocals renere. Other er spesielt vanskelig fordi den inneholder mange instrumenter.
Verdien til Huge-SCNet-4stems V1.2 ligger i den klare artefaktgrensen: ett offentlig checkpointnavn, standardutdata i fire stems og sporbare offentlige referansetall. SCNet XL IHF er fortsatt en viktig sammenligning. MVSep Ensemble er fortsatt en vertet referanse for kvalitetstaket. De svarer på ulike spørsmål.
Brukere bør begynne med målet. Bruk vokalseparasjon for den reneste vokalen. Bruk separasjon i fire stems for redigerbare vocals, drums, bass og other. Bruk separasjon i seks stems når gitar og piano trenger hver sin fil.
Utdatagrense: Balanse i fire stems mot detaljer i seks stems
Separasjon i seks stems deler other videre opp i gitar, piano og gjenværende other. Den er mer følsom for gitaranslag, pianoattakker, keyboardtekstur og høyfrekvente overtoner. En BS Roformer SW-checkpoint for seks stems representerer derfor et annet mål og en annen treningskontrakt enn Huge-SCNet-4stems V1.2.
Disse påstandene hører til ulike lag: RoFormer beskriver en arkitekturfamilie, Mel-Band er rettet mot vokalrepresentasjon, SCNet balanserer fire stems, og MVSep-ensembler kombinerer vertede komponenter. Hver av dem svarer på et annet spørsmål om arkitektur, utdatamål, offentlig tilgjengelighet, arbeidsflytform eller inferenskontrakt.
Konklusjon: Velg arkitekturen, ikke moteordet
Separasjon i fire stems er ikke et omdøpt akkompagnementsspor og ikke et sted der den mest populære vokalmodellen limes på hvert instrument. Modellen må balansere vocals, drums, bass og other, særlig trommetransienter, bassens lave frekvenser, instrumentenes høye overtoner og kurven av blandede instrumenter i other.
Huge-SCNet-4stems V1.2 har en tydelig posisjon rundt dette standardmålet med fire stems. Mel-Band RoFormer er fortsatt viktig for å forstå vokalseparasjon, mens MVSep Ensemble fortsatt er nyttig som en vertet kvalitetsreferanse. Hver av dem tilhører et annet lag i forsknings- og implementeringshistorien.