模型
四軌音訊分離技術解析:從 MSS 架構演進看 Huge-SCNet 的模型取捨
TelkNet 目前四軌工具使用 Huge-SCNet-4stems V1.2,把完整混音分離為 Vocals、Drums、Bass 和 Other。文章從 MSS 架構演進、Mel-Band RoFormer 的強項與局限、SCNet 的子帶建模和公開四軌分數解釋這次模型取捨。

TelkNet 目前四軌工具使用 Huge-SCNet-4stems V1.2,把完整混音分離為 Vocals、Drums、Bass 和 Other。文章從 MSS 架構演進、Mel-Band RoFormer 的強項與局限、SCNet 的子帶建模和公開四軌分數解釋這次模型取捨。
技術解析 / Audio MSS
音樂源分離(Music Source Separation, MSS)的評估目標,已從「能不能分離」轉向「分軌能否繼續編輯」。重新混音、採譜、取樣、Music-to-MIDI、空間音訊重編與素材清理,都要求 stem 經得起二次處理,並能直接送進 DAW 繼續編曲。
標準四軌分離的目標,是把完整混音拆成人聲、鼓、貝斯與其他樂器四個標準聲部,而非只輸出「人聲 + 伴奏」。這表示模型必須同時處理主唱語意、鼓組瞬態、低頻骨架與高頻樂器邊界。模型在人聲上表現很強,不代表它一定最適合四軌任務;平台 ensemble 很強,也不代表它是一個可下載、可重現、可作單體比較的模型檔案。
Huge-SCNet-4stems V1.2 是一份針對標準四軌輸出的公開 checkpoint。MVSep Ensemble、SCNet XL IHF、BS-RoFormer、Mel-Band RoFormer 與 HTDemucs 分屬架構、公開權重或平台級工作流程,比較時必須保留這些層級差異。
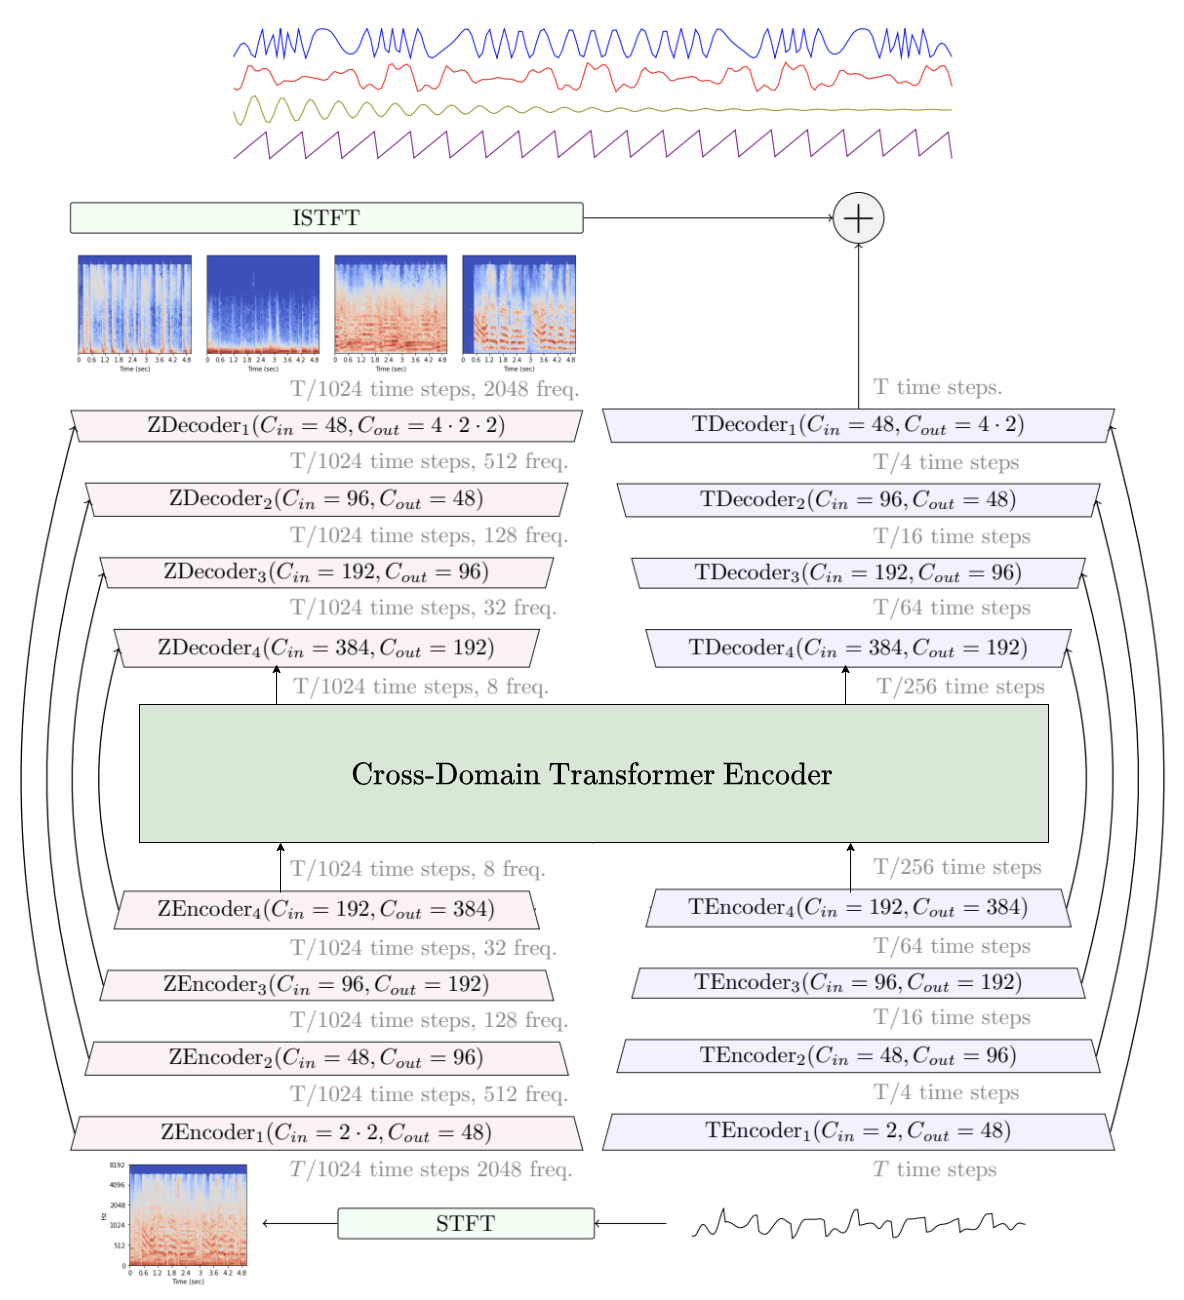
傳統雙軌分離把結果分為「人聲」與「伴奏」,適合卡拉 OK、翻唱、簡單混音及擷取清唱。標準四軌會進一步拆開伴奏,得到 Drums、Bass 與 Other 三個結構不同的聲部,主唱只是四個輸出之一。
Vocals 承載主唱語意、咬字、氣聲、和聲與混響尾音;Drums 負責大鼓、小鼓、中鼓、銅鈸及打擊樂瞬態;Bass 提供低頻骨架、基音與部分泛音;Other 則收納吉他、鋼琴、弦樂、合成器、管樂、取樣音效,以及所有未被前三類涵蓋的樂器。Other 的內部成分最複雜,通常也是四軌任務中最容易出錯的一軌。
這項定義來自音樂源分離長期採用的基準傳統。MUSDB18 / MUSDB18-HQ 資料集以 vocals、drums、bass 與 other 組織 stem;社群討論 4-stem 模型時,通常預設的就是這項輸出目標。一般所說的「伴奏」,在數學上更接近 drums、bass 與 other 三條音軌重新相加後的結果,而不是天然存在的單一聲源。
這項區別會直接影響模型選擇。如果只要製作無人聲伴奏,人聲分離模型最為直接;如果要單獨練鼓、分析貝斯線,或把吉他、鋼琴當成取樣素材繼續加工,雙軌模型就會把太多內容混在一起。四軌分離的價值,是為後期製作保留可操作空間,不只是交付一個「聽起來像伴奏」的檔案。
標準四軌輸出對應 vocals、drums、bass、other,而不是「主唱 / 伴奏 / 節奏 / 其他」這類模糊定義。人聲、鼓、貝斯與其他樂器各自獨立後,重新混音、採譜、降噪、取樣或轉寫,才能沿著明確的 stem 邊界繼續處理。
音樂源分離的核心,是在時間與頻率交織的聲學空間中,把一個混合波形重新拆回多個聲源。早期模型已能產生可聆聽的結果,但常見問題始終存在:人聲串入其他音軌、鼓點殘留在伴奏中、貝斯與大鼓彼此混成一團、高頻泛音被抹平,或在編曲密集的高潮段落出現電子感 artifacts。
U-Net 與 VR 類路線把 STFT 後的頻譜當成影像處理,解決了「能不能分離」的問題,但它們較擅長局部紋理,不擅長理解長距離音樂結構。HTDemucs 與 MDX-Net 結合時域與頻域,明顯提升重建品質,也讓許多產品首次進入實用階段。到了 BS-RoFormer 與 Mel-Band RoFormer,Transformer、頻帶拆分及 RoPE 開始讓模型更擅長追蹤跨越時間的頻率軌跡,尤其在人聲、和聲、滑音與長延音上表現突出。
SCNet 把焦點轉向混合頻譜的資訊密度:保留主要訊號區域、壓縮低資訊區域,同時保護不同聲部的邊界。四軌任務必須在四個 stem 之間分配建模能力,這種處理方式比單獨最佳化人聲更貼近任務本身。
| 階段 | 代表路線 | 核心進展 | 仍然存在的問題 |
|---|---|---|---|
| 2020-2021 | VR Architecture / U-Net | 把頻譜圖當成影像處理,讓基礎人聲/伴奏分離具備實用性。 | 局部卷積視窗難以涵蓋長程音樂結構與相位關係。 |
| 2022-2023 | HTDemucs / MDX-Net | 結合波形域與頻譜域建模,提升重建品質與穩定性。 | 密集高潮、重度混響與複雜瞬態仍可能產生 artifacts。 |
| 2023-2024 | BS-RoFormer / Mel-Band RoFormer | 運用頻帶拆分、RoPE 與更強的時頻建模,處理人聲、和聲、滑音與延音。 | 人聲優勢不代表所有四軌樂器都能同樣穩定地分離。 |
| 2024-2026 | SCNet / Huge-SCNet | 透過子頻帶建模與稀疏壓縮,把運算集中在資訊更密集的時頻區域。 | 目標是標準四軌,不應混寫成六軌或平台 ensemble。 |
這條演進軸說明了一項容易被忽略的判斷:模型選擇不能只看「誰的人聲聽起來最乾淨」。四軌分離還必須保護鼓的瞬態、貝斯的基頻與泛音、人聲邊界,以及 Other 中的高頻樂器細節。任何一項受到犧牲,都會在後期編輯時變成實際成本。
SCNet 論文於 2024 年 1 月公開,Huge-SCNet-4stems V1.2 則是後續社群權重與產品選型脈絡中的公開 checkpoint。時間軸因此把 SCNet 架構與後續權重放在 2024-2026 區間。
Mel-Band RoFormer 由字節跳動 Speech, Audio, and Music Intelligence(SAMI)團隊提出。論文作者為 Ju-Chiang Wang、Wei-Tsung Lu 與 Minz Won,機構署名依論文首頁的 SAMI, ByteDance 記載。
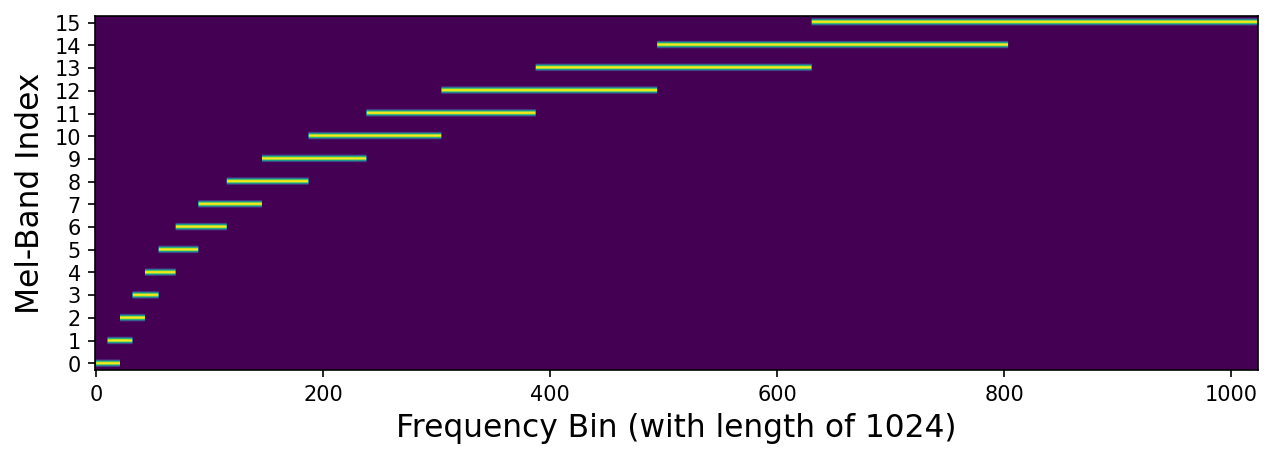
它的核心吸引力,在於讓頻帶組織方式更貼近人耳。人類對頻率的感知並非線性;100Hz 到 200Hz 的變化很明顯,10000Hz 到 10100Hz 的變化卻不一定容易察覺。Mel-scale 正是聲學中常用的非線性頻率尺度。Mel-Band RoFormer 把頻譜 bins 映射到依梅爾刻度組織的重疊子頻帶,讓中低頻區域獲得更細緻的表達。
這項設計對人聲尤其有利。主唱基頻、共振峰、子音、氣聲、顫音、滑音與許多混響尾音,都與中低頻及相鄰頻段的連續變化有關。Mel-band 投影讓模型更容易追蹤這些變化,而不是把它們視為一堆孤立的頻譜區塊。對清唱、人聲/伴奏、主唱/和聲等任務而言,它的優勢相當直接。
RoFormer 部分採用 RoPE,也就是旋轉位置編碼。它分別作用於時間序列與子頻帶序列,讓注意力分數明確保留相對位置關係。滑音、延音與跨小節重複都包含連續的位置變化;RoPE 對這些現象的幫助可從結構層面解釋,論文直接驗證的是有無 RoPE 的受控模型差異,並未單獨報告滑音或長和聲指標。
設 qm=RΘ,mdq、kn=RΘ,ndk。旋轉後的 query 與 key 內積可寫為:
內積只明確依賴相對位移 n−m。BS-RoFormer 分別在時間軸與子頻帶軸上使用 RoPE;論文消融顯示,移除 RoPE 後,模型訓練速度變慢、SDR 明顯下降。至於滑音、延音與和聲連續性,可以把它們視為這種相對位置建模的工程解釋,不能寫成論文另行測得的分項結論。
它的名稱基本就是技術路線本身:Mel 指梅爾頻帶,Ro 指 RoPE 旋轉位置編碼,Former 指 Transformer / 軸向注意力。需要特別釐清的是,SDX23 第一名的核心系統是它的前身 BS-RoFormer;Mel-Band RoFormer 是後續把 band-split 改為 mel-band 映射的改進路線。兩者關係密切,但不能把比賽結果、論文改進與社群權重混成一句話。
三個數字來自不同訓練條件或評測集合:9.80 與 11.99 屬於論文 MUSDB18HQ 表格,9.97 屬於 SDX23 私有排行榜。它們能說明 BS-RoFormer 的研究與比賽表現,卻不能拼成 Mel-Band RoFormer 的「官方四軌成績」。
BS-RoFormer 並非直接在波形上「辨識人聲」。它先對混音進行短時傅立葉轉換,把波形轉為複數頻譜 X;頻帶投影與分層 Transformer 在這個時頻表示上估計複數遮罩 M̂;遮罩與原始混音頻譜逐點相乘後,再經反向 STFT 還原成目標波形。Mel-RoFormer 改動的重點位於 fθ 內部:它把啟發式、互不重疊的 band split 改為依 mel scale 組織的重疊頻帶,而不是另行設計一套解碼器。
論文與可部署權重之間,還隔著完整的訓練工程。論文揭露了資料組成、8 秒訓練片段、隨機增益與靜音替換等資料增強方式、AdamW、學習率及部分精度設定,但未公開內部訓練歌曲、原始 optimizer state 或最終比賽 checkpoint。社群權重與平台仍須自行決定完整資料配方、分塊長度、overlap 及後處理;共用架構不等於具備相同的最終效能。
2023 年 9 月,BS-RoFormer 論文公開。論文記錄了 SAMI-ByteDance 參加 SDX23 Music Separation Track 的系統:以 MUSDB18HQ 加上 500 首內部歌曲訓練的 L=12 模型,在私有排行榜獲得第一名;同一篇論文也使用只以 MUSDB18HQ 訓練的小型模型進行消融,讓 RoPE、分頻方式及 overlap & average 的作用得以個別比較。這裡公開的是結構、訓練條件與結果表格。論文頁面並未附上原始 SDX23 checkpoint,也沒有連結 ByteDance/SAMI 官方訓練儲存庫或完整推論套件。
2023 年 10 月出現的 Mel-Band RoFormer 並非另起爐灶。作者沿著前一篇論文留下的問題繼續推進:BS-RoFormer 的 62 個非重疊頻帶來自經驗設計,低頻切分得很細,卻缺少統一的聲學座標。Mel-RoFormer 把前端改為 60 個彼此重疊的 Mel bands,保留 RoPE、inner-band / inter-band Transformer 與複數遮罩重建。兩篇論文前後只相隔約一個月,後者更像是針對頻帶投影的公開修訂,而非隨論文發布的新一代官方模型套件。
可執行程式碼是在論文之外逐步拼湊而成。lucidrains 的 BS-RoFormer 儲存庫把公式與結構圖實作為 PyTorch 類別,同時在 README 中直接邀請社群共同重現公開的音樂分離器。這項實作後續增加了立體聲、多 stem 輸出與 Mel-Band 版本;它讓研究架構可以實例化、進行前向運算與訓練,但不會自動還原比賽所用的內部歌曲、訓練時長、最佳化器狀態與最終參數。
接著出現的 Music-Source-Separation-Training 更像一間公共訓練工坊。模型類別被接入統一的資料讀取、資料增強、訓練、驗證、從中斷點續訓、分塊推論與 ensemble 指令碼,設定檔開始記錄 FFT、hop、batch、loss、chunk 與 overlap。儲存庫註明 RoFormer 架構由 lucidrains 依論文重現,也開放提交模型的管道。於是,同一個網路骨架可以被訓練成人聲/伴奏、四軌、鼓組細分或其他專用模型;這些方向並不存在唯一的「標準權重」。
Kimberley Jensen 的人聲模型,讓這段發展史首次有了易於下載與重現的具體範例。儲存庫說明該權重使用更多資料訓練,訓練程式碼來自 ZFTurbo,預設 chunk 為 352800 個取樣點,也就是 8 秒;推論時提高 num_overlap,可以減少音訊區塊重新拼接處的偽影,但也會延長處理時間。致謝內容也記錄了資料貢獻者。一個 checkpoint 的聽感由此落實到資料、視窗、重疊與訓練資源等細節,不再只是論文中的架構名稱。
MVSep 目前的演算法頁面把首批高品質公開權重歸於 Kimberley Jensen,並說明後續版本是在開放權重上修改、持續訓練;同一頁也列出 Bas Curtiz、unwa、becruily、gabox 等不同版本。有些追求更少的人聲串音,有些保留更完整的伴奏,也有頁面直接標示「更飽滿但更嘈雜」。這已是一棵不斷分支的權重譜系:共用 Mel-Band RoFormer 架構,卻不共用訓練集、目標函數、微調歷程或最終聽感。
| 文案中出現的名稱 | 它能說明什麼 | 還需補上哪項來源 |
|---|---|---|
| BS-RoFormer / Mel-Band RoFormer | 網路採用哪一種頻帶投影、RoPE 與雙軸序列建模。 | 特定 checkpoint 的訓練者、資料、目標 stem 與評測集。 |
| 某個公開 checkpoint 檔案 | 一組可供下載與推論的參數,通常還須搭配相符的 config。 | 它來自論文作者、社群訓練或後續微調,不能從檔名猜測。 |
| 平台中的 Mel-Band / BS-RoFormer 工具 | 平台已選定權重、分塊、重疊與輸出格式。 | 平台實測分數不能改寫成 SDX23 或論文原始成績。 |
這段發展史會直接改變產品文案。同一架構名稱之下,可能同時存在比賽系統、論文消融模型、人聲專用 checkpoint、四軌 checkpoint 與平台融合版本。準確的寫法至少要讓讀者看出三件事:架構由誰提出、目前權重來自何處、平台使用哪些推論設定交付結果。缺少其中任何一項,「ByteDance 官方模型」「Mel-Band 四軌比賽分數」等說法,就很容易把不同年代、不同產物拼在一起。
2023 年論文中的受控對照,最適合用來判斷 Mel-band 的改動。兩組模型都只使用 MUSDB18HQ,沒有加入額外歌曲;在相同深度下,主要變因是把前端從 BS-RoFormer 的非重疊啟發式頻帶,改為 60 個彼此重疊的 Mel bands。MVSep 頁面、人聲排行榜及其他社群權重採用不同訓練條件,不能併入這組實驗。
各 stem 的變化方向並不一致。L=6 時,人聲從 10.78 提高至 11.21 dB,鼓從 9.61 提高至 9.91 dB;bass 從 11.43 降至 9.64 dB,Other 從 7.86 小幅降至 7.81 dB,平均值由 9.92 降為 9.64 dB。L=9 時,人聲提高 0.58 dB、Other 提高 0.13 dB,鼓下降 0.32 dB;bass 因訓練進度過慢而未報告,平均值也無法計算。
| 論文模型(MUSDB18HQ,無額外資料) | Vocals | Bass | Drums | Other | 平均 SDR | 參數量 |
|---|---|---|---|---|---|---|
| BS-RoFormer L=6 | 10.78 | 11.43 | 9.61 | 7.86 | 9.92 | 72.2M |
| Mel-RoFormer L=6 | 11.21 | 9.64 | 9.91 | 7.81 | 9.64 | 84.2M |
| BS-RoFormer L=9 | 11.02 | 11.58 | 9.66 | 7.80 | 10.02 | 82.8M |
| Mel-RoFormer L=9 | 11.60 | 未報告 | 9.34 | 7.93 | 未報告 | 94.8M |
論文把原因指向頻帶映射:BS-RoFormer 的人工分頻在低頻切分得更細,正好適合能量集中於低頻的 bass;Mel 映射對人聲更友善,卻不是所有音色的完美座標。這項結論比「Mel 更符合人耳,所以一定更強」更具工程價值,因為它提醒部署者依目標 stem 選擇權重,而不是依架構熱度選模型。
SCNet(Sparse Compression Network,稀疏壓縮網路)從另一個角度處理音樂源分離:它更關注頻譜內部的資訊分布,而不是把所有表達能力都投注在某個聽感優勢區。論文作者包括 Weinan Tong、Jiaxu Zhu、Jun Chen、Shiyin Kang、Tao Jiang、Yang Li、Zhiyong Wu 與 Helen Meng;首頁列出的機構包括清華大學深圳國際研究生院、Skywork AI、鵬城實驗室與香港中文大學。
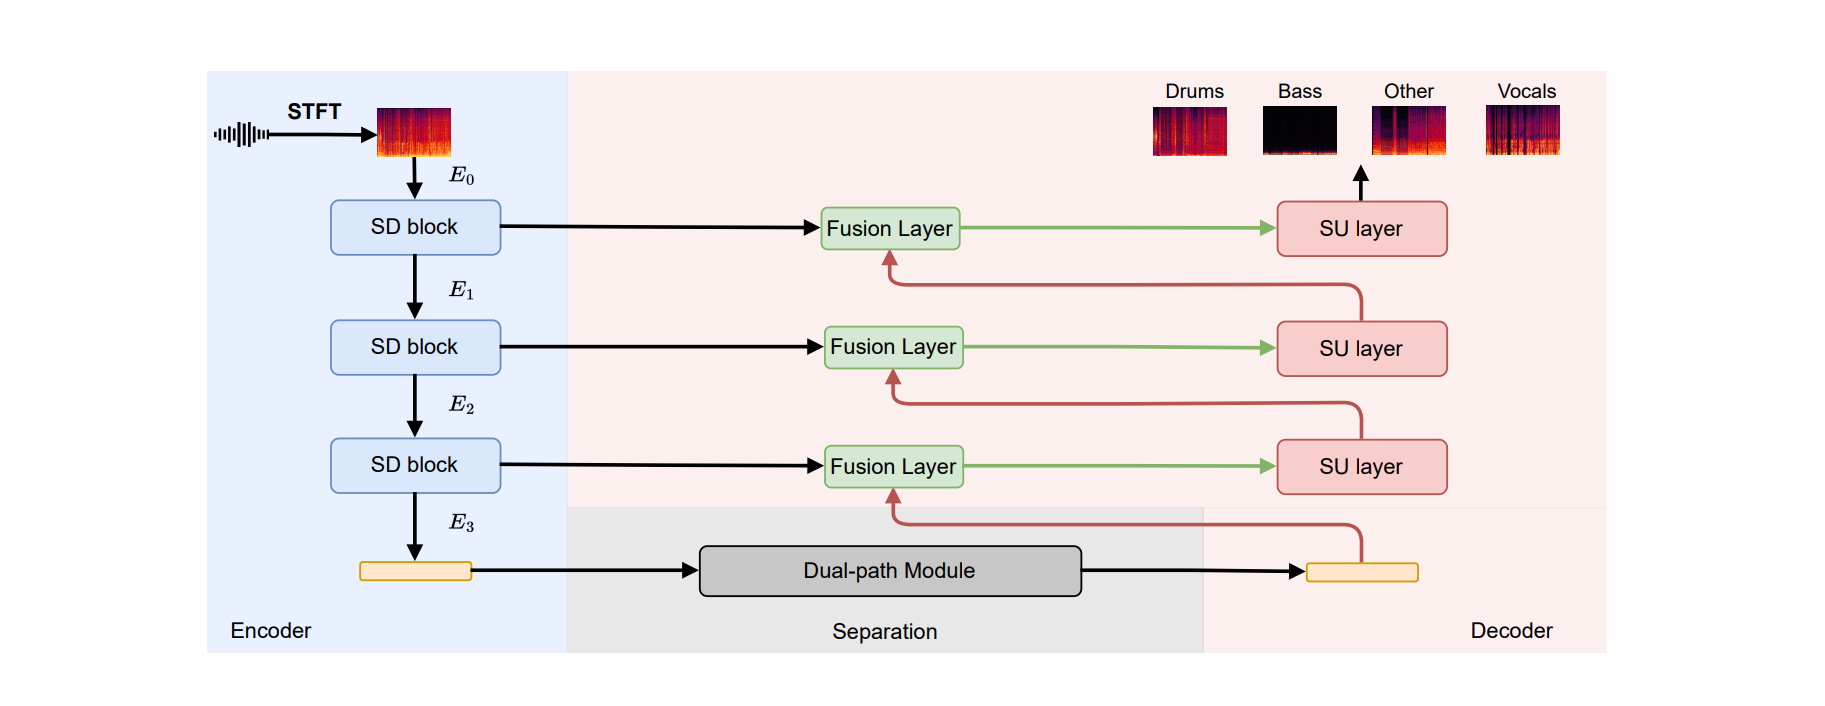
它的核心概念之一是子頻帶建模。不同樂器在頻譜中的位置、能量與稀疏性各不相同:貝斯主要位於低頻,但泛音會向上延伸;鼓有極短的瞬態,也有銅鈸的高頻空氣感;人聲有清楚的語意,也有混響尾音;Other 更為複雜,可能同時包含吉他、鋼琴、弦樂、合成器與效果音。把這些內容全部壓進同一種粗粒度表示,必然會造成彼此串擾。
SCNet 透過稀疏壓縮,削減有效訊號較少、資訊密度較低的時頻區域,把建模能力集中在擁擠、容易混淆的聲部邊界。不同頻段獲得的處理強度並不平均,目標是在保留有效資訊的同時降低運算冗餘。四軌任務最終要讓多個 stem 同時可用,只把單一音軌做得漂亮仍然不夠。
SCNet 論文把完整系統描述為 audio encoder、以 dual-path RNN 為基礎的 separation network,以及 audio decoder。編碼器把混合音訊映射為頻域子頻帶表示,分離網路沿時間與頻率建模,解碼器再重建目標 stem。換成產品語言,它的價值就是:鼓的瞬態不要糊掉、貝斯不要與大鼓黏在一起、人聲不要帶有過多伴奏殘留,Other 也不要變成一團高頻霧氣。
Huge-SCNet-4stems V1.2 屬於這條路線。它把輸出固定為人聲、鼓、貝斯與 Other,四個 stem 可分別進入重新混音、採譜與後期處理;這種均衡目標與只追求人聲乾淨的雙軌模型並不相同。
SCNet 論文提出稀疏壓縮網路架構、子頻帶設計與 MUSDB18-HQ 結果;Huge-SCNet-4stems V1.2 是 Hugging Face 上可下載的四軌 checkpoint,檔名為 huge_scnet_4stems_v1.2.ckpt。這份社群權重不能沿用 SCNet 論文的 9.0 dB MUSDB18-HQ 結果,兩者的資料與發布主體不同。
論文作者公開了 thuhcsi/SCNet 實作儲存庫,但儲存庫說明訓練程式碼仍待補齊,並建議暫時使用 HTDemucs、Music-Source-Separation-Training 或 SCNet-PyTorch 等訓練框架。Huge-SCNet-4stems V1.2 的完整表述是「以 SCNet 路線為基礎的公開四軌 checkpoint」,其來源不等同於論文作者的官方模型套件。
MVSep Ensemble 2025.06.30 是平台級多模型流程。公開演算法頁面依 stem 與任務特性組合多種模型:人聲路徑可能使用 UVR-MDX-NET、Demucs、MDX23C、VitLarge23、BS Roformer、Mel Roformer、SCNet XL;貝斯、鼓與 Other 又可能呼叫不同的 Demucs 或相關模型。它不屬於單一模型家族。
這類 ensemble 的強項來自分工:把人聲優勢明顯的素材交給人聲專家,把低頻與瞬態密集的素材交給能力更強的樂器分離器,再融合結果。它可以作為品質上限參考,但它不是一個 checkpoint,也不是使用者下載一個檔案就能重現的單體模型。把它列入「單體模型排行榜」,會讓比較對象從模型架構變成代管工作流程。
MVSep 頁面把 2025.06.30 版 ensemble 的平均 SDR 列為 13.67。這個數字可以說明代管平台組合多條模型鏈路後的上限,卻不能直接與單體 checkpoint 並列。它背後包含人聲、伴奏、貝斯、鼓、Other,以及額外細分樂器路徑的融合邏輯;其工程意義更接近「伺服器端工作管線」,而不是「一個模型檔案」。
MVSep Ensemble 描述的是多模型組合後的平台上限;Huge-SCNet-4stems V1.2 描述的是目前四軌工具採用的公開單體 checkpoint。兩者的評測對象與重現成本都不相同。
下表採用公開、可追溯的四軌參考數字。SDR 越高,通常表示目標 stem 相對於參考音軌的失真越少;不過平均 SDR 不能取代試聽,也不能把每個 stem 濃縮成單一答案。一個模型可能在貝斯與鼓上很強,另一個模型的人聲則可能更乾淨;Other 尤其困難,因為它包含許多樂器,而樂器類型會隨歌曲風格大幅變化。
這張表描述的是標準四軌任務中的整體取捨。讓四個 stem 都保持可編輯,與讓某一軌在聽感上最突出,是兩種不同的最佳化方向;前者更接近分軌素材,後者可能更適合一次性試聽。
表格的資料定義也已收窄:Huge-SCNet-4stems V1.2 的 10.02 dB 來自公開 HF / MVSep 參考列;SCNet XL IHF、BS Roformer 與 HTDemucs4 則使用 ZFTurbo / MVSep Multisong 公開列。這裡沒有混入 SCNet 論文的 MUSDB18-HQ 表格、Mel-Band 人聲頁面,也沒有混入 MVSep Ensemble 頁面的代管工作流程分數。
| 模型 / 架構路線 | 平均 4-Stem SDR | Vocals | Drums | Bass | Other | 定位說明 |
|---|---|---|---|---|---|---|
| Huge-SCNet-4stems V1.2 | 10.02 dB | 9.6073 dB | 11.7422 dB | 12.0639 dB | 6.6485 dB | 目前四軌工具的核心模型,四個 stem 的整體平衡度突出。 |
| SCNet XL IHF 4-stem | 9.92 dB | 9.68 dB | 11.58 dB | 11.94 dB | 6.48 dB | 強力的單體四軌候選,鼓與貝斯表現穩健,是重要參考線。 |
| BS Roformer 4-stem | 9.38 dB | 9.19 dB | 11.29 dB | 11.08 dB | 5.96 dB | RoFormer 路線的四軌參考,可從中觀察 Other 音軌的取捨。 |
| HTDemucs4 | 9.16 dB | 8.24 dB | 10.88 dB | 11.76 dB | 5.74 dB | 成熟的經典基準,生態系熟悉度高,但已非目前單體四軌的品質上限。 |
Huge-SCNet-4stems V1.2 的核心價值,在於它維持公開單體模型、標準四軌輸出與可追溯參考分數的前提下,實現各聲部最大公約數式的均衡。SCNet XL IHF 仍是重要對照,MVSep Ensemble 仍是品質上限參考,但它們回答的是不同問題。
四軌與六軌經常被放在一起討論,但兩者並非同一件事。四軌任務的核心是均衡:把混音拆成人聲、鼓、貝斯與 Other,並盡可能讓每一軌都能繼續編輯。六軌任務則進一步拆開 Other,通常會額外關注吉他、鋼琴等樂器的細分目標。
這會改變模型選擇。六軌分離對吉他掃弦、鋼琴擊弦、鍵盤紋理與高頻泛音更加敏感,也更容易在邊界處發生誤判。六軌工具使用 BS Roformer SW 6-stem,它與 Huge-SCNet-4stems V1.2 是不同模型,也代表不同的產品承諾。四軌工具不能承諾六軌結果,六軌模型也不能直接拿來取代四軌判斷。
RoFormer 的架構表現、Mel-Band 的人聲優勢、SCNet 的四軌均衡性,以及 MVSep Ensemble 的代管流程上限,分別對應不同問題。架構、輸出目標、權重來源與工作流程形態,構成四條獨立的證據線。
音訊分離模型在時間、頻率與資訊稀疏度上的取捨,決定了不同 stem 的邊界與後期可編輯性。熱門架構名稱本身,不能取代任務適配性的判斷。
Huge-SCNet-4stems V1.2 圍繞標準四軌的可編輯性設計。Mel-Band RoFormer 代表人聲分離的重要架構路線,MVSep Ensemble 則代表代管多模型流程的品質參照;前者是可下載的 checkpoint,後者是組合式工作流程。兩者與 SCNet 論文的研究結果,都應保留各自的邊界。