Разделение аудио на четыре стема: почему Huge-SCNet подходит цели MSS · TelkNet
Модель
Разделение аудио на четыре стема: почему Huge-SCNet подходит цели MSS
Текущий инструмент TelkNet для четырех стемов использует Huge-SCNet-4stems V1.2, чтобы разделить полный микс на вокал, барабаны, бас и прочее. Статья объясняет выбор через историю MSS, сильные стороны и границы Mel-Band RoFormer, субполосное моделирование SCNet и публичные оценки.
Разделение музыкальных источников с помощью ИИ вышло за рамки простого вопроса, можно ли извлечь вокал из микса. Для ремиксов, сэмплирования, репетиций, Music-to-MIDI, пространственного звука и очистки материала важнее понять, останется ли результат редактируемым. Стандартное разделение на четыре стема следует этой более строгой цели: полный микс делится на vocals, drums, bass и other вместо создания лишь файлов вокала и аккомпанемента.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer и Huge-SCNet-4stems V1.2 представляют разные подходы к четырём стемам. Одной силы вокала недостаточно, чтобы определить качество разделения на четыре стема. Платформенный ансамбль может получить высокую оценку, не являясь самостоятельной загружаемой моделью, а общедоступная контрольная точка предоставляет воспроизводимый артефакт.
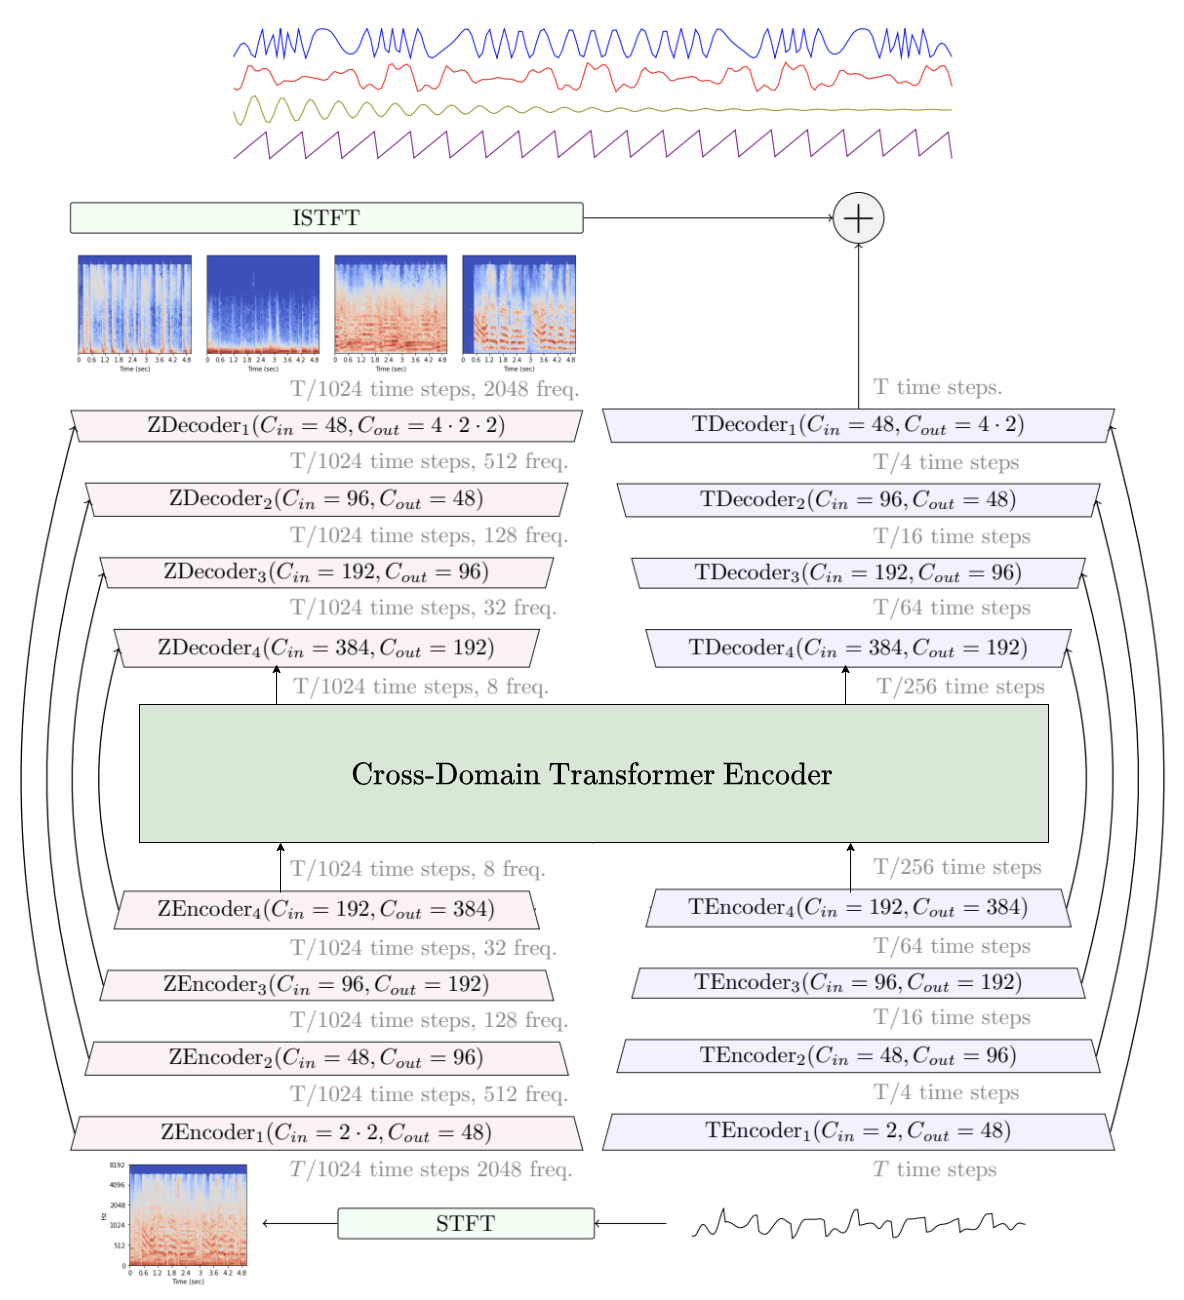
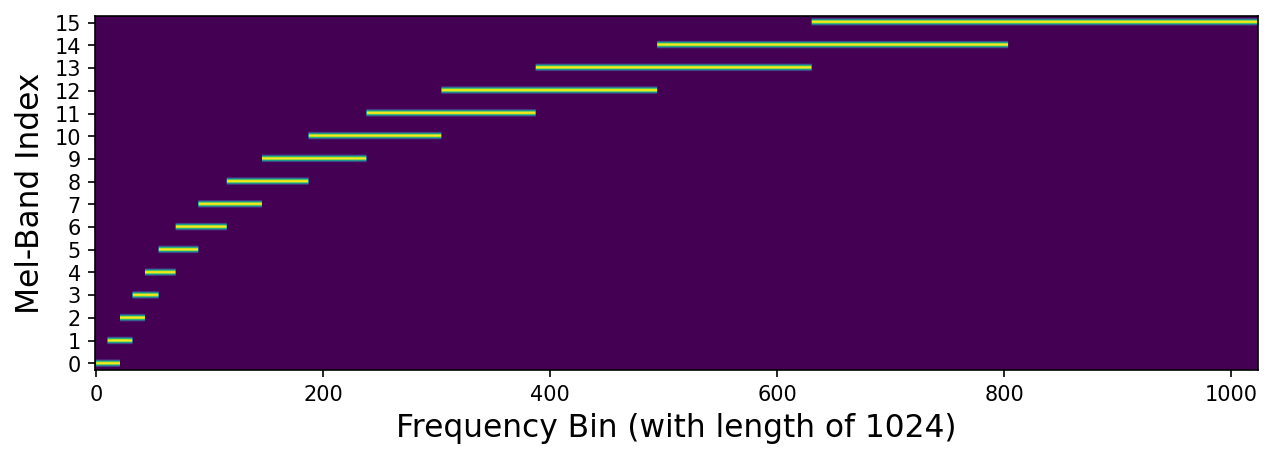
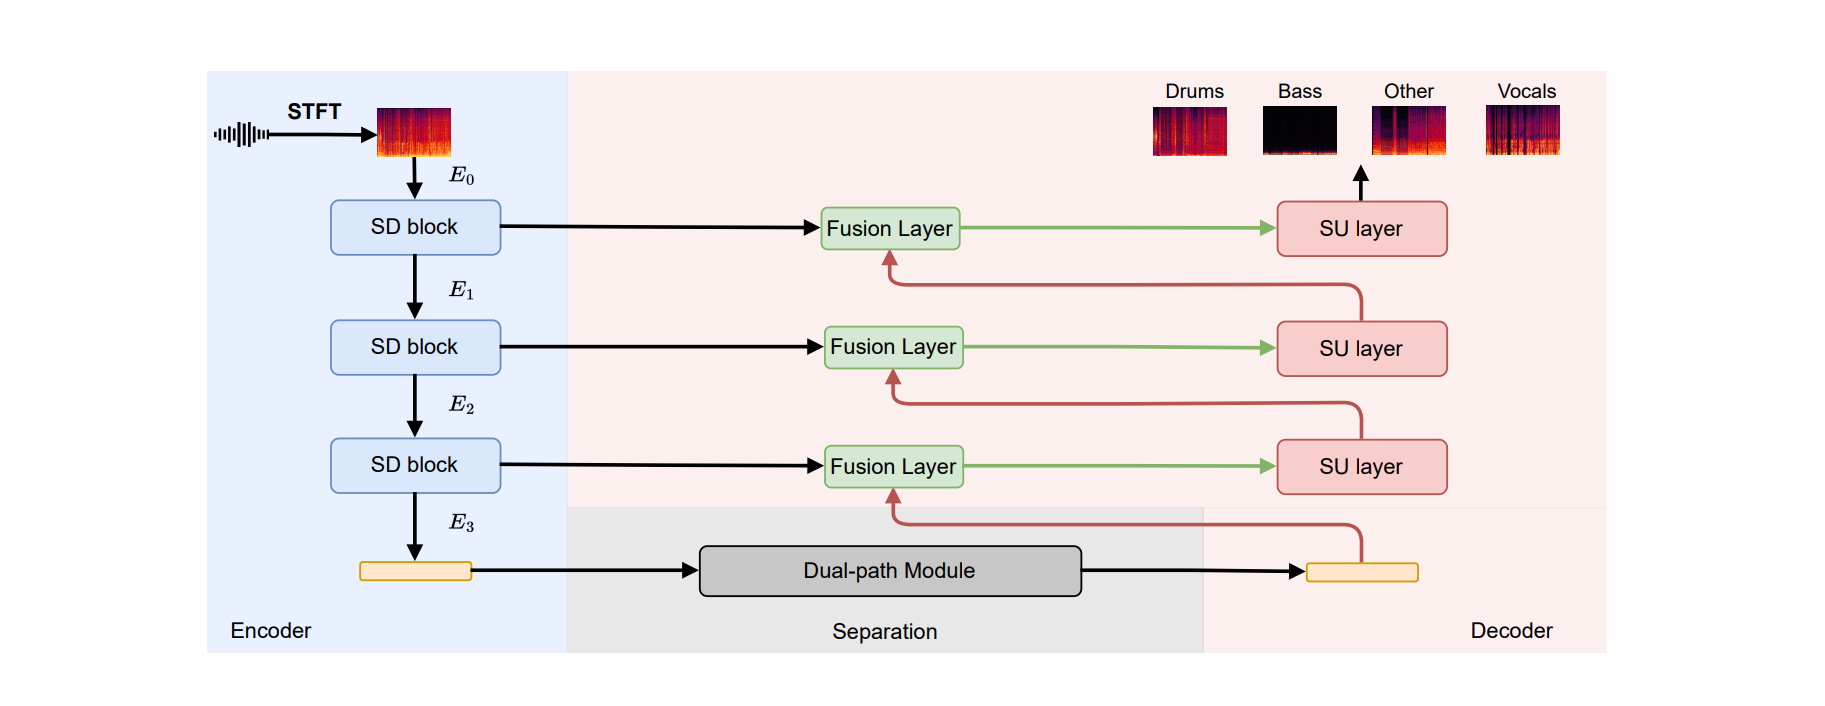
HTDemucs Официальная структурная диаграмма статьи: две ветви области формы сигнала и области спектра сходятся внутри модели. Типичный дизайн этапа «двойного домена» на временной шкале ниже выглядит следующим образом (источник: статья о гибридных трансформаторах, arXiv:2211.08553).Официальная диаграмма Mel-Band RoFormer Paper: как спектральные элементы сопоставляются с перекрывающимися поддиапазонами, организованными по шкале mel. Поддиапазоны, полученные на средне-низких частотах, более плотные, поэтому вокальные детали выражены более детально (источник: arXiv:2310.01809).Официальная схема архитектуры SCNet: Положение модуля разреженного сжатия между кодером и сетью разделения ясно с первого взгляда — сначала сжимаются области с низкой плотностью информации, а затем оставляют вычислительную мощность перегруженным голосовым границам (источник: документ SCNet, arXiv:2401.13276).
Общедоступные страницы алгоритмов и рейтинги MVSep часто служат ориентирами в разделении музыкальных источников. Они документируют результаты и конфигурации; ансамблевый процесс нельзя считать одной самостоятельной моделью.
Четыре стема — не другое название фонограммы
Стандартное разделение на четыре стема обычно означает vocals, drums, bass и other. Vocals — это дорожка пения, drums — ударная установка, bass — партия баса, а other содержит остальные инструменты: гитару, фортепиано, струнные, синтезаторы, духовые, эффекты и многое другое. Фонограмма, слышимая после отключения вокала, на самом деле является суммой drums, bass и other.
Эта цель происходит из основных наборов данных и традиции оценки в разделении музыкальных источников. MUSDB18 и MUSDB18-HQ долгое время формировали обучение и оценку моделей вокруг этих четырёх стемов. Когда сообщество говорит 4-stem, обычно имеется в виду именно эта цель вывода.
Различие влияет на выбор инструмента. Если нужен чистый вокал или инструментальная версия без вокала, прямее использовать двухстемовый разделитель вокала. Если нужны репетиции ударных, анализ баса, сэмплирование, ремиксы или редактируемая очистка материала, полезнее четыре стема. Other — не менее качественная фонограмма, а самая сложная корзина инструментов в системе.
Четыре этапа от U-Net до SCNet
Разделение музыкальных источников пытается восстановить несколько источников из одной смешанной волновой формы во времени и по частоте. Ранние модели уже давали пригодный для прослушивания результат, но артефакты были знакомыми: утечка вокала, примесь ударных, мутный бас, размытые высокие частоты или рваная фазовая текстура в плотных аранжировках.
Период
Характерное направление
Прогресс
Оставшаяся проблема
2020-2021
VR Architecture / U-Net
Рассматривало спектрограммы как изображения и сделало базовое разделение вокала и аккомпанемента практичным.
Локальные окна свёртки плохо справлялись с длинным музыкальным контекстом и фазовыми отношениями.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Объединило моделирование волновой формы и спектрограммы, улучшив качество и устойчивость реконструкции.
Плотные кульминации, сильная реверберация и сложные переходные процессы всё ещё могли создавать артефакты.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Использовало разбиение на полосы, RoPE и более мощное время-частотное моделирование для вокала, гармоний, глиссандо и протяжных звуков.
Частотное распределение с приоритетом вокала не обязательно лучше для всех инструментов в четырёх стемах.
Использовало моделирование поддиапазонов и разреженное сжатие, чтобы сосредоточиться на насыщенных информацией время-частотных областях.
Целью остаётся стандартное разделение на четыре стема, а не вывод шести стемов или платформенный ансамбль.
Эта история объясняет, почему выбор модели нельзя свести к качеству вокала. Разделение на четыре стема должно также сохранять переходные процессы ударных, основные тоны и гармоники баса, границы вокала и высокочастотные детали внутри other.
Временные рамки тоже ограничены источниками: статья о SCNet стала общедоступной в январе 2024 года, а Huge-SCNet-4stems V1.2 относится к более позднему контексту общедоступной контрольной точки. Поэтому в хронологии указан период 2024-2026, а не создаётся впечатление, будто сам SCNet появился лишь после 2025 года.
Mel-Band RoFormer: сила вокала и ограничения четырёх стемов
Mel-Band RoFormer предложила команда ByteDance Speech, Audio, and Music Intelligence (SAMI). Авторы статьи — Ju-Chiang Wang, Wei-Tsung Lu и Minz Won, а на титульной странице указана принадлежность SAMI, ByteDance. Страницы сообщества иногда обобщают это направление как ByteDance AI Labs, но точнее всего придерживаться формулировки источника: авторы статьи и SAMI, ByteDance.
Модель привлекательна тем, что формирует частотные полосы ближе к человеческому слуху. Ухо чувствительнее к низким и средним частотам, где находятся основные тоны вокала, согласные, дыхание и многие признаки высоты тона. Проекция мел-полос даёт этому диапазону более детальное представление и помогает модели отслеживать ведущий и бэк-вокал, глиссандо, вибрато и хвосты реверберации.
Семейство RoFormer использует вращательное позиционное кодирование, или RoPE, как во временных, так и в поддиапазонных последовательностях. Благодаря этому оценки внимания зависят от относительной позиции. Глиссандо, протяжные звуки и повторяющиеся фразы дают полезное структурное представление об этом свойстве, но статья непосредственно проверяет только контролируемые модели с RoPE и без него; отдельных метрик для глиссандо или длинных гармоний в ней нет.
Сигнальный тракт, заданный в статье
BS-RoFormer сначала преобразует волновую форму смеси в комплексную спектрограмму. Проекция полос и иерархический Transformer оценивают комплексную маску, маска применяется к спектру смеси, а обратное STFT реконструирует целевую волновую форму. Mel-RoFormer меняет проекцию внутри fθ: перекрывающиеся мел-полосы заменяют эвристическое разбиение без перекрытия. Весь тракт реконструкции при этом не меняется.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: комплексная спектрограмма смеси, включая действительную и мнимую составляющие.
fθ: проекция полос, Transformer внутри полос и между ними, а также оценка маски.
M̂: комплексная целевая маска для восстановления амплитуды и фазы.
ŷ: волновая форма, реконструированная обратным STFT и ограниченная потерями волновой формы и спектра во время обучения.
Поэтому Mel-Band RoFormer — сильное направление для разделения вокала/аккомпанемента, ведущего/бэк-вокала и извлечения чистого вокала. Проблема в том, что разделение на четыре стема занимается не только вокалом. Оно должно также отделить drums, bass и other, причём other часто содержит самые сложные высокочастотные инструментальные детали.
После статей: как RoFormer стал открытой экосистемой инструментов
BS-RoFormer появился в сентябре 2023 года с двумя видами доказательств в одной статье. Более крупная система L=12, обученная на MUSDB18HQ и 500 внутренних песнях, задокументировала занявшую первое место заявку SAMI-ByteDance на SDX23. Меньшие модели только на MUSDB18HQ обеспечили контролируемые абляции для RoPE, разбиения на полосы и реконструкции с перекрытием и усреднением. В статье опубликованы архитектура, условия обучения и таблицы результатов. К ней не прилагалась исходная контрольная точка SDX23, и она не содержала ссылки на репозиторий обучения и инференса ByteDance/SAMI.
Mel-Band RoFormer вышел в октябре 2023 года. Он сохранил RoPE Transformer, моделирование последовательностей внутри полос и между ними, комплексные маски и реконструкцию волновой формы, но заменил разработанное вручную разбиение без перекрытия на 60 перекрывающихся мел-полос. Месячный интервал важен: это была общедоступная редакция частотной проекции, вызванная ограничением предыдущей статьи, а не второй официальный пакет контрольной точки, выпущенный вместе с текстом.
Исполняемый код накапливался вне статей. Репозиторий lucidrains превратил диаграммы и уравнения в классы моделей PyTorch и открыто предложил другим воспроизвести разделитель. Поддержка стерео, нескольких выходных стемов и варианта Mel-Band сделала структуру многократно используемой, но один только код не мог восстановить внутренние песни, состояние оптимизатора, продолжительность обучения или окончательные конкурсные параметры.
Затем Music-Source-Separation-Training предоставил этой многократно используемой структуре общую мастерскую: загрузчики наборов данных, аугментацию, обучение, валидацию, продолжение с контрольной точки, сегментированный инференс, перекрытие и ансамблирование. В README выражена благодарность lucidrains за воссоздание моделей RoFormer по статьям и принимаются модели от сообщества. Теперь одну архитектуру можно было обучать для разделения вокала/инструментала, четырёх стемов, подстемов ударных или других специализированных целей. Единого канонического веса сообщества не существовало.
Вокальная модель Kimberley Jensen сделала процесс конкретным. В репозитории сказано, что она обучена на большем объёме данных с помощью кода ZFTurbo, по умолчанию использует восьмисекундный сегмент и предоставляет num_overlap, чтобы уменьшить артефакты склейки ценой более долгого инференса. Там также отмечены участники создания набора данных. Эти детали объясняют, почему загружаемая контрольная точка обладает характером, который невозможно описать одним названием архитектуры.
Текущая страница MVSep приписывает Kimberley Jensen первые высококачественные общедоступные веса, а затем описывает последующие изменения и продолжение обучения открытых весов. Версии Bas Curtiz, unwa, becruily, gabox и других находятся на той же странице и имеют разные компромиссы по полноте, утечке, шуму и SDR. Это разветвлённая генеалогия весов: модели используют Mel-Band RoFormer, но не одни и те же данные, целевую функцию, историю дообучения или итоговое звучание.
Обобщение на основе двух статей о RoFormer, реализации lucidrains и обучающей среды ZFTurbo/MVSep. Стрелки показывают зависимость реализации, а не официальное одобрение.
Название или артефакт
Что он определяет
Что ещё требует подтверждённого происхождения
BS-RoFormer / Mel-Band RoFormer
Схема проекции полос, RoPE и осевого моделирования последовательностей.
Разработчика конкретной контрольной точки, данные, целевые стемы и набор оценки.
Загружаемый файл контрольной точки
Один набор параметров, который обычно зависит от соответствующей конфигурации.
Происходит ли он от авторов статьи, обучения сообщества или последующего дообучения.
Хостинговый процесс Mel-Band / BS-RoFormer
Сервис выбрал веса, сегментацию, перекрытие и выходы.
Оценки хостингового процесса нельзя переименовывать в результаты SDX23 или исходной статьи.
Одно название архитектуры теперь может обозначать конкурсную систему, абляцию из статьи, вокальную контрольную точку, контрольную точку для четырёх стемов или платформенный ансамбль. Точный текст должен раскрывать три вещи: кто предложил архитектуру, откуда взялись текущие веса и какой рецепт инференса даёт результат. Без всех трёх формулировки вроде «официальная модель ByteDance» или «конкурсная оценка Mel-Band для четырёх стемов» незаметно сшивают разные артефакты из разных моментов этой истории.
Контролируемое сравнение: Mel не заменяет BS для каждого стема
Самое чистое доказательство — контролируемое сравнение из статьи о Mel-Band 2023 года, а не смесь страниц MVSep и не связанных между собой контрольных точек сообщества. Каждая строка ниже использует MUSDB18HQ без дополнительных песен. На каждой глубине основным изменением является проекция: эвристические полосы BS-RoFormer без перекрытия заменены 60 перекрывающимися мел-полосами.
Результат — компромисс, а не победа по всем пунктам. При L=6 vocals растёт с 10.78 до 11.21 dB, а drums — с 9.61 до 9.91 dB, тогда как bass падает с 11.43 до 9.64 dB, а other немного снижается с 7.86 до 7.81 dB. При L=9 vocals получает 0.58 dB, other — 0.13 dB, drums теряет 0.32 dB, а bass не указан, поскольку обучение шло слишком медленно.
Модель из статьи (MUSDB18HQ, без дополнительных данных)
Vocals
Bass
Drums
Other
Средний SDR
Параметры
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
не указано
9.34
7.93
не указано
94.8M
Статья связывает результат баса с частотным отображением. BS-RoFormer намеренно выделяет мелкие полосы на низких частотах, а мел-проекция полезнее для вокала и некоторых небасовых целей. Практический инженерный вывод поэтому зависит от задачи: мел-проекция — сильный выбор для вокала, но одной психоакустической мотивации недостаточно, чтобы доказать превосходство для четырёх стемов.
SCNet и цель четырёх стемов
SCNet рассматривает спектр с более информационно ориентированной позиции. Среди авторов статьи Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu и Helen Meng; на титульной странице среди организаций указаны Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab и The Chinese University of Hong Kong. Архитектурно SCNet явно делит спектрограмму смеси на поддиапазоны и использует разреженное сжатие, чтобы обрабатывать разную плотность информации в этих диапазонах. Проще говоря, он не вкладывает почти всю ёмкость в вокальный диапазон. Он направляет модель на время-частотные области, в которых действительно находится полезный инструментальный сигнал.
Это важно для четырёх стемов. Бас расположен низко, но содержит важные гармоники. Ударные сочетают очень короткие переходные процессы с тарелками и звучанием помещения. Other может одновременно содержать гитару, фортепиано, струнные, синтезаторы и эффекты. Моделирование поддиапазонов позволяет обрабатывать разные частотные области более адресно, а разреженное сжатие отводит внимание от пустых или малоинформативных областей.
Статья о SCNet описывает полную систему как аудиоэнкодер, сеть разделения на основе dual-path RNN и аудиодекодер. Энкодер отображает смесь в поддиапазонные представления частотной области, сеть разделения моделирует структуру во времени и по частоте, а декодер реконструирует целевые стемы.
Huge-SCNet-4stems V1.2 относится к этому направлению. Её выходной контракт — сбалансированный набор файлов vocals, drums, bass и other, которые можно далее использовать для ремиксов или транскрипции, а не цель, оптимизированная только под вокал.
Важно также отделять статью о SCNet от контрольной точки Huge-SCNet-4stems V1.2. Статья предлагает архитектуру разреженного сжатия, схему поддиапазонов и исследовательский результат на MUSDB18-HQ; загружаемым артефактом является общедоступная контрольная точка Hugging Face huge_scnet_4stems_v1.2.ckpt. Эта контрольная точка сообщества не может наследовать результат статьи 9.0 dB на MUSDB18-HQ, поскольку данные и происхождение выпуска различаются.
Границу кода тоже нужно сохранять отдельно. Авторы статьи публикуют thuhcsi/SCNet как официальный репозиторий реализации, но в нём сказано, что обучающий код ещё предстоит завершить, а читатели направляются к HTDemucs, Music-Source-Separation-Training и SCNet-PyTorch как к временным средам обучения. Поэтому Huge-SCNet-4stems V1.2 следует описывать как общедоступный вариант контрольной точки для четырёх стемов в направлении SCNet, а не как официальный пакет модели из статьи о SCNet.
MVSep Ensemble как платформенный процесс
MVSep Ensemble 2025.06.30 представляет платформенный процесс с несколькими моделями. На общедоступной странице алгоритма указано более одного семейства моделей. Вокальный тракт может использовать UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL и другие направления, а bass, drums и other могут задействовать разные модели Demucs или родственные модели.
Сила такого ансамбля происходит из специализации: материал с преобладанием вокала передаётся вокальным специалистам, материал с преобладанием низких частот и переходных процессов — более сильным разделителям инструментов, а затем результаты объединяются. Это может быть ориентиром потолка качества, но не является одной контрольной точкой или самостоятельной моделью, которую пользователь воспроизведёт, загрузив один файл.
MVSep указывает для ансамбля 2025.06.30 средний SDR 13.67. Это число полезно как потолок хостинговой платформы, но его не следует ставить в одну строку с самостоятельной контрольной точкой. Оно отражает серверный процесс, который может объединять вокальный, инструментальный, bass, drums, other и дополнительные специализированные инструментальные тракты перед формированием окончательного результата.
Поэтому при обсуждении одной загружаемой модели для четырёх стемов платформенные ансамбли нужно оставлять за пределами категории одиночных моделей. Иначе сравнение смещается от архитектуры модели к хостинговому процессу.
Общедоступное сравнение четырёх стемов
В таблице ниже используются показатели с указанных общедоступных страниц моделей и тестов. Оценки помогают расположить каждую модель в рамках одной цели четырёх стемов. Их не следует считать абсолютным вердиктом для любой песни, жанра или ситуации прослушивания.
Область источников намеренно узкая: строка Huge-SCNet-4stems V1.2 с 10.02 dB взята из общедоступного источника HF / MVSep; для SCNet XL IHF, BS Roformer и HTDemucs4 используются общедоступные строки ZFTurbo / MVSep Multisong. Это не смешанная таблица результатов статьи о SCNet на MUSDB18-HQ, вокальных страниц Mel-Band и оценок хостингового процесса MVSep Ensemble.
Модель
Средний SDR
Vocals
Drums
Bass
Other
Как это читать
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Общедоступная контрольная точка Huge-SCNet для четырёх стемов в указанной справочной таблице.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Сильный самостоятельный кандидат для четырёх стемов, особенно в drums и bass.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Полезный ориентир для четырёх стемов в направлении RoFormer с разбиением на полосы.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Зрелая классическая базовая линия, но не потолок нынешнего качества четырёх стемов.
Как читать оценки
Более высокий SDR обычно означает меньше искажений относительно эталонного стема. Но средний SDR не заменяет прослушивание и не может свести все стемы к одному ответу. Одна модель может быть сильной в bass и drums, а другая сохраняет более чистый vocals. Other особенно сложен, поскольку содержит много инструментов.
Ценность Huge-SCNet-4stems V1.2 заключается в чёткой границе артефакта: одно общедоступное название контрольной точки, стандартный вывод четырёх стемов и прослеживаемые общедоступные справочные показатели. SCNet XL IHF остаётся важным сравнением. MVSep Ensemble остаётся хостинговым ориентиром потолка качества. Они отвечают на разные вопросы.
Пользователям следует начинать с цели. Для самого чистого вокала используйте разделение вокала. Для редактируемых vocals, drums, bass и other используйте разделение на четыре стема. Используйте разделение на шесть стемов, когда гитаре и фортепиано нужны отдельные файлы.
Граница вывода: баланс четырёх стемов против детализации шести
Разделение на шесть стемов дополнительно делит other на гитару, фортепиано и оставшийся other. Оно чувствительнее к гитарным штрихам, атакам фортепиано, фактуре клавишных и высокочастотным гармоникам. Поэтому контрольная точка BS Roformer SW для шести стемов представляет иную цель и иной контракт обучения, чем Huge-SCNet-4stems V1.2.
Эти утверждения относятся к разным уровням: RoFormer описывает семейство архитектур, Mel-Band нацелен на представление вокала, SCNet балансирует четыре стема, а ансамбли MVSep объединяют хостинговые компоненты. Каждый отвечает на отдельный вопрос об архитектуре, цели вывода, общедоступности, форме процесса или контракте инференса.
Вывод: выбирайте архитектуру, а не модное слово
Разделение на четыре стема — не переименованная фонограмма и не место, где самую популярную вокальную модель применяют к каждому инструменту. Оно требует от модели баланса vocals, drums, bass и other, особенно переходных процессов ударных, низких частот баса, высоких гармоник инструментов и смешанной корзины инструментов внутри other.
Huge-SCNet-4stems V1.2 занимает чёткое место вокруг этой стандартной цели четырёх стемов. Mel-Band RoFormer остаётся важным для понимания разделения вокала, а MVSep Ensemble — полезным хостинговым ориентиром качества. Каждый относится к своему уровню истории исследований и внедрения.