Separación de audio en cuatro stems: por qué Huge-SCNet encaja con MSS · TelkNet
Modelo
Separación de audio en cuatro stems: por qué Huge-SCNet encaja con MSS
La herramienta actual de cuatro stems de TelkNet usa Huge-SCNet-4stems V1.2 para dividir una mezcla completa en voces, batería, bajo y otros. El artículo explica la elección con la evolución de MSS, los límites de Mel-Band RoFormer, el modelado por subbandas de SCNet y puntuaciones públicas de cuatro stems.
Noticias de modelos / Separación de fuentes musicales
Fecha de la noticia: 2026-06-30
Modelo actual de cuatro pistas: Huge-SCNet-4stems V1.2
Salida estándar: voz / batería / bajo / otros
Tema: arquitectura MSS, límites de Mel-Band RoFormer y compromisos de SCNet
Resumen
La separación de fuentes musicales mediante IA ya ha superado la pregunta básica de si es posible extraer una voz de una mezcla. Para remezclar, muestrear, practicar, convertir música a MIDI, trabajar con audio espacial y limpiar materiales, la pregunta útil es si el resultado sigue siendo editable. La separación estándar en cuatro pistas persigue ese objetivo más estricto: dividir una mezcla completa en voz, batería, bajo y otros, en lugar de producir únicamente archivos de voz y acompañamiento.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer y Huge-SCNet-4stems V1.2 representan distintos enfoques de separación en cuatro pistas. La calidad vocal por sí sola no determina la calidad del conjunto. Un ensamble de plataforma puede alcanzar una puntuación elevada sin ser un modelo independiente descargable, mientras que un checkpoint público ofrece un artefacto reproducible.
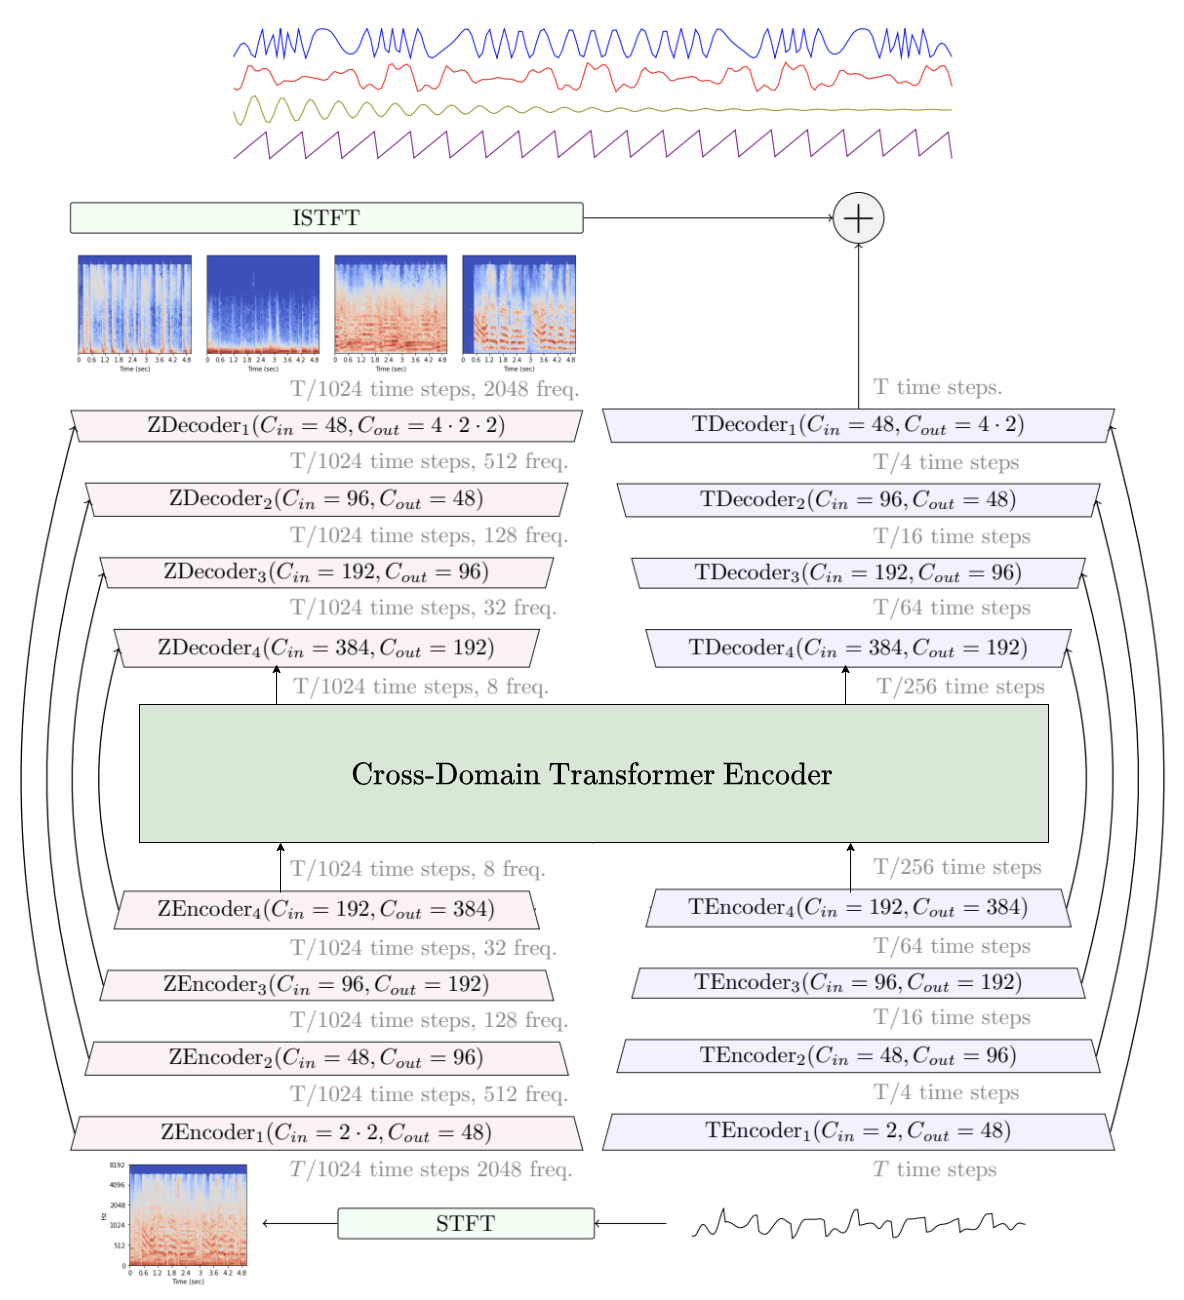
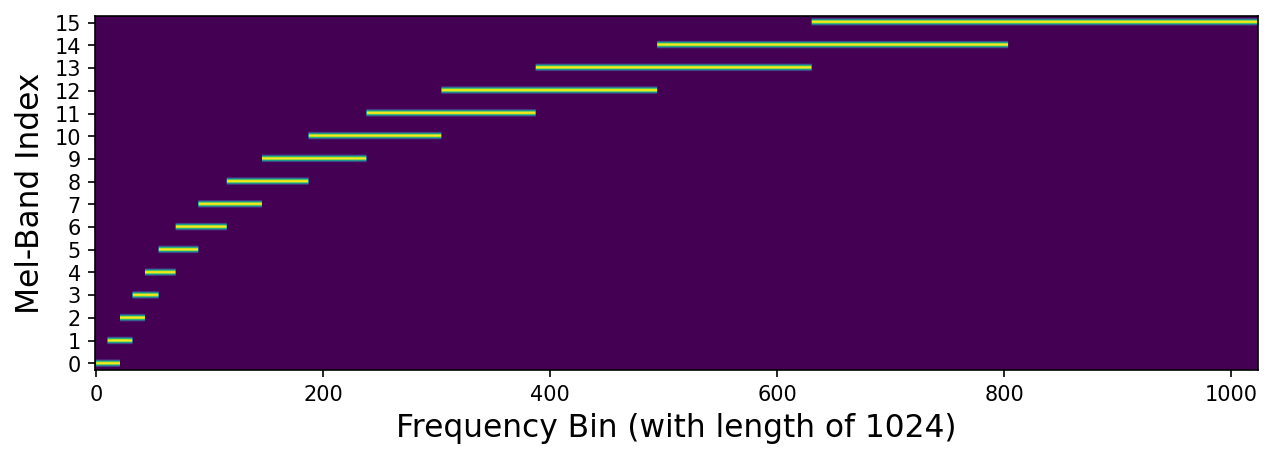
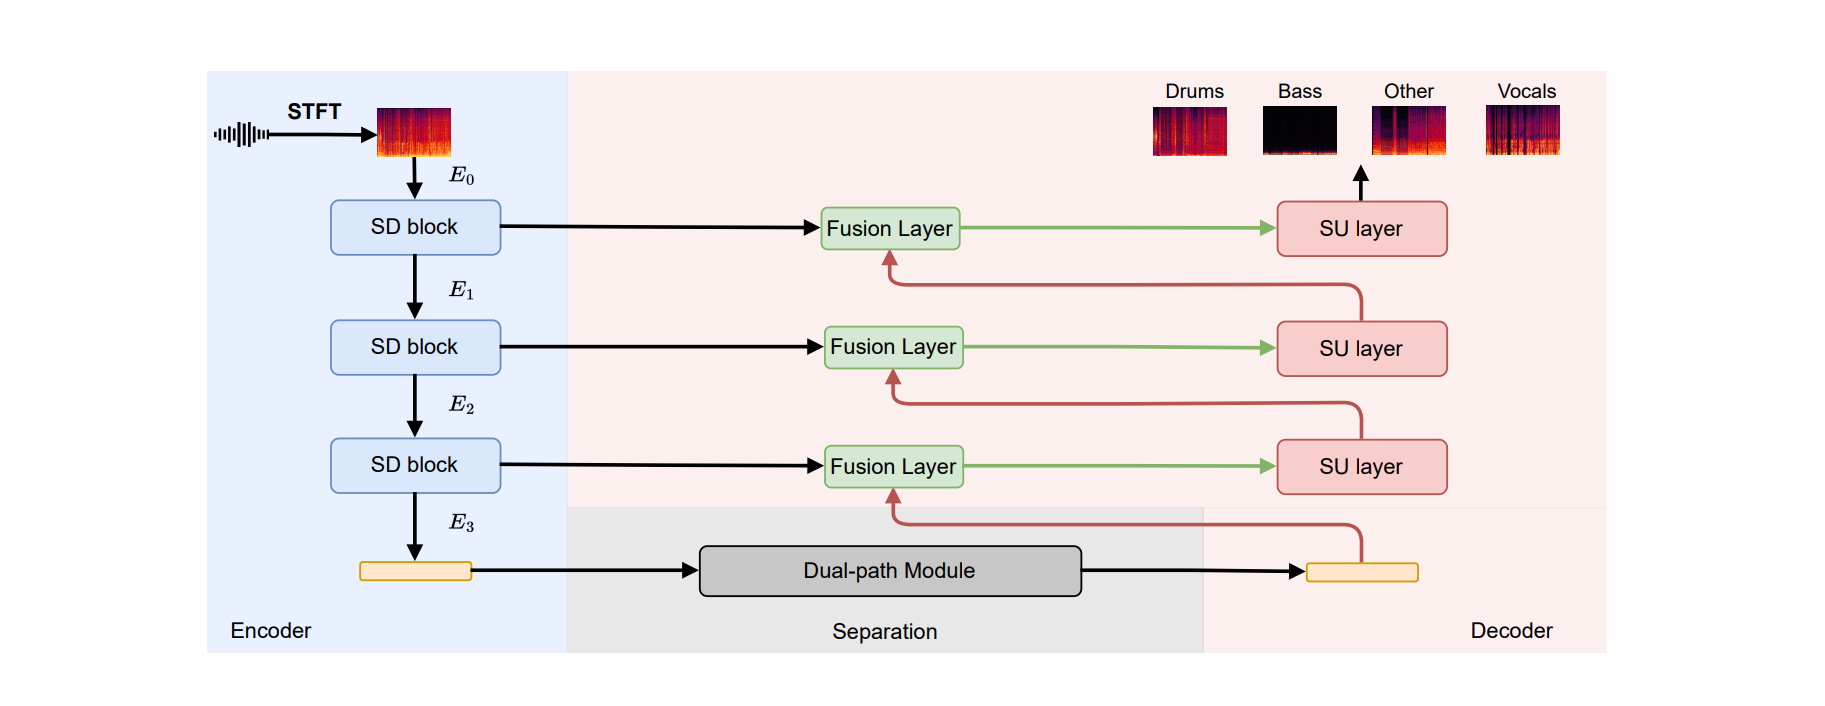
HTDemucs El diagrama de estructura oficial del artículo: las dos ramas del dominio de forma de onda y el dominio del espectro convergen dentro del modelo. El diseño representativo de la etapa de "dominio dual" en la siguiente línea de tiempo se ve así (fuente: artículo de Hybrid Transformers, arXiv:2211.08553).Diagrama oficial de Mel-Band RoFormer Paper: cómo se asignan los contenedores espectrales a subbandas superpuestas organizadas en una escala mel. Las subbandas obtenidas en la frecuencia media-baja son más densas, por lo que los detalles vocales se expresan con mayor detalle (fuente: arXiv:2310.01809).Diagrama de arquitectura oficial en papel de SCNet: la posición del módulo de compresión dispersa entre el codificador y la red de separación es clara de un vistazo: primero se comprime el área de baja densidad de información y luego se deja la potencia informática a límites de voz abarrotados (fuente: documento de SCNet, arXiv:2401.13276).
Las páginas públicas de algoritmos y las clasificaciones de MVSep son referencias habituales en la separación de fuentes musicales. Documentan resultados y configuraciones; un flujo de trabajo de ensamble no debe interpretarse como un único modelo independiente.
Cuatro pistas no es otra forma de decir «acompañamiento»
La separación estándar en cuatro pistas suele referirse a voz, batería, bajo y otros. La voz contiene el canto; la batería, el conjunto de percusión; el bajo, la parte de bajo; y otros agrupa los instrumentos restantes: guitarra, piano, cuerdas, sintetizadores, metales, efectos y más. La pista de acompañamiento que se oye al silenciar la voz es, en realidad, la suma de batería, bajo y otros.
Este objetivo procede de los principales conjuntos de datos y de la tradición de evaluación de la separación de fuentes musicales. MUSDB18 y MUSDB18-HQ llevan años orientando el entrenamiento y la evaluación de modelos en torno a estas cuatro pistas. Cuando la comunidad habla de 4-stem, normalmente se refiere a este tipo de salida.
La diferencia cambia la elección de herramienta. Si el objetivo es obtener una voz limpia o un instrumental sin voz, un separador vocal de dos pistas resulta más directo. Si se busca practicar batería, analizar el bajo, muestrear, remezclar o limpiar materiales editables, cuatro pistas son más útiles. Otros no es una pista de acompañamiento de menor calidad, sino el conjunto instrumental más difícil del sistema.
Cuatro etapas desde U-Net hasta SCNet
La separación de fuentes musicales intenta recuperar varias fuentes a partir de una única forma de onda mezclada, tanto en el tiempo como en la frecuencia. Los primeros modelos ya producían resultados audibles, pero sus artefactos eran conocidos: filtración de voz, restos de batería, bajo embarrado, agudos difuminados o una fase desgarrada en arreglos densos.
Período
Enfoque representativo
Avance
Problema pendiente
2020-2021
VR Architecture / U-Net
Trató los espectrogramas como imágenes e hizo viable la separación básica de voz y acompañamiento.
Las ventanas de convolución locales tenían dificultades con el contexto musical prolongado y las relaciones de fase.
2022-2023
HTDemucs (Meta AI) / MDX-Net
Combinó el modelado de forma de onda y espectrograma, mejorando la calidad y la estabilidad de la reconstrucción.
Los clímax densos, la reverberación intensa y los transitorios complejos aún podían producir artefactos.
2023-2024
BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance)
Empleó división por bandas, RoPE y un modelado tiempo-frecuencia más potente para voces, armonías, deslizamientos y notas sostenidas.
Una distribución de frecuencias que favorece la voz no es necesariamente la mejor para todos los instrumentos de cuatro pistas.
2024-2026
SCNet / Huge-SCNet (Tsinghua SIGS, Skywork AI, Peng Cheng Lab, CUHK y otras instituciones)
Utilizó modelado por subbandas y compresión dispersa para concentrarse en regiones tiempo-frecuencia ricas en información.
El objetivo sigue siendo la separación estándar en cuatro pistas, no una salida de seis pistas ni un ensamble de plataforma.
Esta evolución explica por qué la selección de modelos no puede reducirse a la calidad vocal. La separación en cuatro pistas también debe conservar los transitorios de batería, las frecuencias fundamentales y los armónicos del bajo, los límites de la voz y los detalles de alta frecuencia presentes en otros.
La cronología también está delimitada por las fuentes: el artículo de SCNet se publicó en enero de 2024, mientras que Huge-SCNet-4stems V1.2 pertenece al contexto posterior de checkpoints públicos. Por eso esta cronología utiliza 2024-2026, en vez de insinuar que SCNet no apareció hasta después de 2025.
Mel-Band RoFormer: fortaleza vocal y límites en cuatro pistas
Mel-Band RoFormer fue propuesto por el equipo Speech, Audio, and Music Intelligence (SAMI) de ByteDance. Los autores del artículo son Ju-Chiang Wang, Wei-Tsung Lu y Minz Won, y la afiliación de la portada figura como SAMI, ByteDance. Algunas páginas de la comunidad resumen esta línea como ByteDance AI Labs, pero la formulación más precisa según la fuente es la de los autores del artículo y SAMI, ByteDance.
El modelo resulta atractivo porque organiza las bandas de frecuencia de una forma más próxima a la audición humana. El oído es más sensible a las frecuencias bajas y medias, donde se encuentran las fundamentales vocales, las consonantes, la respiración y muchas pistas de altura tonal. La proyección mel-band ofrece una representación más fina de este rango y ayuda al modelo a seguir voces principales, coros, deslizamientos, vibrato y colas de reverberación.
La familia RoFormer utiliza codificación posicional rotatoria, o RoPE, tanto en las secuencias temporales como en las de subbandas. Esto hace que las puntuaciones de atención dependan de la posición relativa. Los deslizamientos, las notas sostenidas y las frases repetidas aportan intuiciones estructurales útiles para entender esta propiedad, pero el artículo solo evalúa directamente modelos controlados con RoPE frente a modelos sin RoPE; no informa métricas separadas para deslizamientos o armonías prolongadas.
Ruta de señal definida en el artículo
BS-RoFormer convierte primero la forma de onda de la mezcla en un espectrograma complejo. Su proyección por bandas y su Transformer jerárquico estiman una máscara compleja; esa máscara se aplica al espectro de la mezcla y la STFT inversa reconstruye la forma de onda objetivo. Mel-RoFormer modifica la proyección dentro de fθ: las bandas mel superpuestas sustituyen la división heurística sin solapamiento. No reemplaza toda la ruta de reconstrucción.
X = STFT(x)M̂ = fθ(X)Ŷ = M̂ ⊙ Xŷ = iSTFT(Ŷ)
X: el espectrograma complejo de la mezcla, incluidos los componentes real e imaginario.
fθ: proyección por bandas, Transformers intra-/interbanda y estimación de la máscara.
M̂: la máscara objetivo compleja empleada para recuperar la magnitud y la fase.
ŷ: la forma de onda reconstruida mediante STFT inversa y restringida durante el entrenamiento por pérdidas de forma de onda y espectrales.
Por eso Mel-Band RoFormer es una vía sólida para separar voz y acompañamiento, voz principal y coros, o extraer voces limpias. El problema es que la separación en cuatro pistas no se limita a la voz. También debe separar batería, bajo y otros, y esta última pista suele contener los detalles instrumentales de alta frecuencia más difíciles.
Después de los artículos: cómo RoFormer se convirtió en un ecosistema de herramientas abiertas
BS-RoFormer apareció en septiembre de 2023 con dos tipos de evidencia en un mismo artículo. El sistema L=12 de mayor tamaño, entrenado con MUSDB18HQ y 500 canciones internas, documentó la propuesta de SAMI-ByteDance que obtuvo el primer puesto en SDX23. Los modelos más pequeños, entrenados solo con MUSDB18HQ, aportaron ablaciones controladas para RoPE, la división por bandas y la reconstrucción por solapamiento y promedio. El artículo publicó la arquitectura, las condiciones de entrenamiento y las tablas de resultados. No adjuntó el checkpoint original de SDX23 ni enlazó un repositorio de entrenamiento e inferencia de ByteDance/SAMI.
Mel-Band RoFormer llegó en octubre de 2023. Conservó los Transformers con RoPE, el modelado de secuencias intra-/interbanda, las máscaras complejas y la reconstrucción de forma de onda, pero sustituyó la división manual sin solapamiento por 60 bandas mel superpuestas. El intervalo de un mes es importante: se trató de una revisión pública de la proyección de frecuencias motivada por la limitación señalada en el artículo anterior, no de un segundo paquete de checkpoint oficial publicado junto con el texto.
El código ejecutable se fue acumulando fuera de los artículos. El repositorio de lucidrains convirtió los diagramas y las ecuaciones en clases de modelos PyTorch e invitó abiertamente a otras personas a reproducir el separador. La gestión estéreo, las múltiples pistas de salida y la variante Mel-Band hicieron reutilizable la estructura, pero el código por sí solo no podía reconstruir las canciones internas, el estado del optimizador, la duración del entrenamiento ni los parámetros finales de la competición.
Music-Source-Separation-Training proporcionó después un taller común para esa estructura reutilizable: cargadores de conjuntos de datos, aumento de datos, entrenamiento, validación, reanudación desde checkpoints, inferencia por bloques, solapamiento y ensambles. Su README atribuye a lucidrains la recreación de los modelos RoFormer a partir de los artículos y acepta aportaciones de modelos de la comunidad. Una misma arquitectura podía entrenarse para separar voz e instrumental, cuatro pistas, subpistas de batería u otros objetivos especializados. No existía un único peso canónico de la comunidad.
El modelo vocal de Kimberley Jensen volvió concreto el proceso. El repositorio indica que se entrenó con más datos mediante el código de ZFTurbo, utiliza por defecto un bloque de ocho segundos y expone num_overlap para reducir los artefactos de unión a costa de una inferencia más larga. También reconoce a quienes contribuyeron al conjunto de datos. Estos detalles explican por qué un checkpoint descargable posee un carácter que el nombre de una arquitectura no puede describir por sí solo.
La página actual de MVSep atribuye los primeros pesos públicos de alta calidad a Kimberley Jensen y, a continuación, describe las modificaciones y el entrenamiento continuado de los pesos abiertos. Bas Curtiz, unwa, becruily, gabox y otras ediciones aparecen en la misma página con distintos compromisos de cuerpo, filtración, ruido y SDR. Se trata de una genealogía de pesos ramificada: los modelos comparten Mel-Band RoFormer, pero no sus datos, su objetivo, su historial de ajuste fino ni su sonido final.
Síntesis basada en los dos artículos de RoFormer, la implementación de lucidrains y el marco de entrenamiento de ZFTurbo/MVSep. Las flechas indican dependencia de implementación, no respaldo oficial.
Nombre o artefacto
Qué identifica
Qué procedencia falta por documentar
BS-RoFormer / Mel-Band RoFormer
Diseño de proyección por bandas, RoPE y modelado de secuencias axiales.
Quién entrenó el checkpoint concreto, sus datos, las pistas objetivo y el conjunto de evaluación.
Un archivo de checkpoint descargable
Un conjunto de parámetros que normalmente depende de una config compatible.
Si procede de los autores del artículo, de entrenamiento comunitario o de un ajuste fino posterior.
Un flujo alojado de Mel-Band / BS-RoFormer
El servicio ha seleccionado los pesos, los bloques, el solapamiento y las salidas.
Las puntuaciones del flujo alojado no pueden presentarse como resultados de SDX23 ni del artículo original.
Un mismo nombre de arquitectura puede referirse hoy a un sistema de competición, una ablación de un artículo, un checkpoint vocal, uno de cuatro pistas o un ensamble de plataforma. Un texto preciso debe mostrar tres datos: quién propuso la arquitectura, de dónde proceden los pesos actuales y qué receta de inferencia entrega el resultado. Sin los tres, expresiones como «modelo oficial de ByteDance» o «puntuación de competición de Mel-Band en cuatro pistas» combinan silenciosamente artefactos distintos de momentos diferentes de esta historia.
Comparación controlada: Mel no sustituye a BS en todas las pistas
La evidencia más clara es la comparación controlada del artículo de Mel-Band de 2023, no una mezcla de páginas de MVSep y checkpoints comunitarios sin relación. Todas las filas siguientes utilizan MUSDB18HQ sin canciones adicionales. Dentro de cada profundidad, el principal cambio es la proyección: las bandas heurísticas y no superpuestas de BS-RoFormer se sustituyen por 60 bandas mel superpuestas.
El resultado es un compromiso, no una victoria absoluta. En L=6, la voz sube de 10.78 a 11.21 dB y la batería de 9.61 a 9.91 dB, mientras que el bajo baja de 11.43 a 9.64 dB y otros desciende ligeramente de 7.86 a 7.81 dB. En L=9, la voz gana 0.58 dB y otros gana 0.13 dB, la batería pierde 0.32 dB y el bajo no se publica porque el entrenamiento avanzó con demasiada lentitud.
Modelo del artículo (MUSDB18HQ, sin datos adicionales)
Voz
Bajo
Batería
Otros
SDR medio
Parámetros
BS-RoFormer L=6
10.78
11.43
9.61
7.86
9.92
72.2M
Mel-RoFormer L=6
11.21
9.64
9.91
7.81
9.64
84.2M
BS-RoFormer L=9
11.02
11.58
9.66
7.80
10.02
82.8M
Mel-RoFormer L=9
11.60
no publicado
9.34
7.93
no publicado
94.8M
El artículo vincula el resultado del bajo con el mapeo de frecuencias. BS-RoFormer asigna deliberadamente bandas finas a las frecuencias bajas, mientras que la proyección mel resulta más útil para la voz y algunos objetivos distintos del bajo. La conclusión de ingeniería útil es, por tanto, específica para cada tarea: la proyección mel es una opción vocal sólida, pero la motivación psicoacústica por sí sola no demuestra superioridad en cuatro pistas.
SCNet y el objetivo de cuatro pistas
SCNet adopta una visión del espectro más orientada a la información. Entre los autores del artículo figuran Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu y Helen Meng; la portada enumera entre las afiliaciones a Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab y The Chinese University of Hong Kong. En cuanto a la arquitectura, SCNet divide explícitamente el espectrograma de la mezcla en subbandas y utiliza compresión dispersa para gestionar las distintas densidades de información de esas bandas. En términos más sencillos, no concentra casi toda la capacidad en el rango vocal. Obliga al modelo a centrarse en las regiones tiempo-frecuencia que realmente contienen una señal instrumental útil.
Esto importa en cuatro pistas. El bajo se sitúa en frecuencias graves, pero contiene armónicos importantes. La batería combina transitorios muy breves con platillos y sonido de sala. Otros puede contener al mismo tiempo guitarra, piano, cuerdas, sintetizadores y efectos. El modelado por subbandas permite tratar de forma más específica las distintas regiones de frecuencia, mientras que la compresión dispersa evita dedicar atención a regiones vacías o con poca información.
El artículo de SCNet describe el sistema completo como un codificador de audio, una red de separación basada en RNN de doble ruta y un decodificador de audio. El codificador representa la mezcla mediante subbandas en el dominio de la frecuencia, la red de separación modela la estructura en el tiempo y la frecuencia, y el decodificador reconstruye las pistas objetivo.
Huge-SCNet-4stems V1.2 pertenece a esta línea. Su contrato de salida es un conjunto equilibrado de archivos de voz, batería, bajo y otros que pueden seguir utilizándose para remezcla o transcripción, en lugar de un objetivo optimizado solo para la voz.
También es importante separar el artículo de SCNet del checkpoint Huge-SCNet-4stems V1.2. El artículo presenta la arquitectura de compresión dispersa, el diseño por subbandas y el resultado de investigación en MUSDB18-HQ; el artefacto descargable es el checkpoint público de Hugging Face huge_scnet_4stems_v1.2.ckpt. Ese checkpoint comunitario no puede heredar el resultado de 9.0 dB en MUSDB18-HQ del artículo, porque los datos y la procedencia de la publicación son distintos.
El límite del código también debe mantenerse separado. Los autores del artículo publican thuhcsi/SCNet como repositorio oficial de implementación, pero el repositorio indica que el código de entrenamiento aún está por completar y remite a HTDemucs, Music-Source-Separation-Training y SCNet-PyTorch como marcos de entrenamiento provisionales. Por tanto, Huge-SCNet-4stems V1.2 debe describirse como una elección pública de checkpoint de cuatro pistas dentro de la línea SCNet, no como el paquete de modelo oficial del artículo de SCNet.
MVSep Ensemble como flujo de trabajo de plataforma
MVSep Ensemble 2025.06.30 representa un flujo multimodelo a escala de plataforma. La página pública del algoritmo enumera más de una familia de modelos. La ruta vocal puede utilizar UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL y otros enfoques, mientras que bajo, batería y otros pueden recurrir a distintos modelos Demucs o relacionados.
La fortaleza de este tipo de ensamble procede de la especialización: asignar el material con predominio vocal a especialistas en voz, el material rico en bajas frecuencias y transitorios a separadores instrumentales más potentes y, después, fusionar los resultados. Puede servir como referencia del techo de calidad, pero no es un único checkpoint ni un modelo independiente que una persona pueda reproducir descargando un solo archivo.
MVSep atribuye al ensamble 2025.06.30 un SDR medio de 13.67. Ese dato es útil como techo de una plataforma alojada, pero no debe colocarse en la misma fila que un checkpoint independiente. Refleja un flujo de servidor que puede combinar rutas de voz, instrumental, bajo, batería, otros e instrumentos adicionales antes de producir el resultado final.
Por ese motivo, cualquier análisis de un modelo único descargable de cuatro pistas debe mantener los ensambles de plataforma fuera de la categoría de modelo único. De lo contrario, la comparación deja de ser entre arquitecturas y pasa a ser entre flujos alojados.
Comparación pública de modelos de cuatro pistas
La tabla siguiente utiliza cifras de las páginas públicas de modelos y benchmarks citadas. Las puntuaciones ayudan a situar cada modelo bajo el mismo objetivo de cuatro pistas. No deben interpretarse como un veredicto absoluto para todas las canciones, géneros o situaciones de escucha.
El alcance de las fuentes se ha restringido deliberadamente: la fila de Huge-SCNet-4stems V1.2 con 10.02 dB procede de la referencia pública de HF / MVSep; SCNet XL IHF, BS Roformer y HTDemucs4 utilizan filas públicas de ZFTurbo / MVSep Multisong. No es una tabla que mezcle resultados de MUSDB18-HQ del artículo de SCNet, páginas vocales de Mel-Band y puntuaciones de flujos alojados de MVSep Ensemble.
Modelo
SDR medio
Voz
Batería
Bajo
Otros
Cómo interpretarlo
Huge-SCNet-4stems V1.2
10.02
9.6073
11.7422
12.0639
6.6485
Checkpoint público de Huge-SCNet para cuatro pistas en la tabla de referencia citada.
SCNet XL IHF 4-stem
9.92
9.68
11.58
11.94
6.48
Candidato independiente sólido de cuatro pistas, especialmente para batería y bajo.
BS Roformer 4-stem
9.38
9.19
11.29
11.08
5.96
Referencia útil de cuatro pistas para la línea RoFormer con división por bandas.
HTDemucs4
9.16
8.24
10.88
11.76
5.74
Referencia clásica y madura, pero ya no es el techo de calidad actual en cuatro pistas.
Cómo interpretar las puntuaciones
Un SDR más alto suele indicar menos distorsión respecto a la pista de referencia. Sin embargo, el SDR medio no sustituye la escucha ni puede reducir todas las pistas a una sola respuesta. Un modelo puede destacar en bajo y batería, mientras otro conserva una voz más limpia. Otros resulta especialmente difícil porque contiene numerosos instrumentos.
El valor de Huge-SCNet-4stems V1.2 reside en su clara delimitación como artefacto: un nombre de checkpoint público, una salida estándar de cuatro pistas y cifras públicas de referencia trazables. SCNet XL IHF sigue siendo una comparación importante. MVSep Ensemble continúa siendo una referencia alojada del techo de calidad. Responden a preguntas diferentes.
El punto de partida debe ser el objetivo. La separación vocal sirve para obtener la voz más limpia. La separación en cuatro pistas entrega voz, batería, bajo y otros editables. La separación en seis pistas es adecuada cuando guitarra y piano necesitan sus propios archivos.
Límite de salida: equilibrio de cuatro pistas frente al detalle de seis
La separación en seis pistas descompone aún más la categoría otros en guitarra, piano y el resto. Es más sensible a los rasgueos de guitarra, los ataques de piano, la textura de teclado y los armónicos de alta frecuencia. Por tanto, un checkpoint BS Roformer SW de seis pistas representa un objetivo y un contrato de entrenamiento distintos de Huge-SCNet-4stems V1.2.
Estas afirmaciones pertenecen a capas separadas: RoFormer describe una familia de arquitecturas, Mel-Band se orienta a la representación vocal, SCNet equilibra cuatro pistas y los ensambles de MVSep combinan componentes alojados. Cada uno responde a una pregunta distinta sobre arquitectura, objetivo de salida, disponibilidad pública, forma del flujo de trabajo o contrato de inferencia.
Conclusión: elegir la arquitectura, no la palabra de moda
La separación en cuatro pistas no es una pista de acompañamiento con otro nombre ni un lugar donde aplicar el modelo vocal más popular a todos los instrumentos. Exige que el modelo equilibre voz, batería, bajo y otros, en especial los transitorios de batería, los graves del bajo, los armónicos instrumentales agudos y el conjunto de instrumentos mezclados dentro de otros.
Huge-SCNet-4stems V1.2 ocupa una posición clara en torno a ese objetivo estándar de cuatro pistas. Mel-Band RoFormer sigue siendo importante para entender la separación vocal, mientras que MVSep Ensemble conserva su utilidad como referencia de calidad alojada. Cada uno pertenece a una capa distinta de la historia de la investigación y el despliegue.