모델
4스템 오디오 분리 백서: Huge-SCNet이 표준 MSS 목표에 맞는 이유
TelkNet의 현재 4스템 도구는 Huge-SCNet-4stems V1.2로 전체 믹스를 vocals, drums, bass, other로 나눕니다. 이 글은 MSS 아키텍처 흐름, Mel-Band RoFormer의 강점과 한계, SCNet의 서브밴드 모델링, 공개 4스템 점수를 통해 선택 이유를 설명합니다.

TelkNet의 현재 4스템 도구는 Huge-SCNet-4stems V1.2로 전체 믹스를 vocals, drums, bass, other로 나눕니다. 이 글은 MSS 아키텍처 흐름, Mel-Band RoFormer의 강점과 한계, SCNet의 서브밴드 모델링, 공개 4스템 점수를 통해 선택 이유를 설명합니다.
모델 소식 / 음악 소스 분리
AI 음악 소스 분리는 이제 믹스에서 보컬을 떼어낼 수 있는지만 묻는 단순한 단계를 넘어섰다. 리믹스, 샘플링, 연습, Music-to-MIDI, 공간 음향, 소재 정리에서는 결과물을 계속 편집할 수 있는지가 더 유용한 질문이다. 표준 4개 스템 분리는 이보다 엄격한 목표를 따른다. 보컬과 반주 파일만 만드는 대신 전체 믹스를 vocals, drums, bass, other로 나눈다.
MVSep Ensemble, SCNet XL IHF, Mel-Band RoFormer, BS-RoFormer, Huge-SCNet-4stems V1.2는 서로 다른 4개 스템 접근법을 대표한다. 보컬 성능만으로 4개 스템 품질이 결정되지는 않는다. 플랫폼 ensemble은 다운로드 가능한 단일 모델이 아니어도 높은 점수를 낼 수 있지만, 공개 checkpoint는 재현 가능한 산출물을 제공한다.
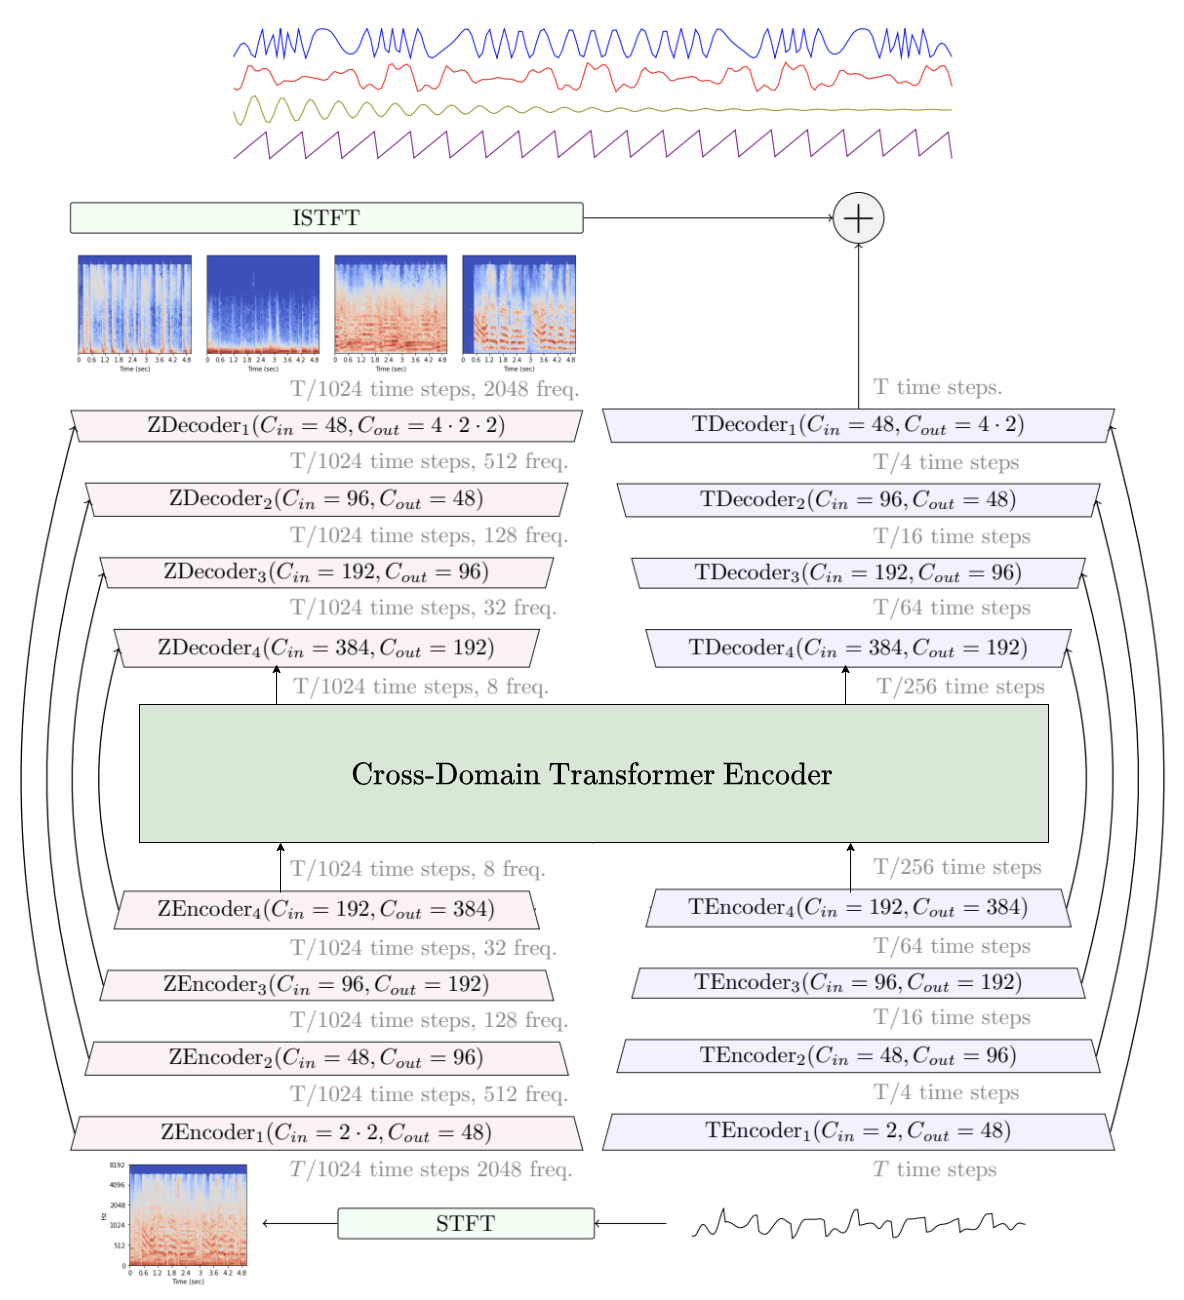
표준 4개 스템 분리는 보통 vocals, drums, bass, other를 뜻한다. Vocals는 노래 트랙, drums는 드럼 세트, bass는 베이스 파트이며, other에는 기타, 피아노, 현악기, 신시사이저, 관악기, 이펙트 등 나머지 악기가 들어간다. 보컬을 음소거했을 때 들리는 반주는 실제로 drums, bass, other를 합친 것이다.
이 목표는 음악 소스 분리의 주요 dataset과 평가 전통에서 비롯됐다. MUSDB18과 MUSDB18-HQ는 오랫동안 이 네 스템을 중심으로 모델 학습과 평가를 형성해 왔다. 커뮤니티에서 4-stem이라고 하면 일반적으로 이 출력 목표를 뜻한다.
이 차이는 도구 선택을 바꾼다. 깨끗한 보컬이나 보컬 없는 instrumental이 목적이라면 2개 스템 보컬 분리기가 더 직접적이다. 드럼 연습, 베이스 분석, 샘플링, 리믹스 또는 편집 가능한 소재 정리가 목적이라면 4개 스템이 더 유용하다. Other는 품질이 낮은 반주가 아니라 시스템에서 가장 어려운 악기 묶음이다.
음악 소스 분리는 하나의 혼합 파형에서 시간과 주파수에 걸쳐 여러 소스를 복원하려는 작업이다. 초기 모델도 들을 만한 결과를 만들 수 있었지만, 보컬 누출, 드럼 혼입, 뭉개진 베이스, 흐려진 고주파, 밀도 높은 편곡에서 위상이 찢어진 듯한 음질 같은 artifact가 익숙하게 나타났다.
| 시기 | 대표 경로 | 진전 | 남은 문제 |
|---|---|---|---|
| 2020-2021 | VR Architecture / U-Net | spectrogram을 이미지처럼 다뤄 기본적인 보컬/반주 분리를 실용화했다. | 국소 convolution window는 긴 음악 context와 위상 관계를 처리하는 데 한계가 있었다. |
| 2022-2023 | HTDemucs (Meta AI) / MDX-Net | 파형과 spectrogram 모델링을 결합해 복원 품질과 안정성을 높였다. | 밀도 높은 절정, 강한 reverb, 복잡한 transient에서는 여전히 artifact가 생길 수 있었다. |
| 2023-2024 | BS-RoFormer / Mel-Band RoFormer (SAMI, ByteDance) | band split, RoPE, 강화된 시간-주파수 모델링을 사용해 보컬, 화음, slide, sustain을 처리했다. | 보컬에 유리한 주파수 배분이 모든 4개 스템 악기에 자동으로 최선인 것은 아니다. |
| 2024-2026 | SCNet / Huge-SCNet (Tsinghua SIGS, Skywork AI, Peng Cheng Lab, CUHK 외) | subband 모델링과 sparse compression을 사용해 정보가 풍부한 시간-주파수 영역에 집중했다. | 목표는 여전히 표준 4개 스템 분리이며, 6개 스템 출력이나 플랫폼 ensemble이 아니다. |
이 역사는 모델 선택을 보컬 품질 하나로 축소할 수 없는 이유를 보여준다. 4개 스템 분리는 드럼 transient, 베이스 기본음과 배음, 보컬 경계, other 안의 고주파 세부까지 보존해야 한다.
시점 역시 출처 범위에 맞춰야 한다. SCNet 논문은 2024년 1월에 공개됐고, Huge-SCNet-4stems V1.2는 그보다 뒤의 공개 checkpoint 맥락에 속한다. 그래서 이 연표는 SCNet 자체가 2025년 이후에야 등장했다는 인상을 주지 않도록 2024-2026을 사용한다.
Mel-Band RoFormer는 ByteDance의 Speech, Audio, and Music Intelligence (SAMI) 팀이 제안했다. 논문 저자는 Ju-Chiang Wang, Wei-Tsung Lu, Minz Won이며, 표제 페이지의 소속은 SAMI, ByteDance로 기재돼 있다. 커뮤니티 페이지에서는 이 계보를 ByteDance AI Labs라고 요약하기도 하지만, 가장 정확한 출처 표현은 논문 저자와 SAMI, ByteDance다.
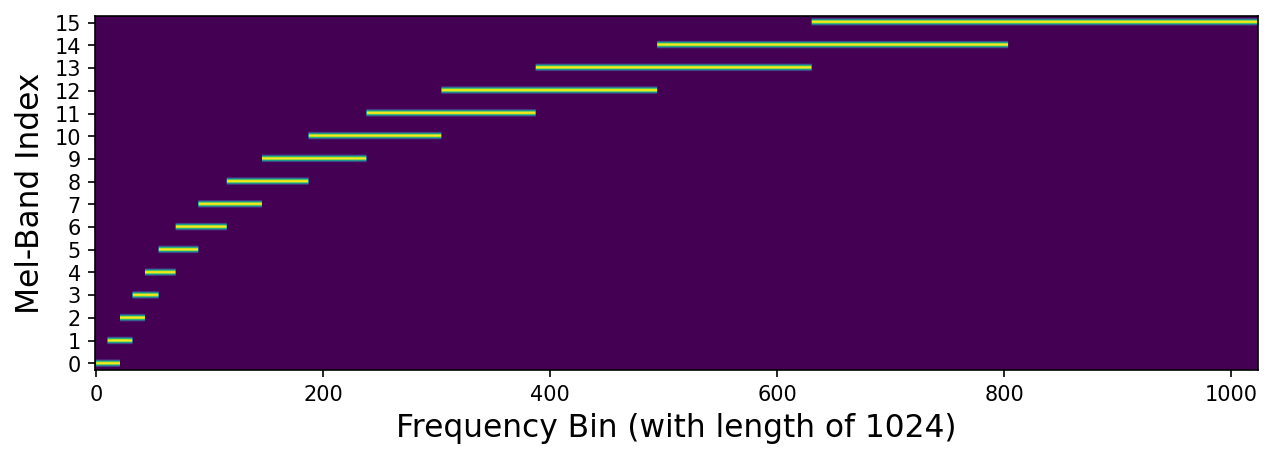
이 모델이 매력적인 이유는 사람의 청각에 더 가까운 형태로 주파수 band를 구성하기 때문이다. 귀는 보컬 기본음, 자음, 숨소리, 여러 pitch 단서가 있는 저·중주파에 더 민감하다. Mel-band projection은 이 영역을 더 세밀하게 표현해 모델이 lead, backing vocal, slide, vibrato, reverb tail을 따라가는 데 도움을 준다.
RoFormer 계열은 시간 sequence와 subband sequence 양쪽에 rotary position encoding, 즉 RoPE를 사용한다. 따라서 attention score가 상대 위치에 따라 달라진다. Slide, sustain, 반복 구절은 이 성질을 이해하는 데 유용한 구조적 직관이지만, 논문이 직접 검증한 것은 통제된 RoPE 적용 모델과 미적용 모델의 비교뿐이다. slide나 긴 harmony에 대한 별도 지표는 보고하지 않았다.
BS-RoFormer는 먼저 혼합 파형을 complex spectrogram으로 변환한다. band projection과 계층형 Transformer가 complex mask를 추정하고, 이 mask를 혼합 spectrum에 적용한 뒤 inverse STFT로 목표 파형을 복원한다. Mel-RoFormer는 fθ 내부의 projection을 바꾼다. 겹치는 mel band가 경험적으로 나눈 비중첩 split을 대체한다. 전체 복원 경로를 교체하는 것은 아니다.
그래서 Mel-Band RoFormer는 보컬/반주, lead/backing vocal, 깨끗한 보컬 추출에 강한 경로다. 문제는 4개 스템 분리가 보컬만의 문제가 아니라는 점이다. drums, bass, other도 분리해야 하며, other에는 가장 어려운 고주파 악기 세부가 들어 있는 경우가 많다.
BS-RoFormer는 2023년 9월 한 논문에서 두 종류의 근거와 함께 등장했다. MUSDB18HQ와 사내 곡 500개로 학습한 더 큰 L=12 시스템은 SAMI-ByteDance가 SDX23에서 1위를 차지한 출품작을 기록했다. 더 작은 MUSDB18HQ 전용 모델은 RoPE, band split, overlap-and-average 복원을 위한 통제 ablation을 제공했다. 논문은 아키텍처, 학습 조건, 결과표를 공개했지만 원본 SDX23 checkpoint를 첨부하거나 ByteDance/SAMI의 학습 및 inference repository를 연결하지는 않았다.
Mel-Band RoFormer는 2023년 10월 뒤따랐다. RoPE Transformer, band 내부/간 sequence 모델링, complex mask, 파형 복원은 유지했지만, 사람이 설계한 비중첩 split을 겹치는 mel band 60개로 대체했다. 한 달의 간격은 의미가 있다. 이는 앞선 논문 자체의 한계에서 비롯된 주파수 projection의 공개 개정판이지, 본문과 함께 공개된 두 번째 공식 checkpoint package가 아니었다.
실행 가능한 코드는 논문 바깥에서 축적됐다. lucidrains repository는 도식과 수식을 PyTorch model class로 옮기고 다른 이들이 분리기를 재현하도록 공개적으로 권했다. Stereo 처리, 여러 출력 stem, Mel-Band variant 덕분에 구조를 재사용할 수 있게 됐지만, 코드만으로는 사내 곡, optimizer state, 학습 기간, 최종 대회 parameter를 복원할 수 없었다.
이어 Music-Source-Separation-Training은 재사용 가능한 이 구조에 공동 작업장을 제공했다. dataset loader, augmentation, 학습, validation, checkpoint resume, chunk inference, overlap, ensembling을 묶었다. README는 논문을 바탕으로 RoFormer 모델을 재구현한 lucidrains를 명시하고 커뮤니티 모델 제출을 받는다. 하나의 아키텍처를 보컬/instrumental 분리, 4개 스템, 드럼 하위 스템 또는 다른 전문 목표에 맞춰 학습할 수 있게 된 것이다. 단 하나의 정본 커뮤니티 weight는 존재하지 않았다.
Kimberley Jensen의 보컬 모델은 이 과정을 구체적으로 보여준다. repository에 따르면 ZFTurbo의 코드로 더 많은 데이터를 학습했고, 기본적으로 8초 chunk를 사용하며, inference가 길어지는 대신 stitching artifact를 줄이는 num_overlap을 제공한다. dataset 기여자도 명시한다. 이런 세부 정보는 다운로드 가능한 checkpoint가 아키텍처 이름만으로는 설명할 수 없는 고유한 성격을 갖는 이유를 보여준다.
현재 MVSep 페이지는 최초의 고품질 공개 weight를 Kimberley Jensen에게 돌리고, 이후 공개 weight를 수정하고 계속 학습한 과정을 설명한다. Bas Curtiz, unwa, becruily, gabox와 그 밖의 edition이 서로 다른 fullness, bleed, noise, SDR 절충점과 함께 같은 페이지에 나온다. 이는 분기된 weight 계보이다. 모델들은 Mel-Band RoFormer를 공유하지만 데이터, 목표, fine-tuning 이력, 최종 음색은 공유하지 않는다.
| 이름 또는 산출물 | 식별하는 대상 | 출처 확인이 더 필요한 항목 |
|---|---|---|
| BS-RoFormer / Mel-Band RoFormer | band projection, RoPE, 축 방향 sequence 모델링 설계. | 구체적인 checkpoint 학습자, 데이터, 목표 stem, 평가 set. |
| 다운로드 가능한 checkpoint 파일 | 일반적으로 일치하는 config에 의존하는 하나의 parameter set. | 논문 저자, 커뮤니티 학습, 이후 fine-tuning 가운데 어디에서 나왔는지. |
| 호스팅된 Mel-Band / BS-RoFormer workflow | 서비스가 weight, chunking, overlap, 출력을 선택했다는 점. | 호스팅 workflow 점수를 SDX23 또는 원 논문 결과로 이름을 바꿔 붙일 수 없다. |
이제 하나의 아키텍처 이름이 대회 시스템, 논문의 ablation, 보컬 checkpoint, 4개 스템 checkpoint 또는 플랫폼 ensemble을 가리킬 수 있다. 정확한 설명은 세 가지를 드러내야 한다. 누가 아키텍처를 제안했는지, 현재 weight가 어디에서 왔는지, 어떤 inference recipe가 결과를 내는지다. 이 세 가지가 모두 없으면 “공식 ByteDance 모델”이나 “Mel-Band 4개 스템 대회 점수” 같은 표현은 이 역사에서 서로 다른 시점의 산출물을 조용히 이어 붙이게 된다.
가장 명확한 근거는 MVSep 페이지와 무관한 커뮤니티 checkpoint를 섞은 자료가 아니라 2023년 Mel-Band 논문의 통제 비교다. 아래 모든 행은 추가 곡 없이 MUSDB18HQ를 사용한다. 각 depth 안에서 주된 변화는 projection이다. BS-RoFormer의 경험적 비중첩 band를 겹치는 mel band 60개로 바꿨다.
결과는 전면 우세가 아니라 절충이다. L=6에서 vocals는 10.78에서 11.21 dB로, drums는 9.61에서 9.91 dB로 올랐지만, bass는 11.43에서 9.64 dB로 떨어졌고 other는 7.86에서 7.81 dB로 소폭 하락했다. L=9에서는 vocals가 0.58 dB, other가 0.13 dB 올랐고, drums는 0.32 dB 하락했다. bass는 학습 진행이 너무 느려 보고되지 않았다.
| 논문 모델 (MUSDB18HQ, 추가 데이터 없음) | Vocals | Bass | Drums | Other | 평균 SDR | Parameter |
|---|---|---|---|---|---|---|
| BS-RoFormer L=6 | 10.78 | 11.43 | 9.61 | 7.86 | 9.92 | 72.2M |
| Mel-RoFormer L=6 | 11.21 | 9.64 | 9.91 | 7.81 | 9.64 | 84.2M |
| BS-RoFormer L=9 | 11.02 | 11.58 | 9.66 | 7.80 | 10.02 | 82.8M |
| Mel-RoFormer L=9 | 11.60 | 보고되지 않음 | 9.34 | 7.93 | 보고되지 않음 | 94.8M |
논문은 bass 결과를 주파수 mapping과 연결한다. BS-RoFormer는 저주파에 의도적으로 세밀한 band를 배분하지만, mel projection은 vocals와 일부 비-bass 목표에 더 유리하다. 따라서 유용한 엔지니어링 결론은 task별로 달라진다. mel projection은 강력한 보컬 선택이지만, psychoacoustic 근거만으로 4개 스템 전체의 우세가 입증되지는 않는다.
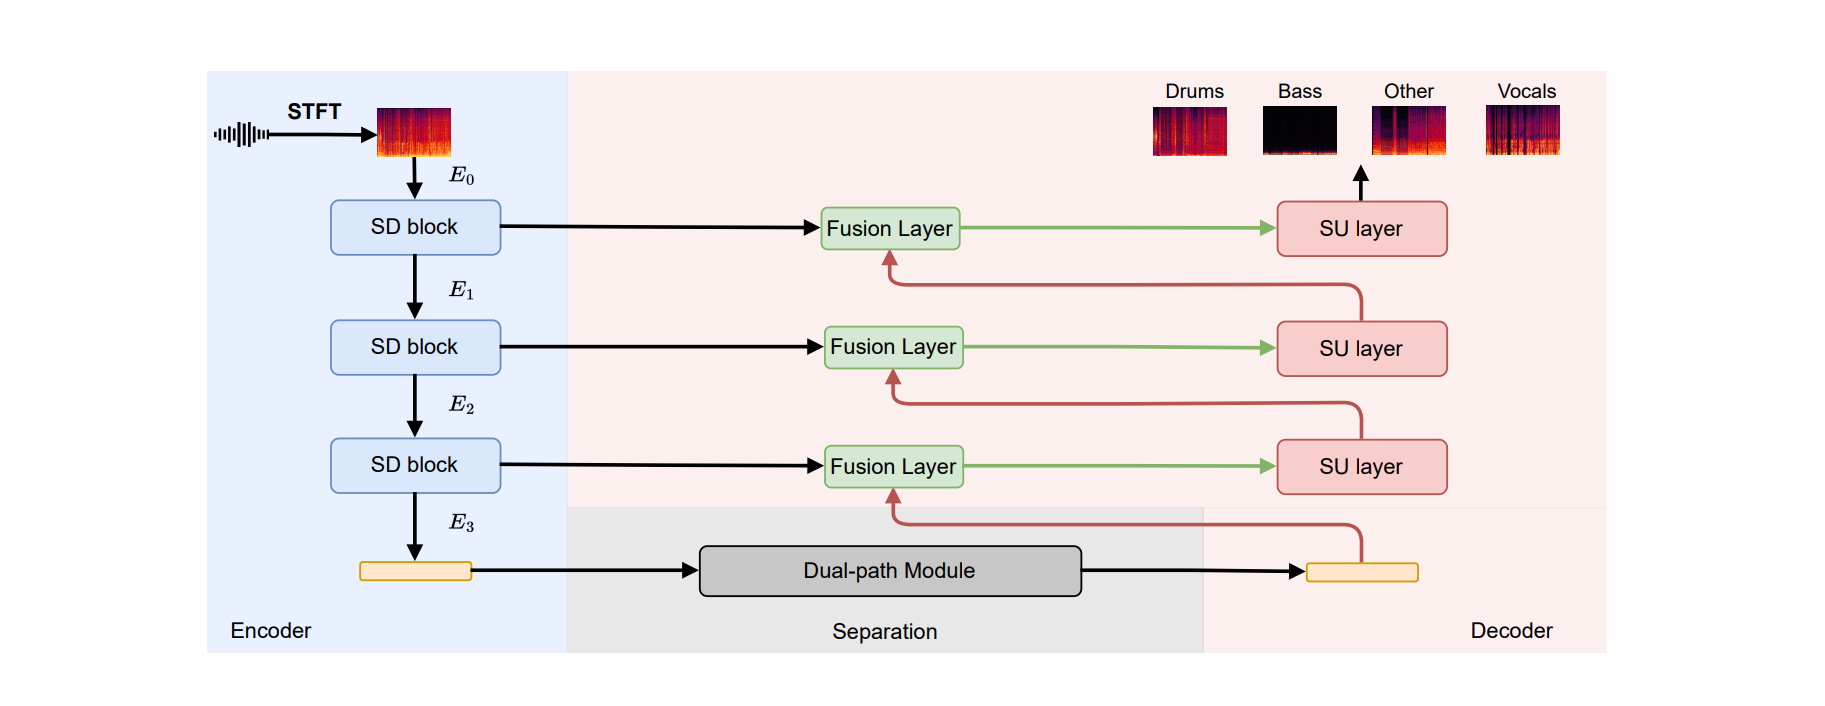
SCNet은 spectrum을 정보 중심의 관점에서 바라본다. 논문 저자는 Weinan Tong, Jiaxu Zhu, Jun Chen, Shiyin Kang, Tao Jiang, Yang Li, Zhiyong Wu, Helen Meng이며, 표제 페이지에는 Shenzhen International Graduate School, Tsinghua University, Skywork AI PTE. LTD., Peng Cheng Lab, The Chinese University of Hong Kong 등이 소속으로 기재돼 있다. 아키텍처 측면에서 SCNet은 혼합 spectrogram을 subband로 명시적으로 나누고 sparse compression을 사용해 band마다 다른 정보 밀도를 처리한다. 간단히 말해 거의 모든 용량을 보컬 영역에 집중하지 않는다. 모델이 실제로 유용한 악기 신호를 담은 시간-주파수 영역에 집중하도록 한다.
이는 4개 스템에서 중요하다. Bass는 저주파에 있지만 중요한 배음을 품는다. Drums는 매우 짧은 transient와 cymbal, room sound를 함께 가진다. Other에는 guitar, piano, strings, synths, effects가 동시에 들어갈 수 있다. subband 모델링은 주파수 영역별로 더 맞춤화된 처리를 제공하고, sparse compression은 비어 있거나 정보가 적은 영역에 attention이 낭비되지 않도록 한다.
SCNet 논문은 전체 시스템을 audio encoder, dual-path RNN 기반 separation network, audio decoder로 설명한다. encoder는 혼합물을 주파수 영역의 subband 표현으로 mapping하고, separation network는 시간과 주파수에 걸친 구조를 모델링하며, decoder는 목표 stem을 복원한다.
Huge-SCNet-4stems V1.2는 이 경로에 속한다. 출력 계약은 리믹스나 transcription으로 계속 이어갈 수 있는 균형 잡힌 vocals, drums, bass, other 파일이며, 보컬만 최적화하는 목표가 아니다.
SCNet 논문과 Huge-SCNet-4stems V1.2 checkpoint를 구분하는 것도 중요하다. 논문은 sparse-compression 아키텍처, subband 설계, MUSDB18-HQ 연구 결과를 제공하며, 다운로드 가능한 산출물은 공개 Hugging Face checkpoint인 huge_scnet_4stems_v1.2.ckpt다. 데이터와 공개 출처가 다르므로 이 커뮤니티 checkpoint는 논문의 9.0 dB MUSDB18-HQ 결과를 그대로 물려받을 수 없다.
코드의 경계도 따로 유지해야 한다. 논문 저자들은 thuhcsi/SCNet을 공식 구현 repository로 공개했지만, repository에는 학습 코드가 아직 완성되지 않았다고 적혀 있고 임시 학습 framework로 HTDemucs, Music-Source-Separation-Training, SCNet-PyTorch를 안내한다. 따라서 Huge-SCNet-4stems V1.2는 SCNet 논문의 공식 모델 package가 아니라 SCNet 경로에서 선택한 공개 4개 스템 checkpoint로 설명해야 한다.
MVSep Ensemble 2025.06.30은 플랫폼 수준의 다중 모델 workflow를 나타낸다. 공개 알고리즘 페이지에는 둘 이상의 모델 계열이 나열돼 있다. 보컬 경로는 UVR-MDX-NET, Demucs, MDX23C, VitLarge23, BS Roformer, Mel Roformer, SCNet XL과 다른 경로를 사용할 수 있고, bass, drums, other는 서로 다른 Demucs 또는 관련 모델을 호출할 수 있다.
이런 ensemble의 강점은 전문화에서 나온다. 보컬 비중이 큰 소재는 보컬 전문 모델에, 저주파와 transient 비중이 큰 소재는 더 강한 악기 분리기에 배정한 뒤 결과를 융합한다. 품질 상한의 기준점이 될 수 있지만 하나의 checkpoint가 아니며, 사용자가 파일 하나를 다운로드해 재현할 수 있는 단일 모델도 아니다.
MVSep는 2025.06.30 ensemble의 평균 SDR을 13.67로 기재한다. 이 수치는 호스팅 플랫폼의 상한으로는 유용하지만 단일 checkpoint와 같은 행에 놓아서는 안 된다. 최종 결과를 만들기 전에 vocal, instrumental, bass, drums, other와 추가 악기별 경로를 조합할 수 있는 서버 측 workflow를 반영하기 때문이다.
따라서 다운로드 가능한 단일 4개 스템 모델을 논할 때 플랫폼 ensemble은 단일 모델 범주 밖에 둬야 한다. 그렇지 않으면 비교 대상이 모델 아키텍처에서 호스팅 workflow로 바뀐다.
아래 표는 인용된 공개 모델 및 benchmark 페이지의 수치를 사용한다. 이 점수는 동일한 4개 스템 목표 아래에서 각 모델의 위치를 파악하는 데 도움을 준다. 모든 곡, 장르 또는 청취 사례에 대한 절대적 판정으로 읽어서는 안 된다.
출처 범위는 의도적으로 좁혔다. Huge-SCNet-4stems V1.2의 10.02 dB 행은 공개 HF / MVSep 참고 자료에서, SCNet XL IHF, BS Roformer, HTDemucs4는 공개 ZFTurbo / MVSep Multisong 행에서 가져왔다. SCNet 논문의 MUSDB18-HQ 결과, Mel-Band 보컬 페이지, MVSep Ensemble의 호스팅 workflow 점수를 뒤섞은 표가 아니다.
| 모델 | 평균 SDR | Vocals | Drums | Bass | Other | 해석 방법 |
|---|---|---|---|---|---|---|
| Huge-SCNet-4stems V1.2 | 10.02 | 9.6073 | 11.7422 | 12.0639 | 6.6485 | 인용된 참고표에 있는 공개 Huge-SCNet 4개 스템 checkpoint. |
| SCNet XL IHF 4-stem | 9.92 | 9.68 | 11.58 | 11.94 | 6.48 | 특히 drums와 bass에서 강한 단일 4개 스템 후보. |
| BS Roformer 4-stem | 9.38 | 9.19 | 11.29 | 11.08 | 5.96 | band-split RoFormer 경로에 유용한 4개 스템 기준점. |
| HTDemucs4 | 9.16 | 8.24 | 10.88 | 11.76 | 5.74 | 성숙한 전통적 baseline이지만 현재 4개 스템 품질의 상한은 아니다. |
SDR이 높을수록 일반적으로 기준 stem 대비 왜곡이 적다는 뜻이다. 하지만 평균 SDR은 청취를 대체할 수 없고, 모든 stem을 하나의 답으로 평탄화할 수도 없다. 한 모델은 bass와 drums에 강한 반면 다른 모델은 vocals를 더 깨끗하게 유지할 수 있다. Other는 여러 악기를 포함하므로 특히 어렵다.
Huge-SCNet-4stems V1.2의 가치는 명확한 산출물 경계에 있다. 하나의 공개 checkpoint 이름, 표준 4개 스템 출력, 추적 가능한 공개 참고 수치를 갖는다. SCNet XL IHF는 여전히 중요한 비교 대상이고 MVSep Ensemble은 여전히 호스팅 품질 상한의 기준점이다. 이들은 서로 다른 질문에 답한다.
사용자는 목표부터 정해야 한다. 가장 깨끗한 vocals가 필요하면 보컬 분리를, 편집 가능한 vocals, drums, bass, other가 필요하면 4개 스템 분리를 사용한다. guitar와 piano를 별도 파일로 받아야 한다면 6개 스템 분리를 사용한다.
6개 스템 분리는 other를 guitar, piano, 나머지 other로 더 나눈다. guitar strum, piano attack, keyboard texture, 고주파 배음에 더 민감하다. 따라서 BS Roformer SW 6개 스템 checkpoint는 Huge-SCNet-4stems V1.2와 다른 목표와 학습 계약을 나타낸다.
이런 주장은 서로 다른 층위에 속한다. RoFormer는 아키텍처 계열을, Mel-Band는 보컬 표현을, SCNet은 4개 스템의 균형을, MVSep ensemble은 호스팅 구성 요소의 조합을 설명한다. 각각 아키텍처, 출력 목표, 공개 가용성, workflow 형태 또는 inference 계약에 관한 서로 다른 질문에 답한다.
4개 스템 분리는 이름만 바꾼 반주가 아니며, 가장 인기 있는 보컬 모델을 모든 악기에 그대로 적용하는 작업도 아니다. 모델은 vocals, drums, bass, other의 균형을 맞춰야 하며, 특히 드럼 transient, 베이스 저역, 악기의 고주파 배음, other 안에 섞인 악기 묶음을 다뤄야 한다.
Huge-SCNet-4stems V1.2는 이 표준 4개 스템 목표를 중심으로 뚜렷한 위치를 차지한다. Mel-Band RoFormer는 보컬 분리를 이해하는 데 여전히 중요하고, MVSep Ensemble은 호스팅 품질 기준으로 여전히 유용하다. 각각 연구와 배포 역사의 서로 다른 층위에 속한다.