Модель
MossFormer2 і TIGER-speech: три розподілу завдань у голосовому інтерфейсі
Голосовий інтерфейс/порівняння технологій
Голосовий інтерфейс/порівняння технологій
ВХІДНИЙ МОДУЛЬ МОВЛЕННЯ
SS 16K оцінює, хто що сказав. SE 48K оцінює чистіший варіант голосу одного спікера. SR 48K відтворює смугу частот. В їхньому навчальному контролі та кількості виходів — різна логіка.
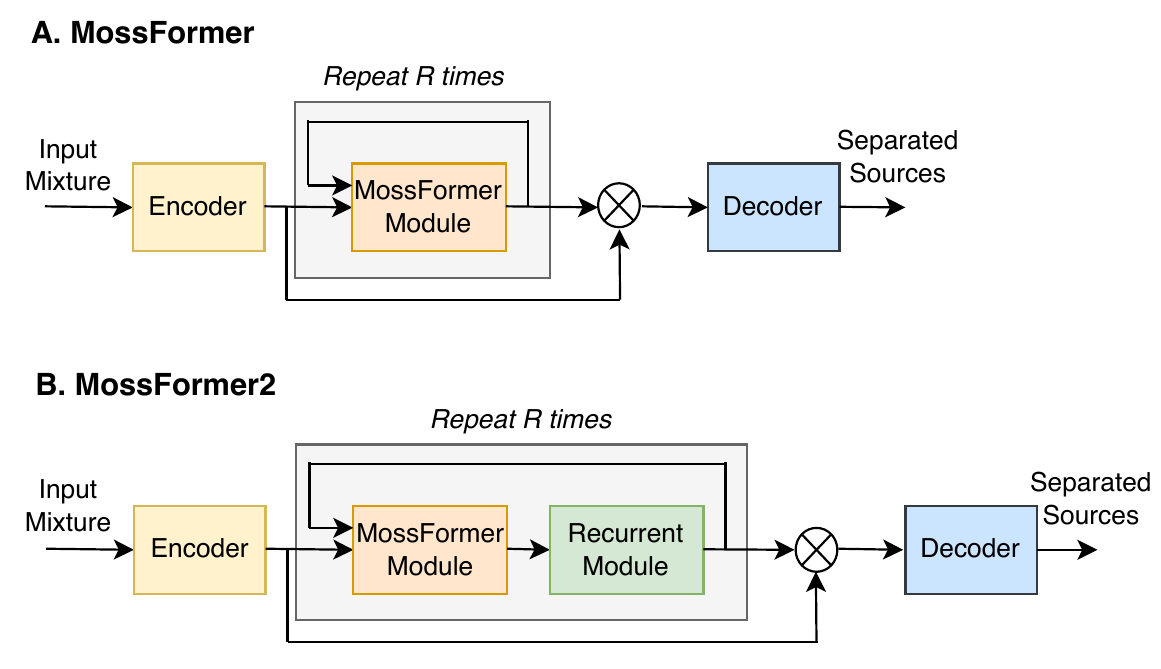
Виходи не мають природного порядку спікерів: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS справляється з накладанням голосів у загальному випадку. TIGER-speech збережено для зашумлених записів двох осіб з луною та реверберацією.
Покращення дає одну очищену форму хвилі; суперроздільна здатність прогнозує втрачену інформацію верхньої смуги й може вигадувати правдоподібні деталі. Оцінювання має вказувати вхідну та вихідну частоти дискретизації, а шкоду від шумозаглушення і вигадану високочастотну текстуру слід слухати окремо.
Мовні вхідні модулі виросли в трьох окремих спільнотах: розділення для нарад цілиться в накладання голосів, покращення — у шум і реверберацію, а суперроздільна здатність — у втрачену смугу частот. ClearerVoice-Studio поєднує MossFormer2 SS 16K, SE 48K і відновлення смуги за одним інженерним входом, проте їхні цілі та контракти виходів лишаються різними.
TIGER-speech застосовує послідовне моделювання з урахуванням смуг, щоб знизити вартість довгого контексту. Це порівняння ефективності, а не заміна MossFormer2 за номером версії. Розгортання починається з відповіді: запис містить накладення спікерів, замасковане мовлення чи втрачену смугу частот; помилково обрана задача дає відшліфовану відповідь на хибне запитання.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kперестановки K спікерівπодне призначення вихід-еталонℓвтрати реконструкції одного сигналуПри розділенні двох спікерів немає природного першого спікера. PIT обирає призначення виходів до еталонів із найменшими втратами, щоб нумерація каналів не створювала суперечливого контролю.
SS 16K розділяє спікерів; SE 48K і SR 48K ремонтують один сигнал. Спільна таблиця лідерів змішала б задачу, смугу частот і набори даних.
Статтю, код і ваги можна простежити через ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
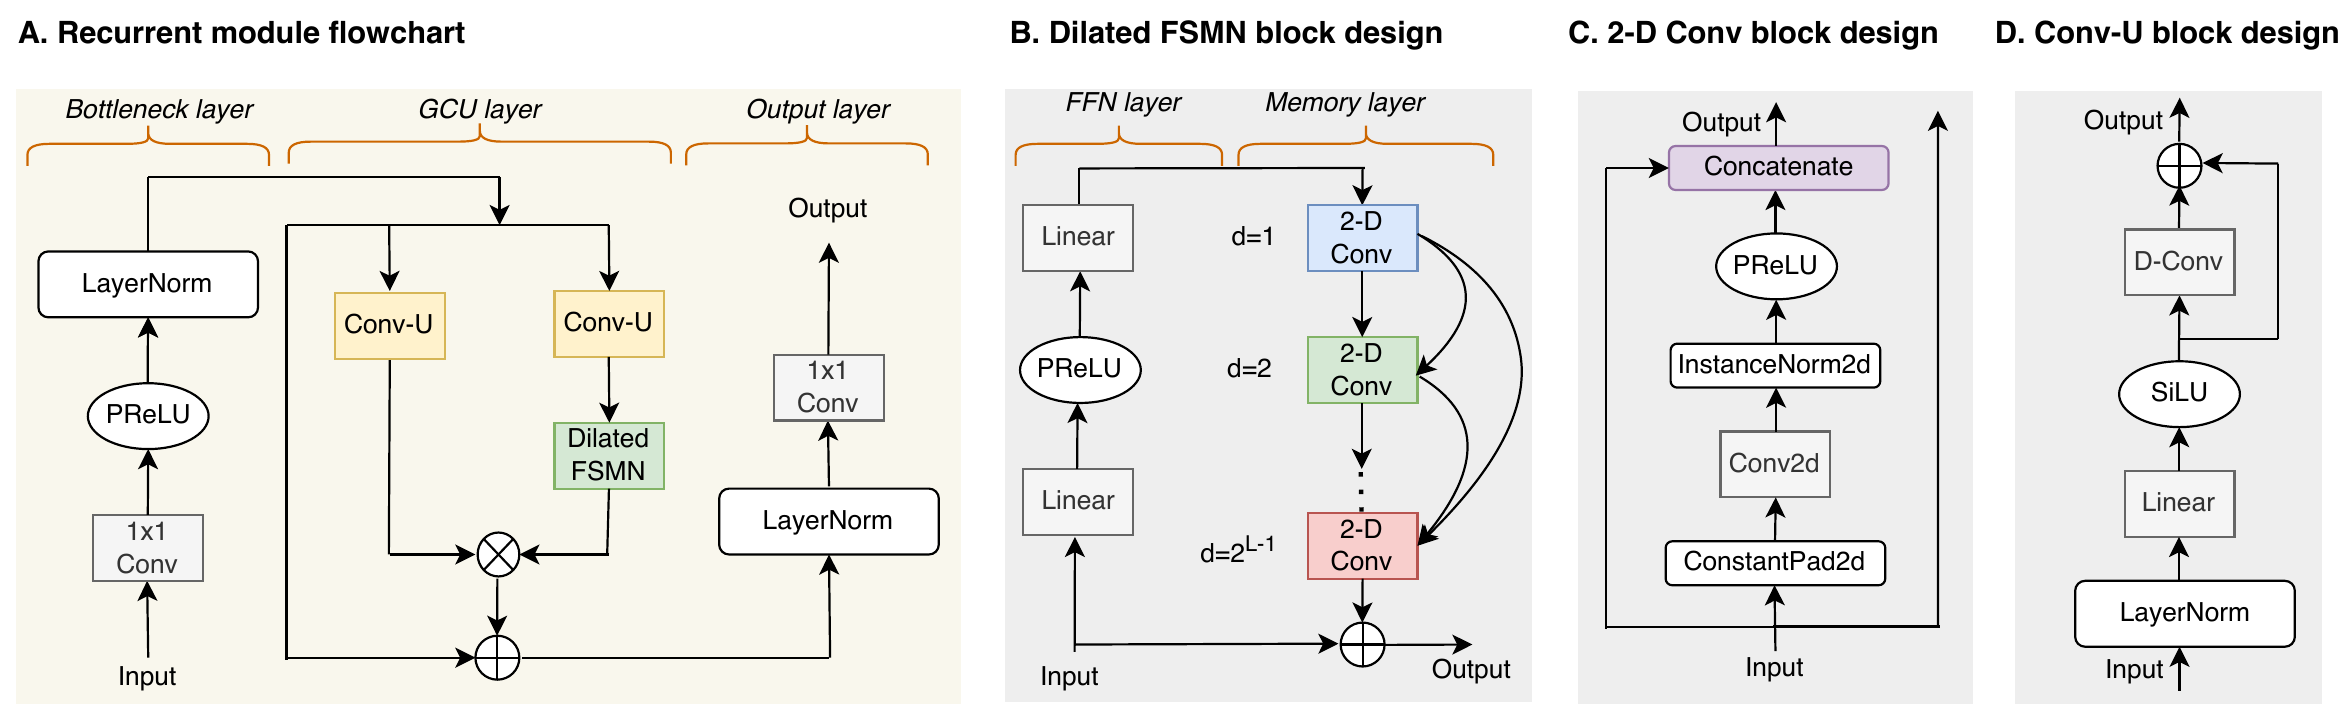
Кожен рядок зберігає власну архітектуру, метрику чи визначення задачі; результати без спільного протоколу лишаються окремими.
| Модель | Архітектура чи докази | Межі |
|---|---|---|
| MossFormer2 SS 16K | розділення спікерів із накладанням | перехресні розмови, обміни ідентичностей, паузи |
| MossFormer2 SE 48K | широкосмугове шумозаглушення та прибирання реверберації | ушкодження приголосних, вилучення музики, хвости кімнати |
| TIGER-speech | орієнтована на ефективність послідовна модель смуг | вимірювати затримку та якість на тих самих файлах |

Для розділення перевіряйте обміни ідентичностей, сибілянти, видихи та хвости реверберації. Покращення може видалити приголосні разом із шумом клавіатури чи вентиляції. Суперроздільну здатність варто оцінювати як правдоподібне розширення смуги, а не відновлення кожного оригінального високочастотного відліку.
Інваріантне до перестановок навчання прибирає порядок виходів із функції втрат, але не гарантує неперервності ідентичності протягом довгої наради. Перед A/B-прогонами фіксуйте частоту дискретизації, передискретизацію та зведення каналів, а обміни спікерами перевіряйте за часовими сегментами.
Моносуміш може не мати єдиного розв'язку, коли спікери мають подібні тембр і висоту голосу, а кількість джерел неможливо визначити без обмежень.
Розширення смуги синтезує правдоподібний зміст. Для криміналістичного, біометричного чи медичного застосування згенеровані високі частоти не є оригінальним доказом.
Назви моделей, числа та обмеження простежуються до статей, репозиторіїв або карток моделей нижче.