Модель
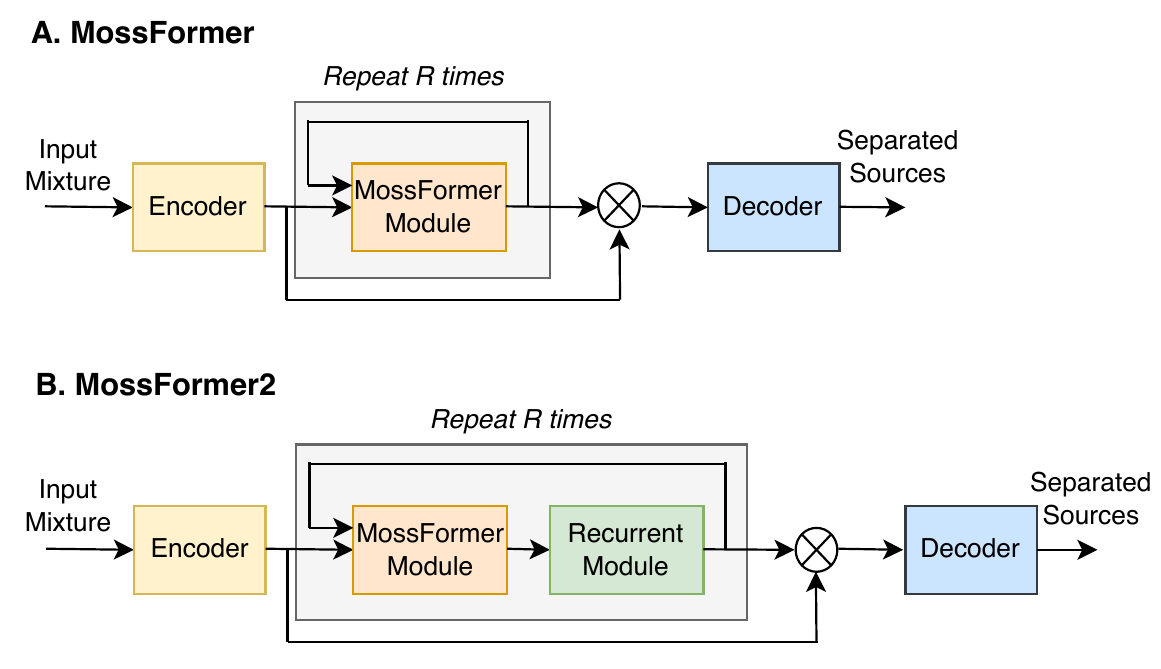
MossFormer2 и TIGER-речь: три разделения задач в голосовом интерфейсе
Голосовой интерфейс/сравнение технологий
Голосовой интерфейс/сравнение технологий
© 2026 TelkNet. Все права защищены.
ФРОНТ-ЭНД РЕЧИ
SS 16K оценивает, кто что сказал. SE 48K оценивает более чистую версию одного голоса. SR 48K восстанавливает полосу частот. Их целевые функции и число выходов различаются.
У выходов нет собственного порядка дикторов: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS справляется с произвольным перекрытием речи. TIGER-speech оставлен для зашумлённых, эхо- и реверберационных записей двух собеседников.
Улучшение выдаёт одну очищенную волну; супер-разрешение предсказывает недостающий верх полосы и способно дорисовывать правдоподобные детали. При оценке нужно указывать частоты дискретизации на входе и выходе и отдельно вслушиваться в повреждения от шумоподавления и в выдуманную высокочастотную текстуру.
Фронт-энды речи выросли в трёх независимых сообществах: разделение для совещаний борется с перекрытием голосов, улучшение — с шумом и реверберацией, супер-разрешение — с недостающей полосой. ClearerVoice-Studio собирает MossFormer2 SS 16K, SE 48K и восстановление полосы за одной инженерной точкой входа, но их цели и контракты на выход по-прежнему разные.
TIGER-speech применяет диапазонно-ориентированное моделирование последовательностей, чтобы снизить стоимость длинного контекста. Это сравнение по эффективности, а не замена MossFormer2 по номеру версии. Развёртывание начинается с ответа на вопрос, что есть в записи: перекрывающиеся голоса, заглушённая речь или обрезанная полоса; неверно выбранная задача даёт отполированный ответ не на тот вопрос.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kперестановки K дикторовπодно сопоставление выхода и эталонаℓошибка восстановления одного сигналаПри разделении двух голосов нет естественного «первого» диктора. PIT выбирает сопоставление выхода с эталоном с наименьшей ошибкой, чтобы нумерация каналов не порождала противоречивое обучающее сигнала.
SS 16K разделяет голоса; SE 48K и SR 48K чинят один сигнал. Общий лидерборд смешал бы задачи, полосы частот и наборы данных.
Статью, код и веса можно проследить через ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
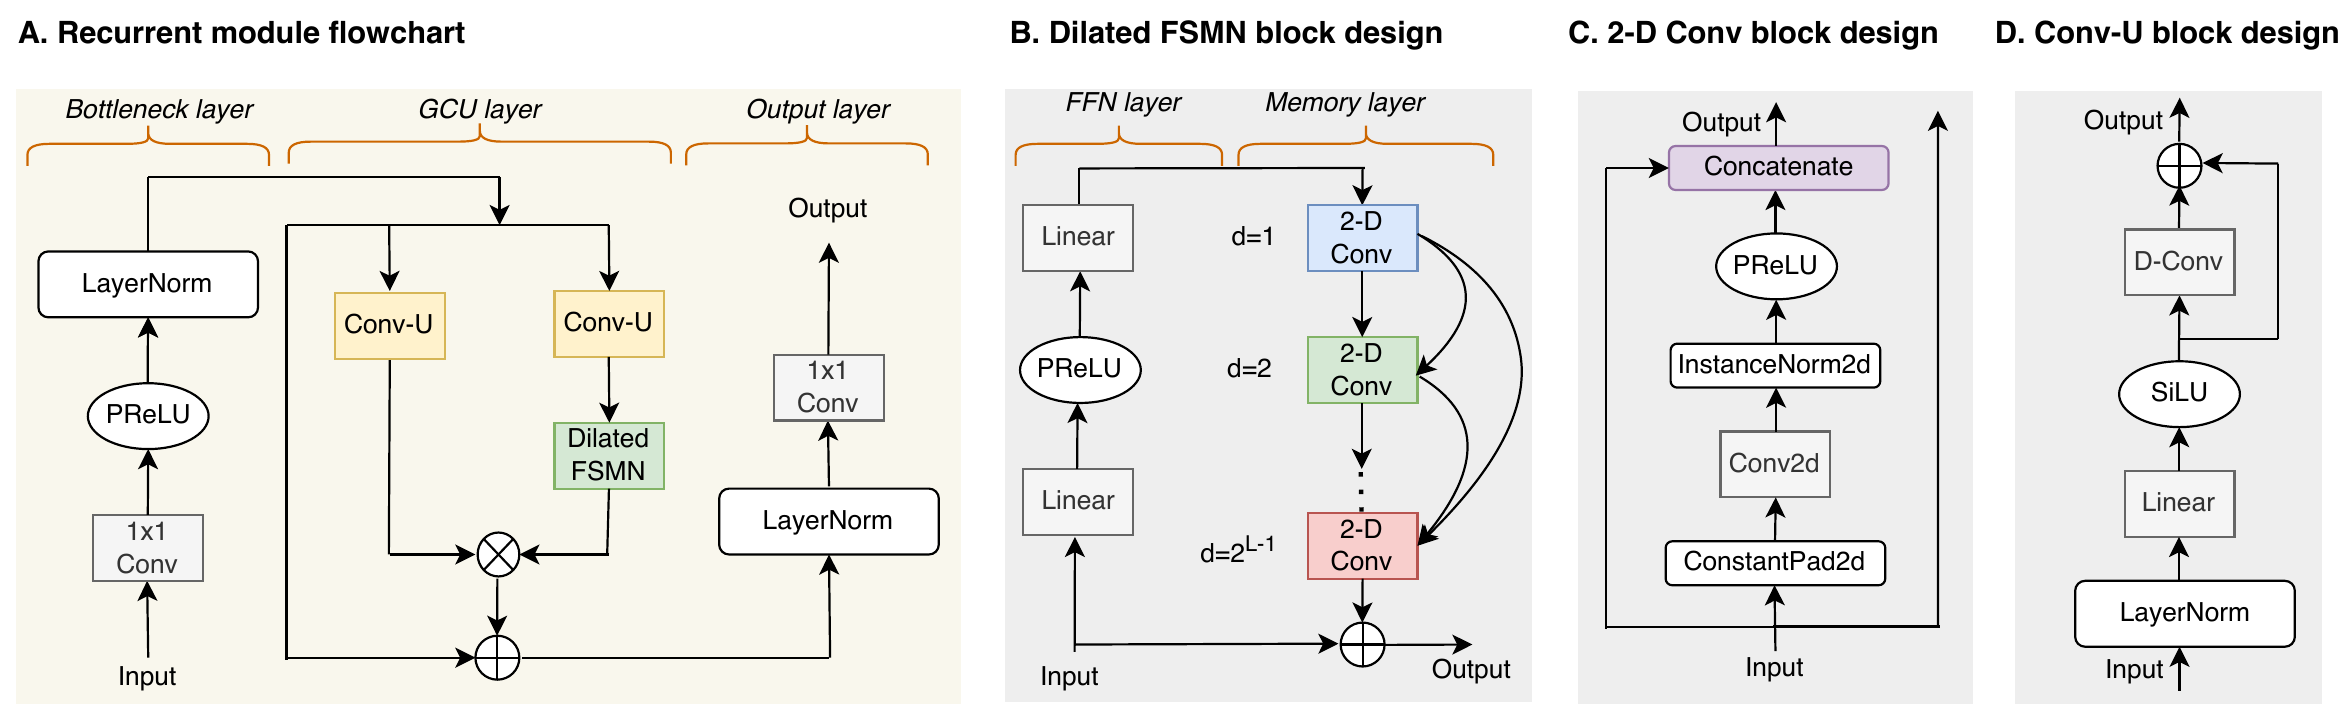
Каждая строка сохраняет исходную архитектуру, метрику или определение задачи; результаты без общего протокола остаются раздельными.
| Модель | Архитектура или данные | Область |
|---|---|---|
| MossFormer2 SS 16K | разделение перекрывающихся голосов | перекрёстная речь, перепутанные голоса, тихие участки |
| MossFormer2 SE 48K | широкополосное шумоподавление и дераверберация | потеря согласных, убранная музыка, хвосты комнаты |
| TIGER-speech | ориентированная на эффективность модель диапазонных последовательностей | задержку и качество измеряют на одних и тех же файлах |

При разделении проверяйте перепутанные голоса, свистящие, вдохи и хвосты реверберации. Улучшение может срезать согласные вместе с шумом клавиатуры или кондиционера. Супер-разрешение стоит оценивать как правдоподобное расширение полосы, а не как восстановление каждого исходного высокочастотного отсчёта.
Обучение, инвариантное к перестановкам, убирает порядок выходов из функции потерь, но не гарантирует постоянства голоса на длинном совещании. Перед A/B-прогонами фиксируйте частоту дискретизации, передискретизацию и сведение каналов, а перестановки дикторов проверяйте по временным отрезкам.
У монофонической смеси может не быть единственного решения, когда голоса близки по тембру и высоте, а число источников нельзя вывести без ограничений.
Расширение полосы синтезирует правдоподобное содержимое. Для судебной экспертизы, биометрии или медицины сгенерированные верхние частоты не являются исходным доказательством.
Названия моделей, числа и ограничения восходят к статьям, репозиториям или карточкам моделей ниже.