모델
MossFormer2 및 TIGER-speech: 음성 프런트엔드의 세 가지 작업 부문
음성 프론트엔드 / 기술 비교
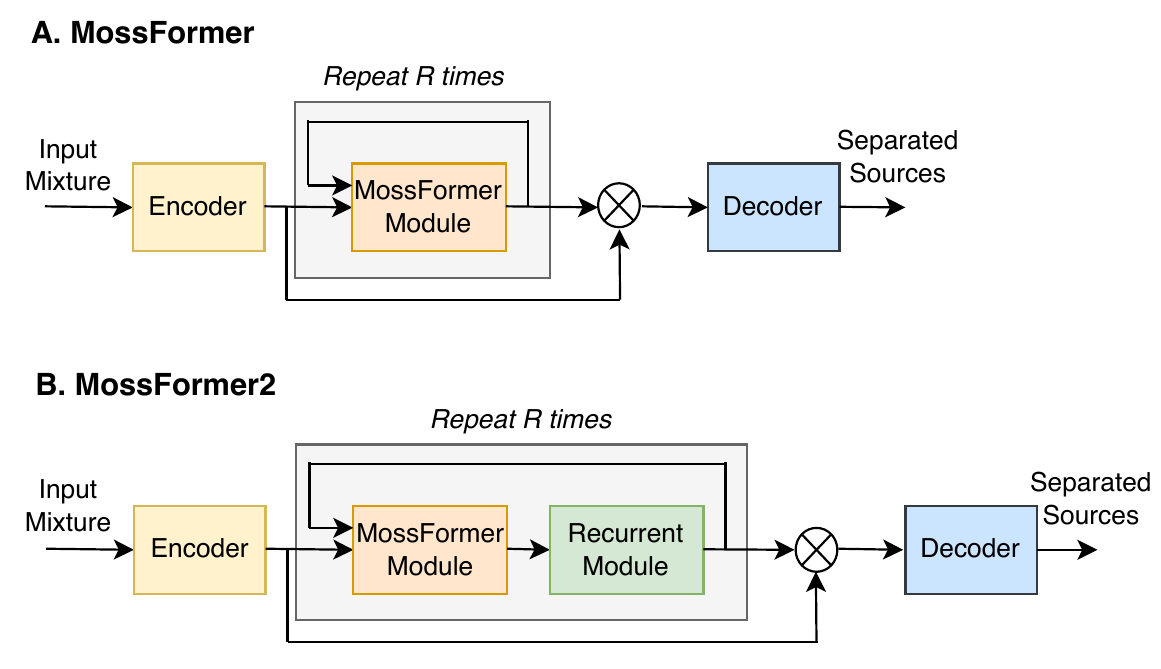
음성 프론트엔드 / 기술 비교
© 2026 텔크넷. 판권 소유.
스피치 프런트 엔드
SS 16K는 누가 무슨 말을 했는지를 추정한다. SE 48K는 한 화자의 음성을 더 깨끗한 형태로 추정한다. SR 48K는 대역폭을 재구성한다. 세 작업은 지도 신호도, 출력 개수도 서로 다르다.
출력에는 고유한 화자 순서가 없다: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS는 일반적인 겹침 상황을 다룬다. TIGER-speech는 잡음, 울림, 잔향이 섞인 두 사람 녹음을 위해 남겨 둔다.
향상은 정제된 파형 하나를 만들어 내고, 초해상도는 사라진 고주파 대역 정보를 예측하면서 그럴듯한 디테일을 지어 낼 수도 있다. 평가할 때는 입력과 출력의 샘플레이트를 명시하고, 노이즈 제거 과정의 손상과 만들어진 고주파 질감을 따로 들어 봐야 한다.
스피치 프런트 엔드는 서로 다른 세 커뮤니티에서 자라 왔다. 회의 분리는 겹침을, 향상은 잡음과 잔향을, 초해상도는 빠진 대역폭을 다룬다. ClearerVoice-Studio는 MossFormer2 SS 16K, SE 48K, 대역폭 복원을 하나의 엔지니어링 진입점 뒤에 묶어 두었지만, 각자의 목표와 출력 계약은 여전히 다르다.
TIGER-speech는 밴드 인식 시퀀스 모델링으로 긴 컨텍스트의 비용을 줄인다. 이는 효율 비교이지 MossFormer2를 대체하는 차기 버전이 아니다. 배치 전에는 녹음에 겹친 화자가 있는지, 마스킹된 음성이 있는지, 없는 대역폭이 있는지를 먼저 판단해야 한다. 잘못된 과제를 선택하면 잘못된 질문에 대한 세련된 답만 얻게 된다.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_KK명의 화자 순열π하나의 출력·참조 할당ℓ단일 신호 재구성 손실두 화자 분리에는 자연스러운 첫 번째 화자가 없다. PIT는 손실이 가장 낮은 출력·참조 할당을 골라, 채널 번호가 모순된 지도 신호를 만들지 않게 한다.
SS 16K는 화자를 가르고, SE 48K와 SR 48K는 하나의 신호를 복구한다. 하나의 리더보드에 합치면 과제, 대역폭, 데이터셋이 뒤섞인다.
논문, 코드, 가중치는 ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K를 통해 따라갈 수 있다.
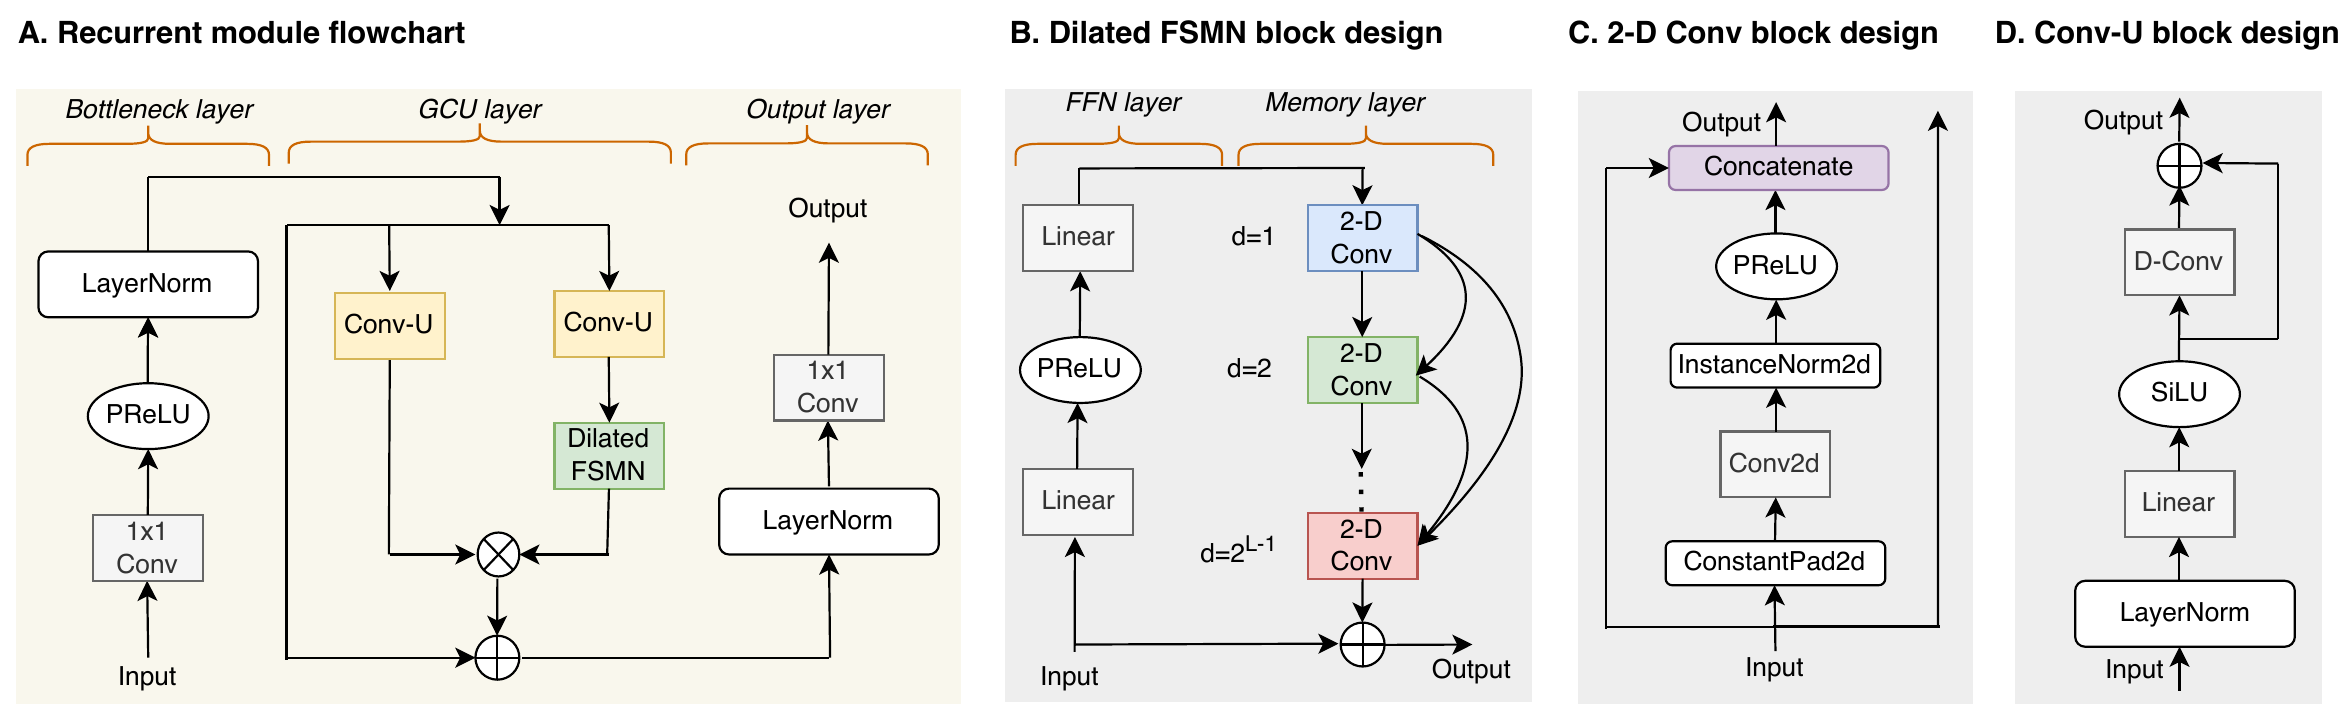
각 행은 원래의 아키텍처, 지표, 과제 정의를 그대로 유지한다. 공통 프로토콜이 없는 결과는 분리해 둔다.
| 모델 | 아키텍처 또는 근거 | 확인 범위 |
|---|---|---|
| MossFormer2 SS 16K | 겹친 화자 분리 | 크로스토크, 화자 뒤바뀜, 무음 구간 |
| MossFormer2 SE 48K | 광대역 노이즈·잔향 제거 | 자음 손상, 음악 제거, 룸 테일 |
| TIGER-speech | 효율 중심 밴드 시퀀스 모델 | 같은 파일에서 지연과 품질 측정 |

분리 결과를 들을 때는 화자 뒤바뀜, 치찰음, 숨소리, 잔향 꼬리를 확인한다. 향상은 키보드나 HVAC 소음과 함께 자음까지 지워 버릴 수 있다. 초해상도는 원래 고주파 샘플을 모두 되찾은 것이 아니라 그럴듯한 대역 확장으로 평가해야 한다.
순열 불변 학습은 손실에서 출력 순서를 없앨 뿐, 긴 회의에서 화자 정체성의 연속성까지 보장하지는 않는다. A/B 비교 전에 샘플레이트, 리샘플링, 채널 폴드다운을 기록하고, 시간 구간별로 화자 뒤바뀜을 살펴야 한다.
화자들의 음색과 피치가 비슷하면 모노 믹스에는 유일한 해가 없을 수 있고, 소스 개수도 무한정 추론할 수는 없다.
대역 확장은 그럴듯한 내용을 합성한다. 법의학, 생체 인식, 의료 용도에서 생성된 고주파는 원본 증거가 아니다.
모델 이름, 수치, 한계는 아래 논문, 저장소, 모델 카드에서 확인할 수 있다.