モデル
MossFormer2 と TIGER-speech: 音声フロントエンドのタスクの 3 つの分割
音声フロントエンド/テクノロジーの比較
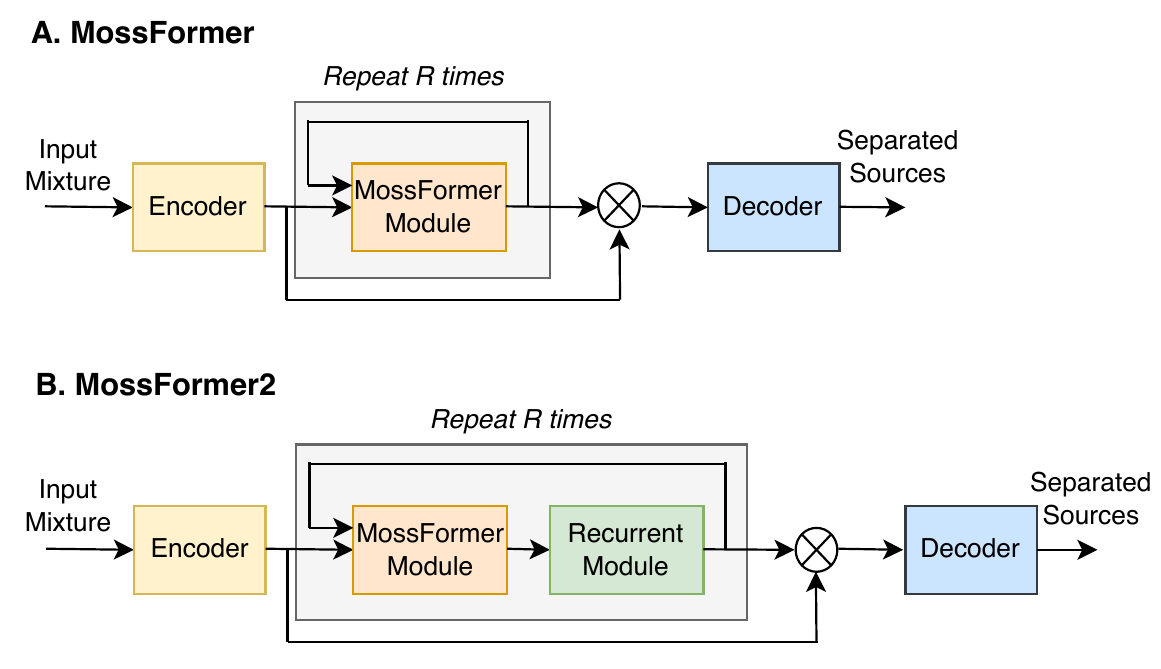
音声フロントエンド/テクノロジーの比較
© 2026 TelkNet。無断転載を禁じます。
音声フロントエンド
SS 16Kは誰が何を話したかを推定する。SE 48Kは一人の話者のよりクリーンな姿を推定する。SR 48Kは帯域を再構成する。教師信号も出力の個数も、それぞれに異なる。
出力に本来の話者順序は存在しない:L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)})。MossFormer2 SSは一般的なオーバーラップを扱う。TIGER-speechは、ノイズ・エコー・残響のある二人会話の録音向けに残されている。
強調はクリーン化された一本の波形を出力する。超解像は欠落した高域の情報を予測するため、もっともらしい細部を捏造することもある。評価では入出力のサンプルレートを明記し、デノイズによる破損と作り出された高域の質感を分けて聴き取る必要がある。
音声フロントエンドは三つの別々のコミュニティで育ってきた。会議向けの分離はオーバーラップを、強調はノイズと残響を、超解像は失われた帯域を対象とする。ClearerVoice-StudioはMossFormer2 SS 16K、SE 48K、帯域復元を一つのエンジニアリング上の入口にまとめているが、目的と出力の約束事は依然として別物だ。
TIGER-speechは帯域を意識した系列モデリングで長文脈のコストを抑える。これは効率面の比較であって、MossFormer2のバージョン番号上の後継ではない。導入の第一歩は、録音に話者の重なりがあるのか、マスクされた音声なのか、失われた帯域なのかを見極めることだ。課題を取り違えると、間違った問いに磨き上げられた答えが返ってくる。
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_KK話者の置換全体π出力と参照の対応づけの一つℓ単一信号の再構成損失二人分離に当然の一人目は存在しない。PITは損失が最小になる出力と参照の割り当てを選ぶため、チャンネル番号が矛盾した教師信号を生み出さない。
SS 16Kは話者を分け、SE 48KとSR 48Kは一つの信号を修復する。共通のリーダーボードに載せれば、タスクも帯域もデータセットも混ざってしまう。
論文・コード・重みは、ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48Kからたどれる。
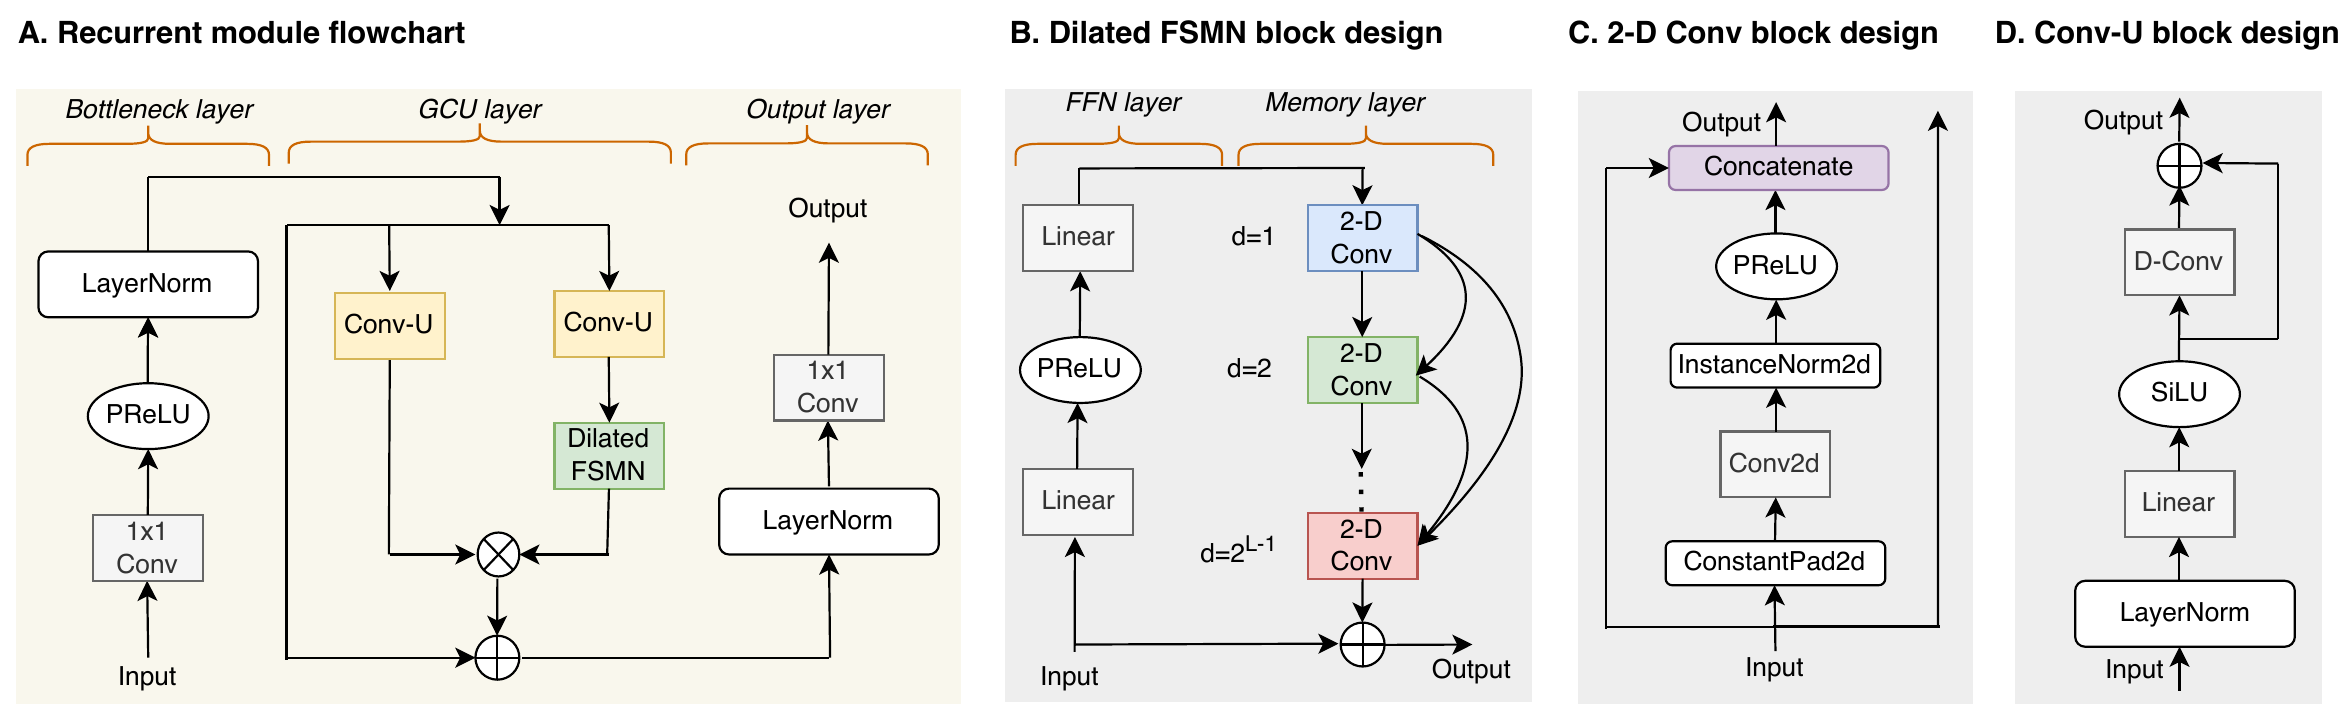
各行は出典となるアーキテクチャ・指標・タスク定義をそのまま保持する。共通プロトコルのない結果は別々のままにしてある。
| モデル | アーキテクチャまたは根拠 | 観測範囲 |
|---|---|---|
| MossFormer2 SS 16K | 重なり話者の分離 | クロストーク、話者の入れ替わり、無音区間 |
| MossFormer2 SE 48K | 広帯域のデノイズとデリバーブ | 子音の破損、音楽成分の除去、ルーム残響の尻尾 |
| TIGER-speech | 効率重視の帯域系列モデル | 同一ファイルで遅延と品質を測る |

分離では、話者の入れ替わり、歯擦音、ブレス、残響の尻尾を確認する。強調は、キーボード音や空調ノイズと一緒に子音まで消すことがある。超解像はもっともらしい帯域拡張として判断すべきであり、元の高域サンプルをすべて復元したとみなしてはいけない。
置換不変学習は損失から出力順序を取り除くが、長い会議にわたる話者の一貫性までは保証しない。A/B比較の前にサンプルレート、リサンプリング、チャンネルの折りたたみを記録し、話者の入れ替わりは時間区間ごとに点検する。
モノラル混合では、音色やピッチの似た話者がいると一意解が存在しない場合があり、音源数も限界なく推定できるわけではない。
帯域拡張はもっともらしい内容を合成する。フォレンジック、生体認証、医療の用途では、生成された高域は原本の証拠として扱えない。
モデル名・数値・制約事項は、以下の論文、リポジトリ、モデルカードに照合できる。