Modelo
MossFormer2 e TIGER-speech: três divisões de tarefas no front-end de voz
Comparação front-end de voz/tecnologia
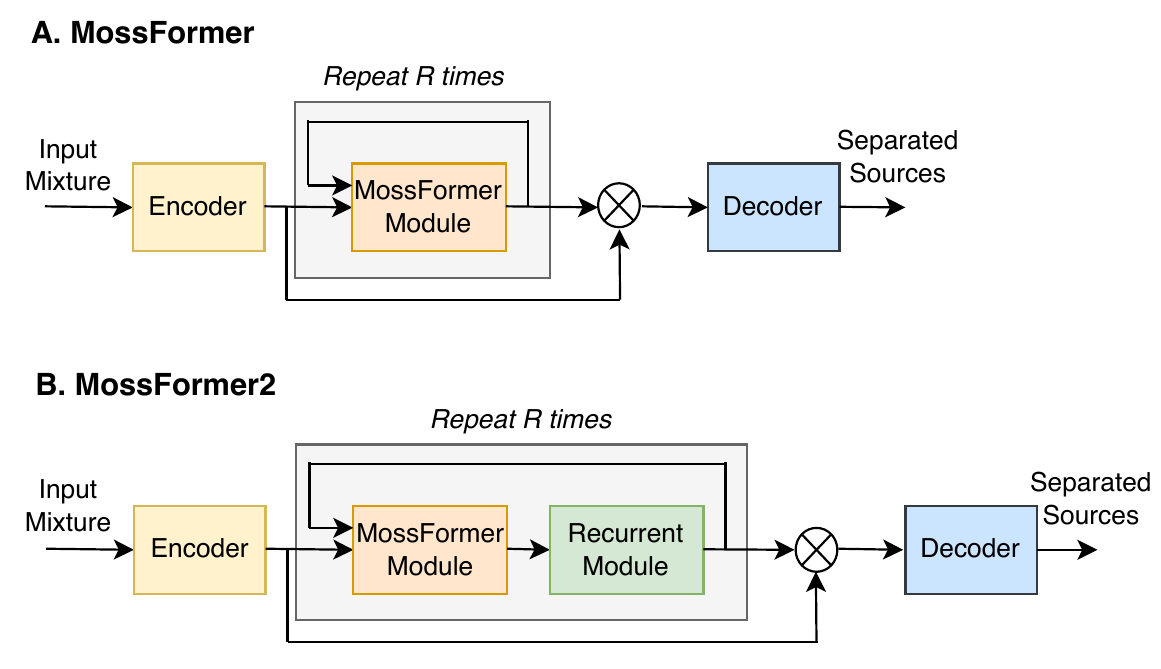
Comparação front-end de voz/tecnologia
© 2026 TelkNet. Todos os direitos reservados.
FRONT-END DE FALA
O SS 16K estima quem disse o quê. O SE 48K estima uma versão mais limpa de um único locutor. O SR 48K reconstrói largura de banda. A supervisão e a cardinalidade de saída de cada um são diferentes.
As saídas não têm uma ordem intrínseca de locutor: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). O MossFormer2 SS lida com sobreposição em geral. O TIGER-speech é mantido para gravações de duas pessoas com ruído, eco e reverberação.
O aprimoramento produz uma única forma de onda limpa; a super-resolução prevê a informação ausente na banda superior e pode alucinar detalhes plausíveis. A avaliação precisa declarar as taxas de amostragem de entrada e saída e ouvir separadamente o dano da redução de ruído e a textura de alta frequência inventada.
Os front-ends de fala cresceram em três comunidades distintas: a separação para reuniões mira a sobreposição, o aprimoramento mira ruído e reverberação, e a super-resolução mira a largura de banda ausente. O ClearerVoice-Studio coloca MossFormer2 SS 16K, SE 48K e a restauração de banda atrás de um único ponto de entrada de engenharia, mas seus objetivos e contratos de saída continuam diferentes.
O TIGER-speech aplica modelagem de sequência ciente das bandas para reduzir o custo de contextos longos. É uma comparação de eficiência, não um substituto de número de versão para o MossFormer2. A implantação começa decidindo se a gravação contém locutores sobrepostos, fala mascarada ou largura de banda ausente; a tarefa errada produz uma resposta polida para a pergunta errada.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kpermutações de K locutoresπuma atribuição saída/referênciaℓperda de reconstrução de sinal únicoA separação de dois locutores não tem um primeiro locutor natural. O PIT escolhe a atribuição saída/referência de menor perda para que a numeração dos canais não crie supervisão contraditória.
O SS 16K separa locutores; o SE 48K e o SR 48K reparam um único sinal. Um placar compartilhado misturaria tarefa, largura de banda e conjuntos de dados.
O artigo, o código e os pesos podem ser acompanhados por ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
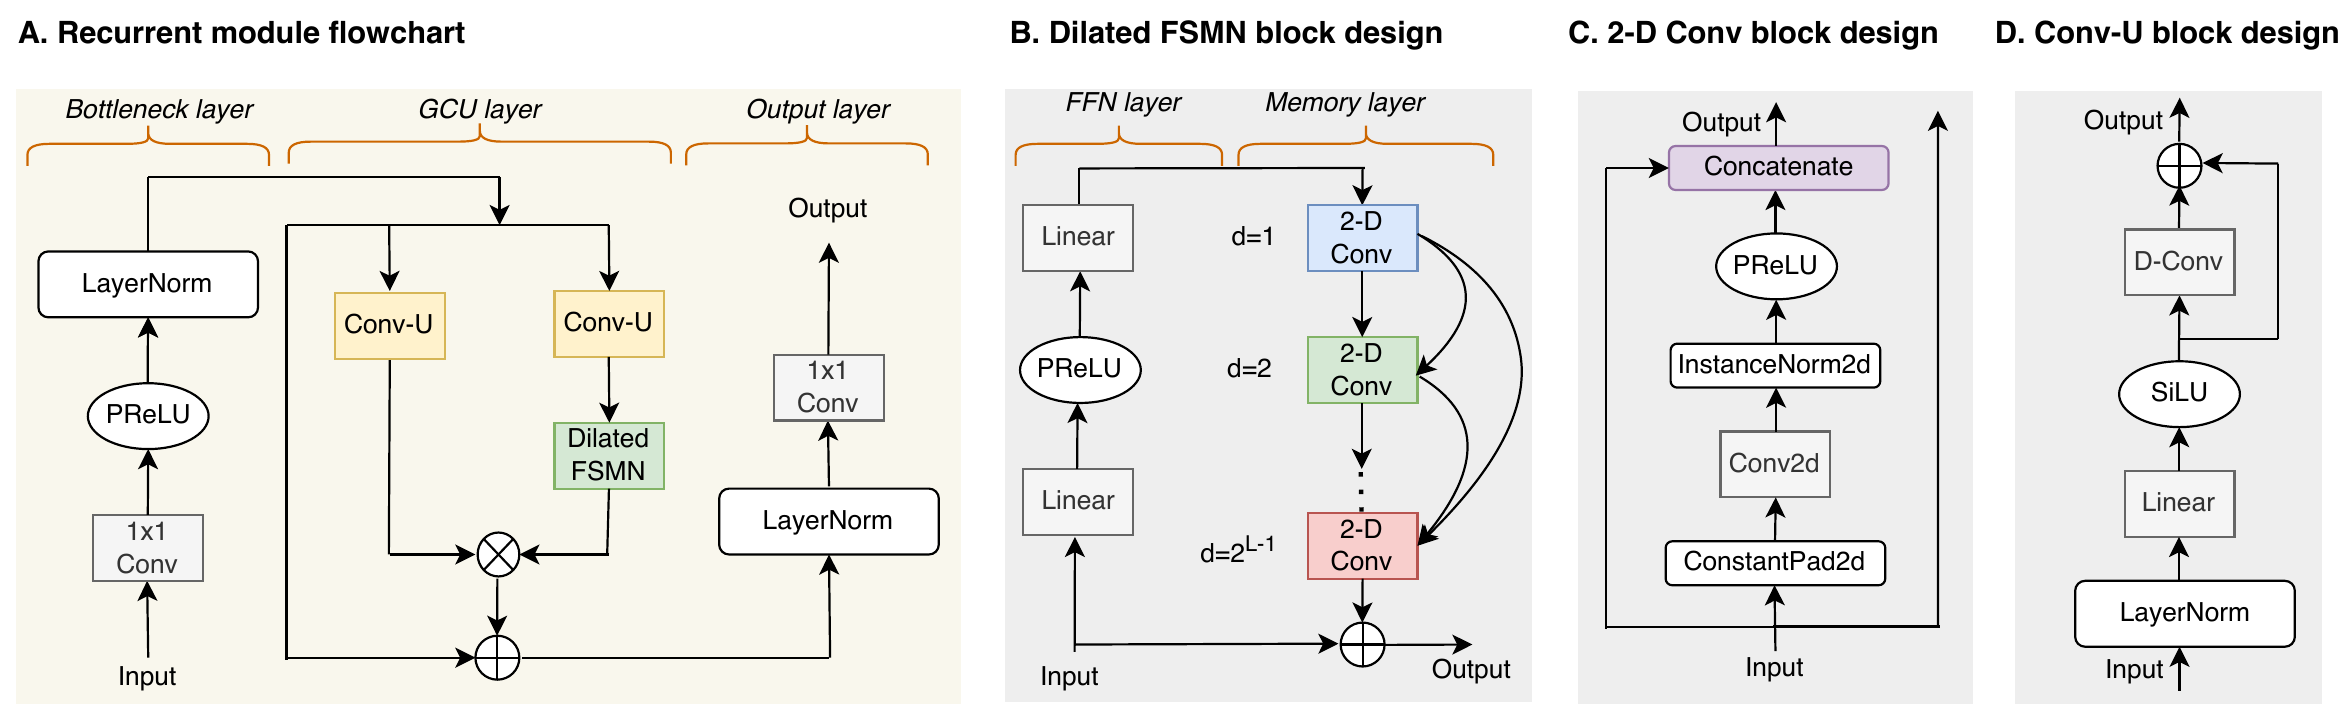
Cada linha mantém sua arquitetura de origem, métrica ou definição de tarefa; resultados sem um protocolo comum permanecem separados.
| Modelo | Arquitetura ou evidência | Escopo |
|---|---|---|
| MossFormer2 SS 16K | separação de locutores sobrepostos | voz cruzada, trocas de identidade, regiões silenciosas |
| MossFormer2 SE 48K | redução de ruído e dereverberação em banda larga | dano a consoantes, remoção de música, caudas de sala |
| TIGER-speech | modelo de sequência de bandas orientado à eficiência | medir latência e qualidade nos mesmos arquivos |

Na separação, verifique trocas de identidade, sibilantes, respirações e caudas de reverberação. O aprimoramento pode remover consoantes junto com o ruído de teclado ou de HVAC. A super-resolução deve ser julgada como uma extensão plausível de banda, não como a recuperação de cada amostra original de alta frequência.
O treinamento invariante à permutação remove a ordenação das saídas da perda, mas não garante continuidade de identidade ao longo de uma reunião longa. Registre taxa de amostragem, reamostragem e fold-down de canais antes das execuções A/B e inspecione as trocas de locutor por segmento de tempo.
Uma mistura mono pode não ter solução única quando os locutores têm timbre e altura semelhantes, e o número de fontes não pode ser inferido sem limite.
A extensão de banda sintetiza conteúdo plausível. Para uso forense, biométrico ou médico, as altas frequências geradas não são evidência original.
Nomes de modelos, números e limitações remetem aos artigos, repositórios ou cartões de modelo abaixo.