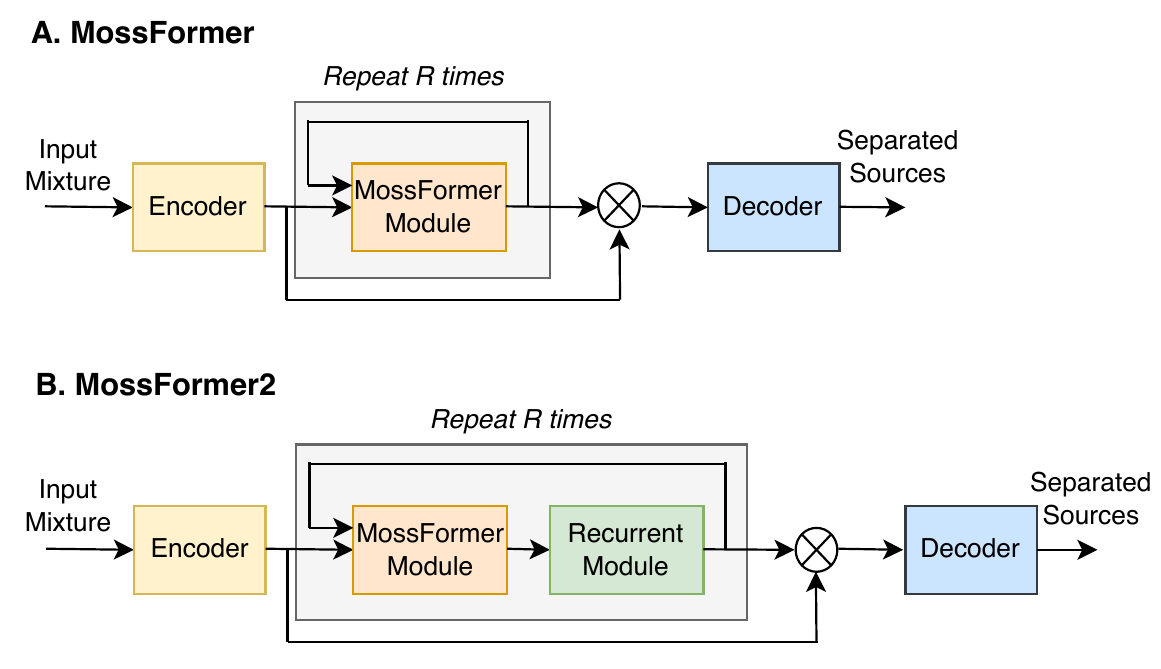
MossFormer2 與 TIGER-speech:語音前端的三種任務分工
語音前端 / 技術比較
語音前端
SS 16K 估算誰說了什麼;SE 48K 估算單一說話者更乾淨的版本;SR 48K 重建頻寬。三者的監督方式與輸出數量並不相同。
置換不變訓練
輸出本身沒有固定的說話者順序:L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)})。MossFormer2 SS 可處理一般性的重疊語音;TIGER-speech 則保留給嘈雜、帶回音與混響的雙人錄音。
增強與超解析度
增強產出一條清理過的波形;超解析度預測缺失的高頻段資訊,也可能憑空生成看似合理的細節。評估時必須寫明輸入與輸出的取樣率,並分開聆聽去噪造成的損傷與虛構出來的高頻質地。
聲學表示如何演變
語音前端在三個彼此獨立的社群裡各自成長:會議分離對付重疊語音,增強對付噪音與混響,超解析度對付缺失的頻寬。ClearerVoice-Studio 把 MossFormer2 SS 16K、SE 48K 與頻寬重建收進同一個工程入口,但三者的目標與輸出契約依然不同。
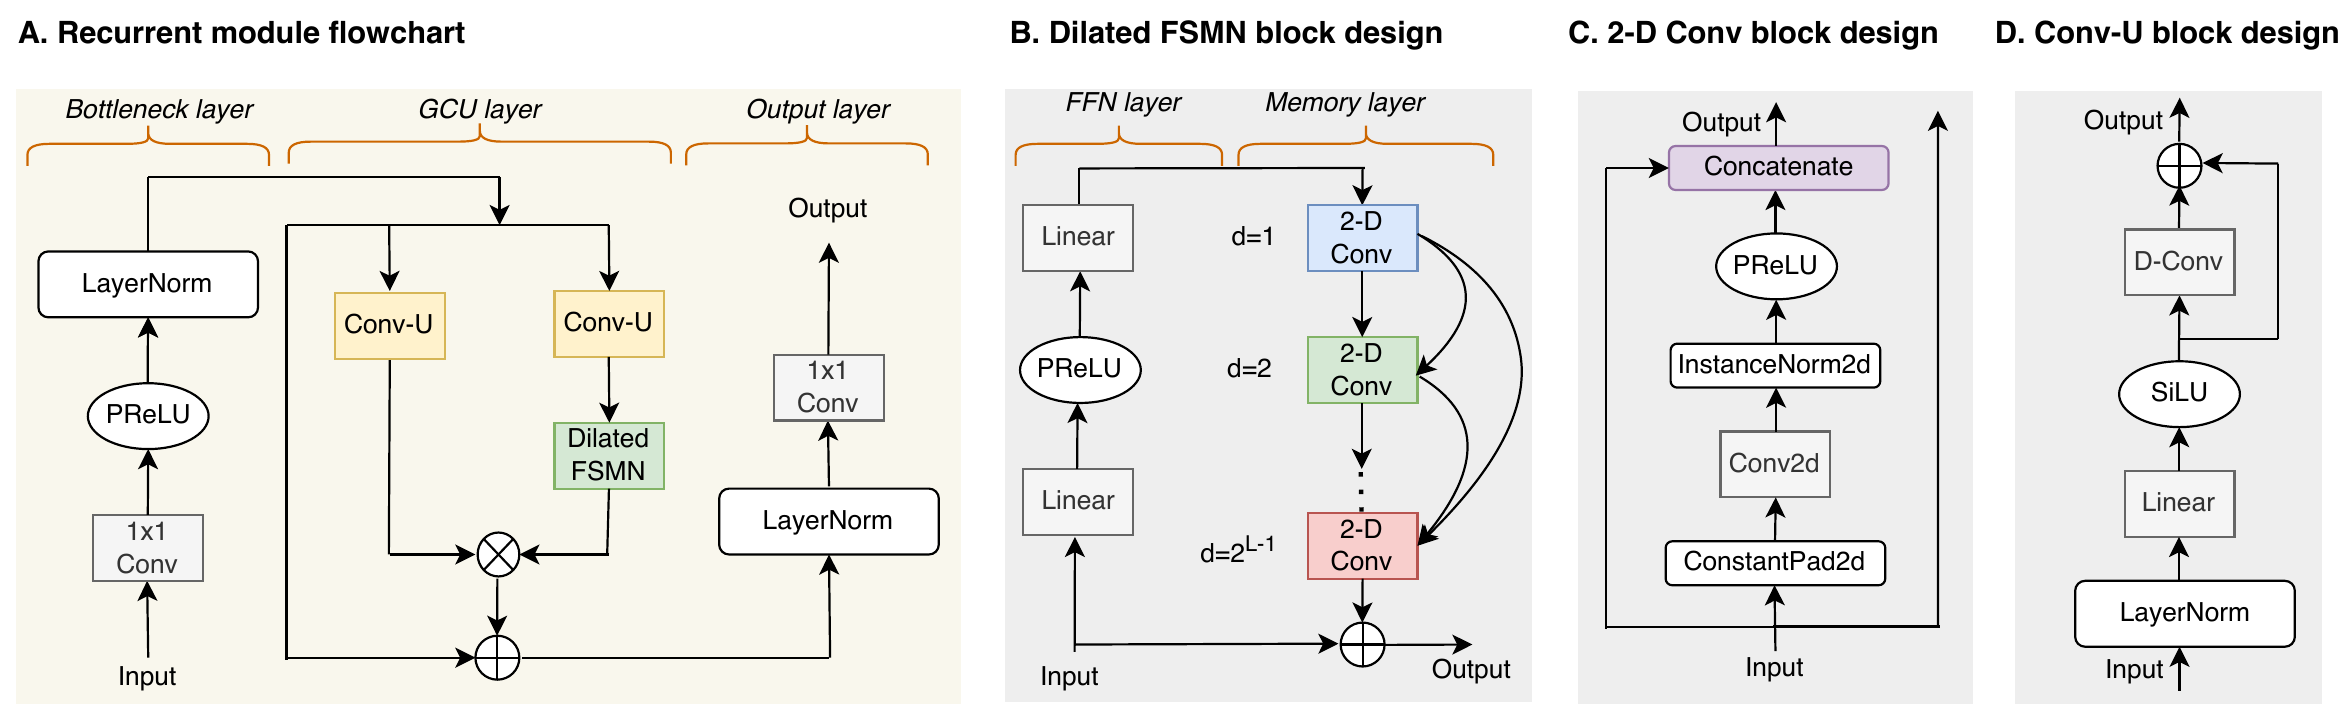
TIGER-speech 用頻帶感知的序列建模壓低長上下文的成本。它比較的是效率,與 MossFormer2 之間沒有版本號遞進的取代關係。部署前要先判斷錄音裡是重疊的說話者、被遮蔽的語音,還是缺失的頻寬;選錯任務,只會替錯誤的問題產出漂亮的答案。
未知說話者順序下的置換不變目標
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_KK 位說話者的所有置換π一組輸出與參考的對應ℓ單一訊號的重建損失
雙人分離沒有天生的第一位說話者。PIT 挑出損失最低的輸出與參考對應,讓聲道編號不致產生自相矛盾的監督。
SS 16K 分離說話者;SE 48K 與 SR 48K 修復單一訊號。若共用一張排行榜,任務、頻寬與資料集都會被混在一起。
論文、程式碼與權重可沿 ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K 逐一查閱。
每個語音指標各自回答什麼
每一列保留各自的來源架構、指標或任務定義;沒有共同協議的結果維持分列。
| 模型 | 架構或證據 | 適用範圍 |
|---|---|---|
| MossFormer2 SS 16K | 重疊說話者分離 | 串音、身分錯置、靜音區段 |
| MossFormer2 SE 48K | 寬頻去噪與去混響 | 子音損傷、音樂移除、房間殘響尾 |
| TIGER-speech | 效率取向的頻帶序列模型 | 在相同檔案上量測延遲與品質 |

內容、音色與長時間聆聽
檢查分離結果時,留意身分錯置、齒擦音、呼吸聲與混響尾。增強可能把子音連同鍵盤聲或空調噪音一起抹除。超解析度只能當作合理的頻寬延伸來評斷,不代表每一個原始高頻取樣都被找回。
置換不變訓練把輸出順序排除在損失之外,但無法保證長會議中的身分連續性。A/B 對比之前,先記錄取樣率、重取樣與聲道下混方式,再按時間分段檢查說話者互換。
音色相近留下的風險
說話者音色與音高相近時,單聲道混合訊號可能沒有唯一解,聲源數量也無法毫無限制地推斷出來。
頻寬延伸合成的是看似合理的內容。用於鑑識、生物特徵或醫療用途時,生成的高頻不能視為原始證據。
ClearerVoice-Studio 的論文與公開檔案
模型名稱、數字與限制均可回溯到下列論文、儲存庫或模型卡。