نموذج
MossFormer2 وTIGER-speech: ثلاثة أقسام للمهام في الواجهة الأمامية الصوتية
الواجهة الأمامية الصوتية/مقارنة التكنولوجيا
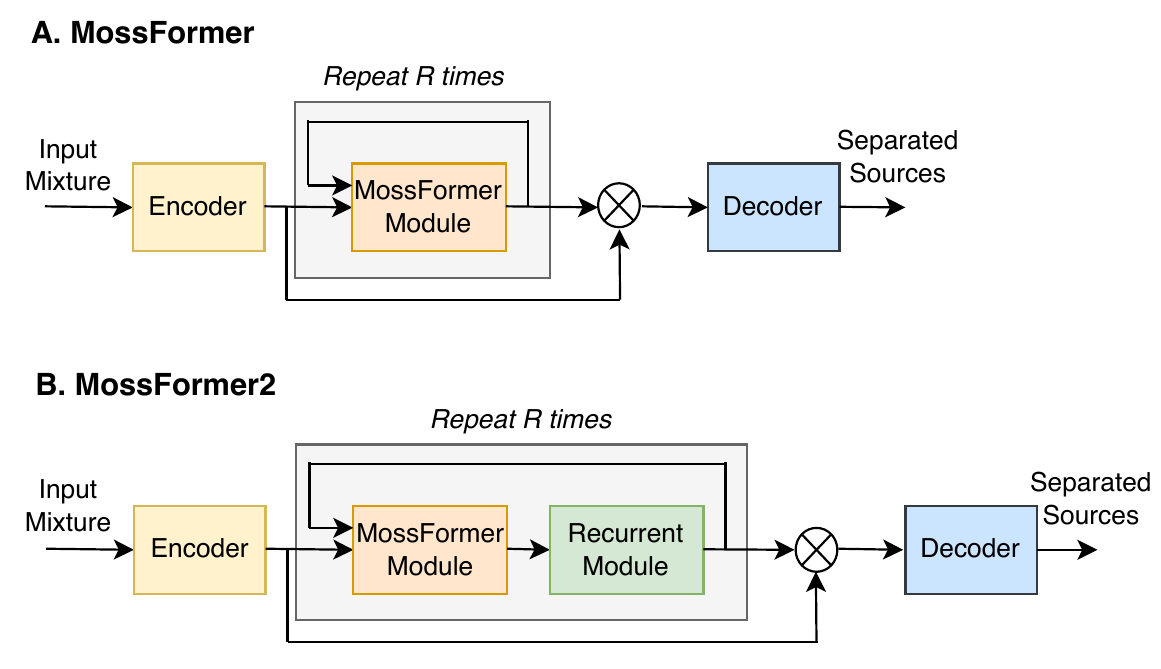
الواجهة الأمامية الصوتية/مقارنة التكنولوجيا
الواجهة الأمامية للكلام
يقدّر SS 16K من قال ماذا، بينما يقدّر SE 48K نسخة أنظف لصوت متحدث واحد، ويعيد SR 48K بناء النطاق الترددي. تختلف آلية الإشراف وعدد المخرجات بين هذه المهام الثلاث.
لا تحمل المخرجات ترتيبًا أصيلًا للمتحدثين: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). يتعامل MossFormer2 SS مع التداخل العام بين الأصوات، في حين يُحتفظ بـTIGER-speech للتسجيلات الصاخبة المشوبة بالصدى والارتداد بين شخصين.
ينتج التحسين موجة واحدة منقّاة، بينما يتنبأ رفع الدقة بالمعلومات المفقودة في النطاق العلوي وقد يختلق تفاصيل تبدو معقولة. لذا يجب أن يذكر التقييم معدلَي العينات للدخل والخرج، وأن يُستمع بشكل منفصل إلى ضرر إزالة الضوضاء وإلى النسيج العالي التردد المُختلَق.
نشأت الواجهات الأمامية للكلام في ثلاث مجتمعات منفصلة: فصل الاجتماعات يستهدف التداخل، والتحسين يستهدف الضوضاء والارتداد، ورفع الدقة يستهدف النطاق الترددي المفقود. يضع ClearerVoice-Studio كلًا من MossFormer2 SS 16K وSE 48K واستعادة النطاق الترددي خلف نقطة دخول هندسية واحدة، لكن أهدافها وعقود مخرجاتها تبقى مختلفة.
يطبّق TIGER-speech نمذجة تسلسلية واعية بالنطاقات لتقليل كلفة السياقات الطويلة. إنه مقارنة في الكفاءة، وليس بديلًا عن MossFormer2 برقم إصدار أعلى. يبدأ النشر بتحديد ما إذا كان التسجيل يحوي متحدثين متداخلين أو كلامًا مكتومًا أو نطاقًا تردديًا ناقصًا؛ فاختيار المهمة الخاطئة يعطي إجابة مصقولة عن السؤال الخاطئ.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kتبديلات المتحدثين Kπتعيين واحد بين المخرجات والمراجعℓخسارة إعادة بناء إشارة مفردةلا يوجد «متحدث أول» طبيعي عند فصل متحدثَين. يختار PIT التعيين الأدنى خسارة بين المخرجات والمراجع كي لا يولّد ترقيم القنوات إشرافًا متناقضًا.
يفصل SS 16K المتحدثين، بينما يصلح SE 48K وSR 48K إشارة واحدة. أي لوحة صدارة مشتركة ستخلط بين المهمة والنطاق الترددي ومجموعات البيانات.
يمكن تتبع الورقة والشيفرة والأوزان عبر ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
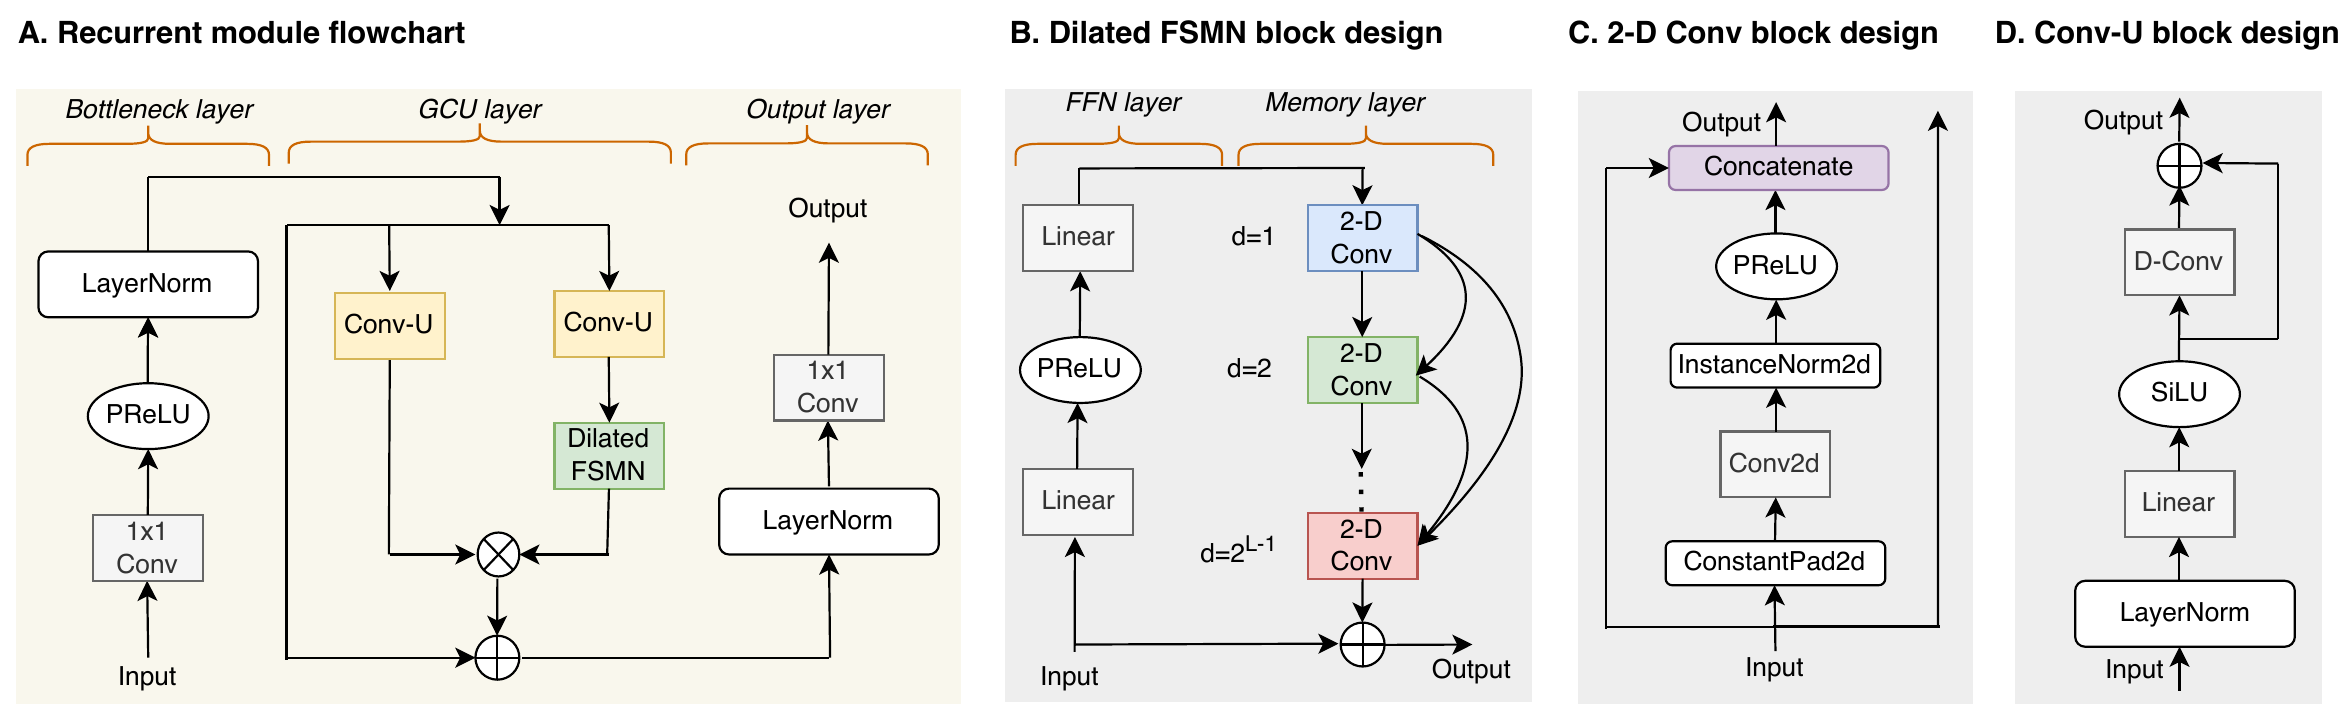
يحتفظ كل صف ببنيته المصدرية أو بتعريف مقياسه أو مهمته؛ فالنتائج التي لا تشترك في بروتوكول واحد تبقى منفصلة.
| النموذج | البنية أو الدليل | النطاق |
|---|---|---|
| MossFormer2 SS 16K | فصل المتحدثين المتداخلين | الكلام المتقاطع، تبادلات الهوية، المقاطع الصامتة |
| MossFormer2 SE 48K | إزالة الضوضاء والارتداد عريضة النطاق | تلف الحروف الساكنة، إزالة الموسيقى، ذيول الغرفة |
| TIGER-speech | نموذج تسلسلي نطاقي موجّه نحو الكفاءة | قياس زمن الاستجابة والجودة على الملفات نفسها |

عند الفصل، تحقق من تبادلات الهوية والأصوات السهمية والأنفاس وذيول الارتداد. قد يزيل التحسين الحروف الساكنة مع ضوضاء لوحة المفاتيح أو التكييف. أما رفع الدقة فيجب الحكم عليه بوصفه توسيعًا معقولًا للنطاق الترددي، لا استعادةً لكل عينة أصلية عالية التردد.
يزيل التدريب غير المتأثر بالتبديل ترتيب المخرجات من دالة الخسارة، لكنه لا يضمن استمرارية الهوية عبر اجتماع طويل. سجّل معدل العينات وإعادة أخذ العينات ودمج القنوات قبل تشغيل أي مقارنة A/B، وافحص تبدلات المتحدثين مقطعًا زمنيًا بمقطع.
قد لا يملك الخليط الأحادي حلًا فريدًا عندما تتشابه نبرة المتحدثين وطبقة صوتهما، كما لا يمكن استنتاج عدد المصادر بلا حدود.
توسيع النطاق الترددي يُركّب محتوى معقولًا لا أكثر. وفي الاستخدامات الجنائية أو الحيوية أو الطبية، لا تُعدّ الترددات العالية المولّدة دليلًا أصليًا.
تعود أسماء النماذج وأرقامها وقيودها إلى الأوراق أو المستودعات أو بطاقات النماذج أدناه.