โมเดล
MossFormer2 และ TIGER-speech: สามส่วนของงานในส่วนหน้าเสียง
การเปรียบเทียบส่วนหน้าด้วยเสียง / เทคโนโลยี
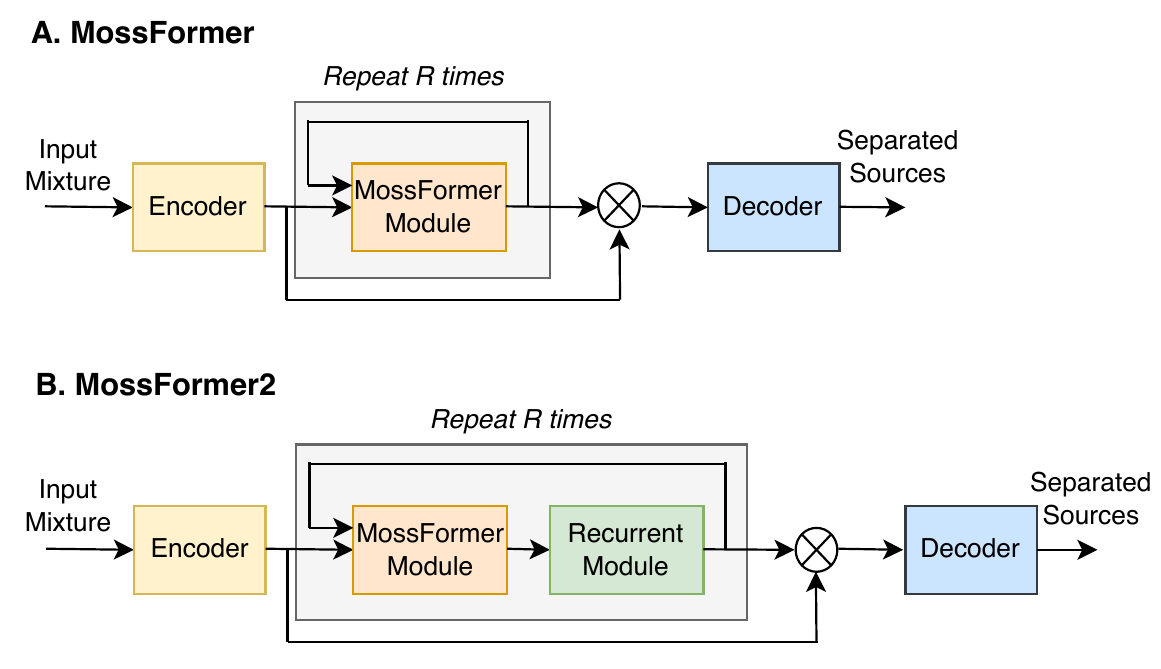
การเปรียบเทียบส่วนหน้าด้วยเสียง / เทคโนโลยี
ส่วนหน้าระบบเสียงพูด
SS 16K ประมาณว่าใครพูดอะไร SE 48K ประมาณเสียงที่สะอาดขึ้นของผู้พูดคนเดียว SR 48K สร้างย่านความถี่ที่หายไปขึ้นมาใหม่ การกำกับดูแลและจำนวนเอาต์พุตของทั้งสามงานต่างกัน
เอาต์พุตไม่มีลำดับผู้พูดในตัว: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}) MossFormer2 SS รองรับการพูดซ้อนทั่วไป ส่วน TIGER-speech ถูกเก็บไว้ใช้กับเทปบันทึกเสียงสองคนที่มีสัญญาณรบกวน เสียงก้อง และเสียงสะท้อน
การเพิ่มคุณภาพเสียงให้คลื่นเสียงที่สะอาดขึ้นเพียงหนึ่งสาย ส่วนซูเปอร์เรโซลูชันทำนายข้อมูลย่านความถี่สูงที่หายไป และอาจสร้างรายละเอียดที่ฟังดูสมเหตุสมผลขึ้นมาเอง การประเมินจึงต้องระบุอัตราสุ่มสัญญาณขาเข้าและขาออกให้ชัด พร้อมฟังแยกกันระหว่างความเสียหายจากการกรองเสียงรบกวนกับลวดลายความถี่สูงที่สร้างขึ้นใหม่
ส่วนหน้าของระบบเสียงพูดเติบโตขึ้นในสามชุมชนที่แยกกัน งานแยกเสียงการประชุมเล็งที่การพูดซ้อนทับ งานเพิ่มคุณภาพเสียงเล็งที่เสียงรบกวนและเสียงสะท้อน ส่วนซูเปอร์เรโซลูชันเล็งที่ย่านความถี่ที่หายไป ClearerVoice-Studio รวม MossFormer2 SS 16K, SE 48K และการบูรณะย่านความถี่ไว้หลังจุดเข้าใช้งานทางวิศวกรรมเดียว แต่เป้าหมายและสัญญาเอาต์พุตของแต่ละตัวยังคงต่างกัน
TIGER-speech ใช้การสร้างแบบจำลองลำดับที่รับรู้ย่านความถี่เพื่อลดต้นทุนของบริบทยาว มันคือการเปรียบเทียบเชิงประสิทธิภาพ ไม่ใช่โมเดลเวอร์ชันใหม่ที่เข้ามาแทน MossFormer2 การใช้งานจริงเริ่มจากการตัดสินใจว่าเทปบันทึกมีเสียงพูดซ้อนทับ เสียงพูดถูกบัง หรือย่านความถี่หายไป เลือกงานผิดก็ได้แต่คำตอบที่ดูเนียนสำหรับคำถามอีกข้อหนึ่ง
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kการเรียงสับเปลี่ยนของผู้พูด K คนπการจับคู่เอาต์พุตกับอ้างอิงหนึ่งแบบℓค่าสูญเสียการสร้างสัญญาณคืนต่อหนึ่งสัญญาณการแยกผู้พูดสองคนไม่มีใครเป็นลำดับแรกโดยธรรมชาติ PIT เลือกการจับคู่เอาต์พุตกับอ้างอิงที่ให้ค่าสูญเสียต่ำสุด เพื่อไม่ให้การเลขชาแนลสร้างสัญญาณกำกับดูแลที่ขัดแย้งกันเอง
SS 16K แยกผู้พูดออกจากกัน ส่วน SE 48K กับ SR 48K ซ่อมแซมสัญญาณเพียงสายเดียว การรวมกันในกระดานคะแนนเดียวย่อมปนกันทั้งงาน ย่านความถี่ และชุดข้อมูล
ติดตามบทความวิชาการ โค้ด และน้ำหนักโมเดลได้จาก ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K
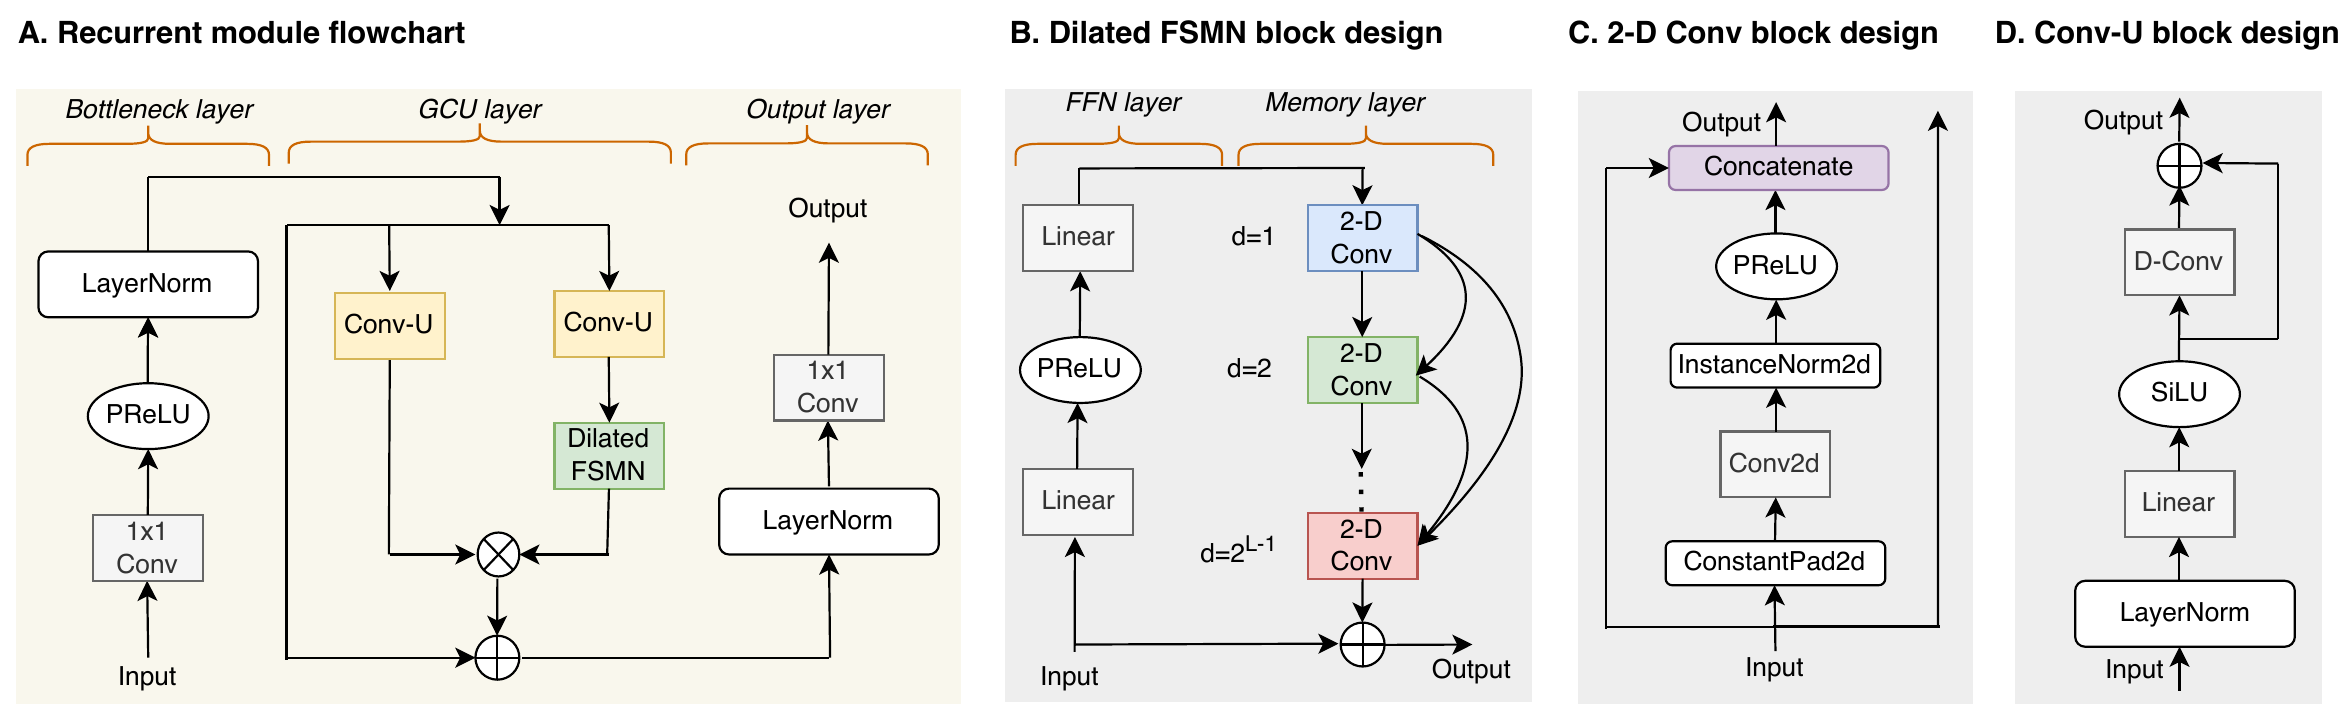
แต่ละแถวคงสถาปัตยกรรมต้นทาง มาตรวัด หรือนิยามงานของตนไว้ ผลลัพธ์ที่ไม่มีโปรโตคอลร่วมจึงยังแยกกันอยู่
| โมเดล | สถาปัตยกรรมหรือหลักฐาน | ขอบเขต |
|---|---|---|
| MossFormer2 SS 16K | การแยกผู้พูดที่พูดซ้อนทับกัน | เสียงเล็ดลอดข้ามช่อง การสลับตัวตน ช่วงเงียบ |
| MossFormer2 SE 48K | กรองเสียงรบกวนและลดเสียงสะท้อนแบบไวด์แบนด์ | ความเสียหายของพยัญชนะ การขจัดเสียงดนตรี หางเสียงของห้อง |
| TIGER-speech | โมเดลลำดับย่านความถี่ที่เน้นประสิทธิภาพ | วัดความหน่วงและคุณภาพบนไฟล์ชุดเดียวกัน |

กับงานแยกเสียง ให้ตรวจการสลับตัวตน เสียงพ่นพรืด เสียงหายใจ และหางเสียงสะท้อน การเพิ่มคุณภาพเสียงอาจลบพยัญชนะไปพร้อมกับเสียงแป้นพิมพ์หรือเสียงระบบปรับอากาศ ส่วนซูเปอร์เรโซลูชันต้องตัดสินในฐานะการขยายย่านความถี่ที่สมเหตุสมผล ไม่ใช่การกู้คืนตัวอย่างสัญญาณความถี่สูงดั้งเดิมทุกตัว
การฝึกแบบไม่ขึ้นกับการเรียงลำดับตัดเรื่องลำดับเอาต์พุตออกจากฟังก์ชันค่าสูญเสีย แต่ไม่ได้รับประกันความต่อเนื่องของตัวตนผู้พูดตลอดการประชุมยาว ให้บันทึกอัตราสุ่ม การสุ่มใหม่ และการยุบชาแนลลงไว้ก่อนการทดสอบ A/B แล้วตรวจการสลับผู้พูดทีละช่วงเวลา
มิกซ์แบบโมโนอาจไม่มีคำตอบเดียวเมื่อผู้พูดมีสีเสียงและระดับเสียงใกล้กัน และจำนวนแหล่งเสียงก็ไม่อาจอนุมานได้อย่างไร้ขีดจำกัด
การขยายย่านความถี่คือการสังเคราะห์เนื้อหาที่สมเหตุสมผล สำหรับงานนิติวิทยาศาสตร์ ไบโอเมทริกซ์ หรือการแพทย์ ความถี่สูงที่สร้างขึ้นไม่ใช่หลักฐานดั้งเดิม
ชื่อโมเดล ตัวเลข และข้อจำกัดทั้งหมดย้อนไปถึงบทความ รีพอซิทอรี หรือการ์ดโมเดลด้านล่าง