Model
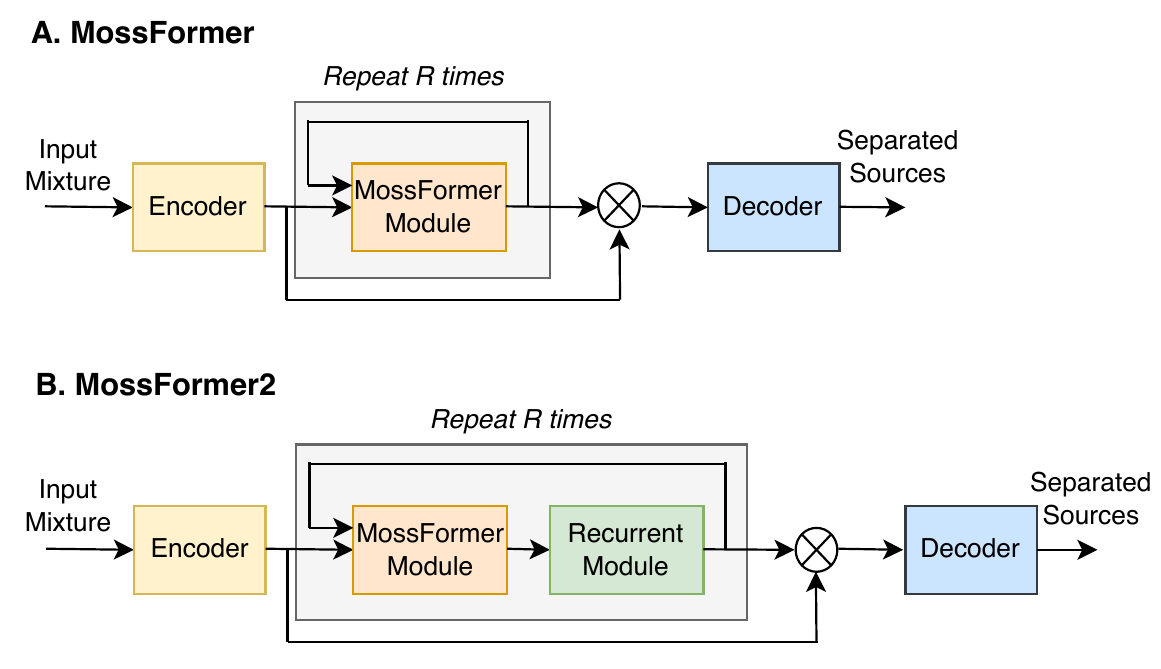
MossFormer2 i mowa TIGERa: trzy podziały zadań w interfejsie głosowym
Porównanie interfejsu/technologii Voice
Porównanie interfejsu/technologii Voice
FRONT-END MOWY
SS 16K szacuje, kto co powiedział. SE 48K szacuje czystszą wersję jednego mówcy. SR 48K rekonstruuje pasmo. Różnią się ich nadzór i kardynalność wyjść.
Wyjścia nie mają wrodzonej kolejności mówców: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS radzi sobie z ogólnym nakładaniem się głosów. TIGER-speech pozostawiono do zaszumionych, nasyconych echem i pogłosem nagrań dwóch osób.
Poprawa jakości daje jedną oczyszczoną falę; superrozdzielczość przewiduje brakujące informacje górnego pasma i może halucynować wiarygodne szczegóły. Ocena musi podawać częstotliwości próbkowania wejścia i wyjścia oraz oddzielnie wsłuchiwać się w szkody po odszumianiu i wymyśloną teksturę wysokich częstotliwości.
Front-endy mowy wyrosły w trzech rozłącznych środowiskach: separacja zebrań celuje w nakładające się głosy, poprawa jakości — w szum i pogłos, a superrozdzielczość — w brakujące pasmo. ClearerVoice-Studio umieszcza MossFormer2 SS 16K, SE 48K i rekonstrukcję pasma za jednym inżynierskim punktem wejścia, lecz ich cele i kontrakty wyjść pozostają różne.
TIGER-speech stosuje modelowanie sekwencji z uwzględnieniem pasm, by obniżyć koszt długiego kontekstu. To porównanie efektywności, a nie zamiennik MossFormer2 pod nowym numerem wersji. Wdrożenie zaczyna się od rozstrzygnięcia, czy nagranie zawiera nakładających się mówców, zamaskowaną mowę czy brakujące pasmo; błędnie wybrane zadanie daje dopracowaną odpowiedź na niewłaściwe pytanie.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kpermutacje K mówcówπjedno przypisanie wyjście/referencjaℓstrata rekonstrukcji pojedynczego sygnałuSeparacja dwóch mówców nie ma naturalnego pierwszego mówcy. PIT wybiera przypisanie wyjść do referencji o najniższej stracie, by numeracja kanałów nie tworzyła sprzecznego nadzoru.
SS 16K separuje mówców; SE 48K i SR 48K naprawiają jeden sygnał. Wspólny ranking mieszałby zadanie, pasmo i zbiory danych.
Pracę, kod i wagi można prześledzić przez ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
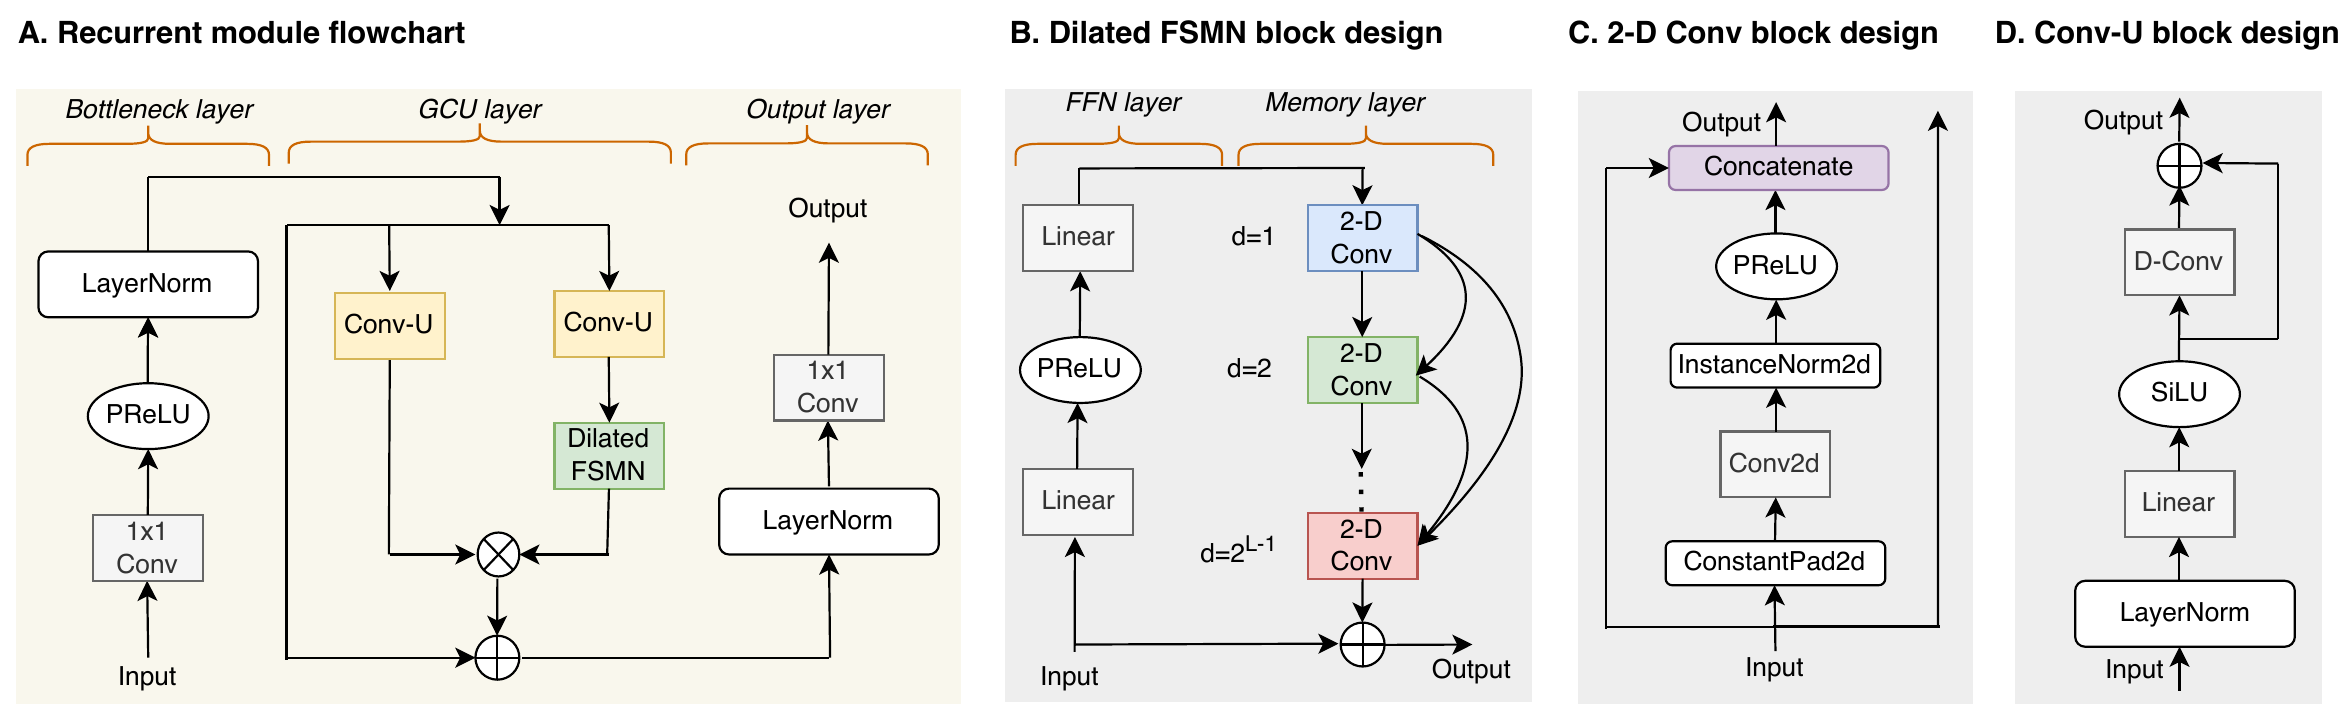
Każdy wiersz zachowuje własną architekturę źródłową, metrykę lub definicję zadania; wyniki bez wspólnego protokołu pozostają rozdzielne.
| Model | Architektura lub dowód | Zakres |
|---|---|---|
| MossFormer2 SS 16K | separacja nakładających się mówców | przesłuchy, zamiany tożsamości, obszary ciszy |
| MossFormer2 SE 48K | szerokopasmowe odszumianie i usuwanie pogłosu | uszkodzenia spółgłosek, usuwanie muzyki, ogony pomieszczenia |
| TIGER-speech | pasmowy model sekwencji nastawiony na efektywność | pomiar opóźnienia i jakości na tych samych plikach |

Przy separacji sprawdzaj zamiany tożsamości, sybilanty, oddechy i ogony pogłosu. Poprawa jakości może usuwać spółgłoski razem z szumem klawiatury lub HVAC. Superrozdzielczość należy oceniać jako wiarygodne rozszerzenie pasma, a nie odzysk każdej oryginalnej próbki wysokich częstotliwości.
Trening niezmienniczy na permutacje usuwa kolejność wyjść z funkcji straty, lecz nie gwarantuje ciągłości tożsamości na przestrzeni długiego zebrania. Przed odsłuchami A/B notuj częstotliwość próbkowania, repróbkowanie i zwijanie kanałów, a zamiany mówców kontroluj segmentami czasu.
Mieszanka mono może nie mieć jednoznacznego rozwiązania, gdy mówcy mają podobną barwę i wysokość głosu, a liczby źródeł nie można wywnioskować bez ograniczeń.
Rozszerzanie pasma syntetyzuje wiarygodną treść. W zastosowaniach kryminalistycznych, biometrycznych i medycznych wygenerowane wysokie częstotliwości nie są oryginalnym dowodem.
Nazwy modeli, liczby i ograniczenia prowadzą do poniższych prac, repozytoriów lub kart modeli.