Modello
MossFormer2 e TIGER-speech: tre divisioni di compiti nel front-end vocale
Front-end vocale/Confronto tecnologie
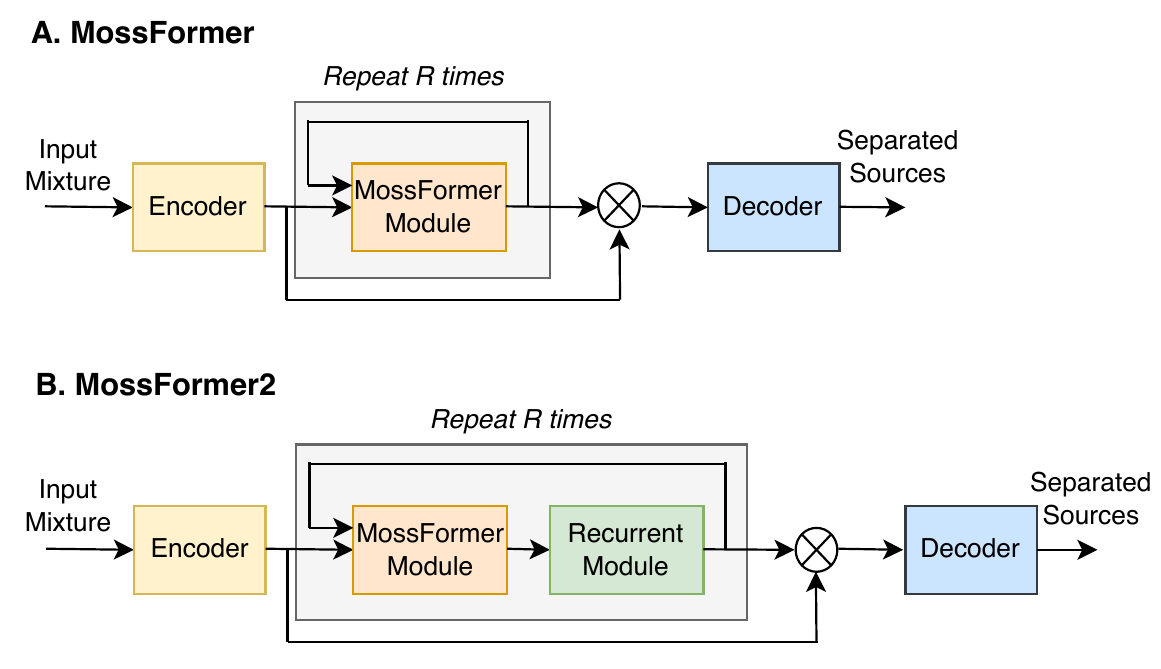
Front-end vocale/Confronto tecnologie
FRONT END VOCALE
SS 16K stima chi ha detto cosa. SE 48K stima una versione più pulita di un solo parlante. SR 48K ricostruisce la larghezza di banda. La supervisione e la cardinalità dell'output sono diverse.
Gli output non hanno un ordine intrinseco dei parlanti: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS gestisce la sovrapposizione generale. TIGER-speech resta disponibile per registrazioni a due persone rumorose, con eco e riverbero.
Il miglioramento produce un'unica forma d'onda ripulita; la super-risoluzione predice l'informazione mancante nella banda alta e può allucinare dettagli plausibili. La valutazione deve dichiarare le frequenze di campionamento di input e output e ascoltare separatamente i danni da denoising e la tessitura ad alta frequenza inventata.
I front end vocali sono cresciuti in tre comunità distinte: la separazione per le riunioni punta alla sovrapposizione, il miglioramento punta a rumore e riverbero, la super-risoluzione punta alla banda mancante. ClearerVoice-Studio colloca MossFormer2 SS 16K, SE 48K e il ripristino della banda dietro un unico punto d'ingresso ingegneristico, ma i loro obiettivi e i contratti di output restano diversi.
TIGER-speech applica una modellazione di sequenza consapevole delle bande per ridurre il costo dei contesti lunghi. È un confronto di efficienza, non una sostituzione di MossFormer2 per numero di versione. Il deployment inizia decidendo se la registrazione contiene parlanti sovrapposti, parlato mascherato o banda mancante; il compito sbagliato produce una risposta raffinata alla domanda sbagliata.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kpermutazioni di K parlantiπun'assegnazione output/riferimentoℓperdita di ricostruzione del singolo segnaleLa separazione di due parlanti non ha un primo parlante naturale. PIT sceglie l'assegnazione output/riferimento con la perdita più bassa, così la numerazione dei canali non crea supervisione contraddittoria.
SS 16K separa i parlanti; SE 48K e SR 48K riparano un segnale. Una classifica condivisa mescolerebbe compito, larghezza di banda e dataset.
Paper, codice e pesi si possono seguire tramite ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
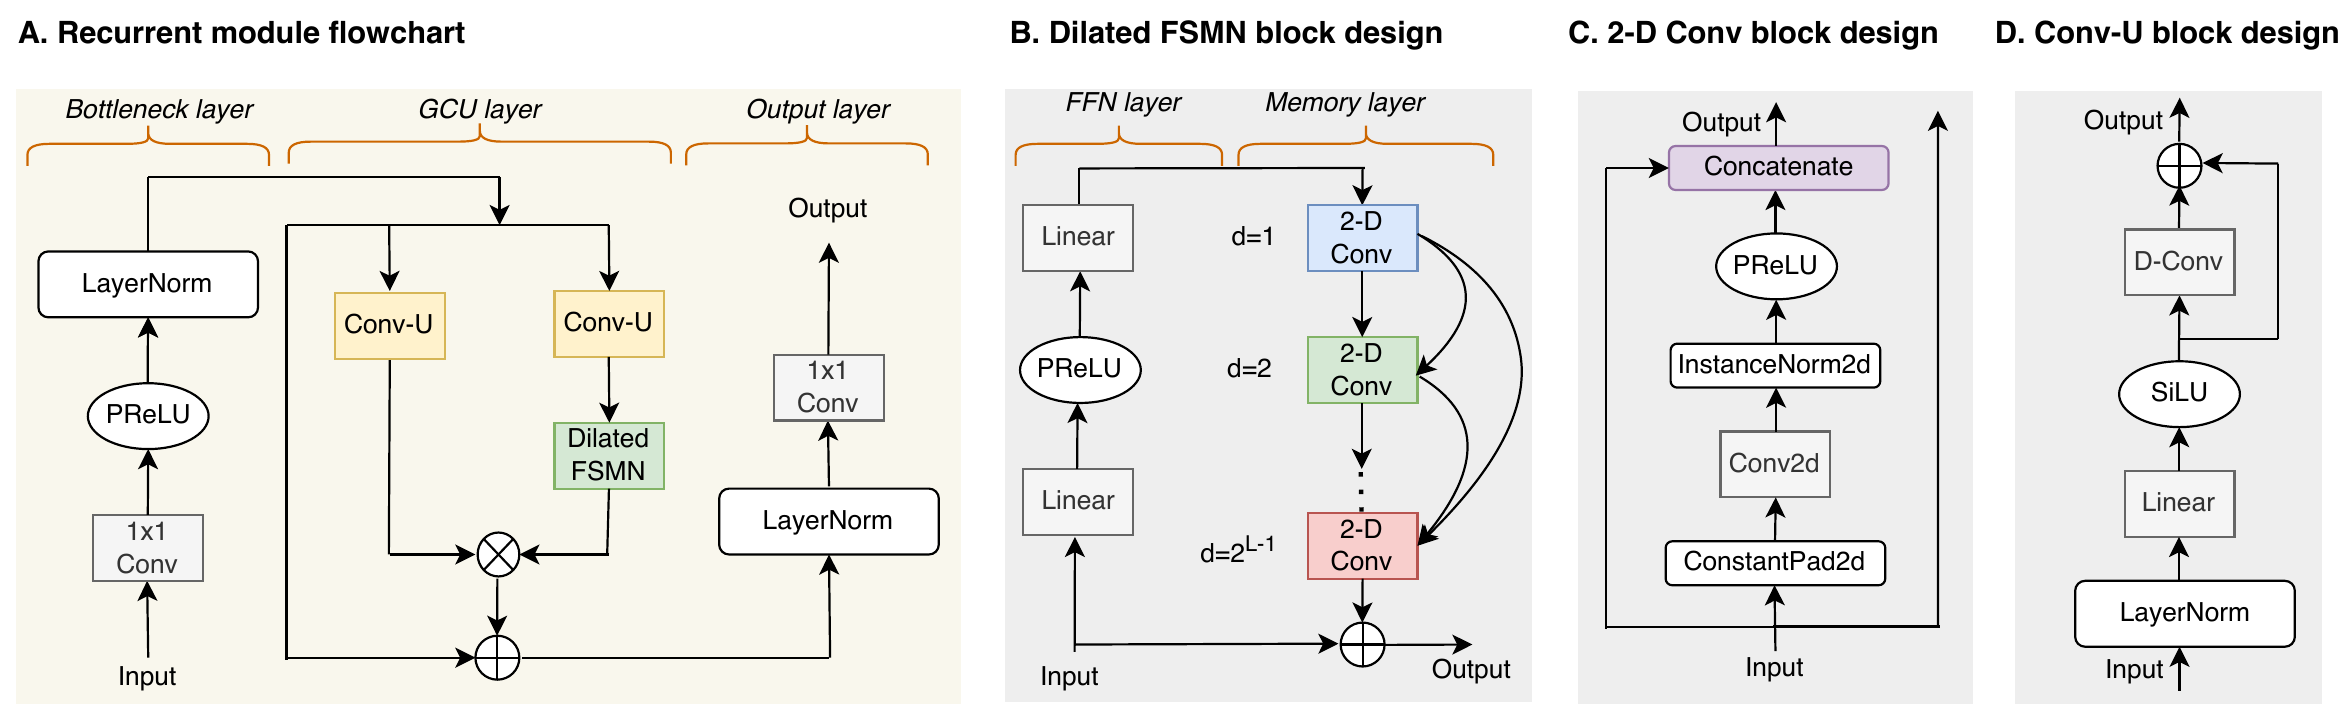
Ogni riga conserva la propria architettura sorgente, metrica o definizione di compito; i risultati senza un protocollo condiviso restano separati.
| Modello | Architettura o evidenza | Ambito |
|---|---|---|
| MossFormer2 SS 16K | separazione di parlanti sovrapposti | diafonia, scambi di identità, regioni silenziose |
| MossFormer2 SE 48K | denoise e derverbero a banda larga | danni alle consonanti, rimozione della musica, code della stanza |
| TIGER-speech | modello di sequenza a bande orientato all'efficienza | misurare latenza e qualità sugli stessi file |

Per la separazione, controlla scambi di identità, sibilanti, respiri e code di riverbero. Il miglioramento può rimuovere le consonanti insieme al rumore della tastiera o dell'HVAC. La super-risoluzione va giudicata come estensione plausibile della banda, non come recupero di ogni campione originale ad alta frequenza.
L'addestramento invariante alla permutazione rimuove l'ordinamento degli output dalla perdita, ma non garantisce la continuità d'identità in una riunione lunga. Registra frequenza di campionamento, ricampionamento e ripiegamento dei canali prima delle prove A/B, e ispeziona gli scambi di parlante segmento per segmento.
Una miscela mono può non avere una soluzione unica quando i parlanti hanno timbro e intonazione simili, e il numero di sorgenti non si può dedurre senza limite.
L'estensione di banda sintetizza contenuto plausibile. Per uso forense, biometrico o medico, le alte frequenze generate non sono evidenza originale.
Nomi dei modelli, numeri e limitazioni riconducono ai paper, ai repository o alle schede modello qui sotto.