Modell
MossFormer2 og TIGER-tale: tre oppgavedelinger i talefronten
Voice front-end / teknologi sammenligning
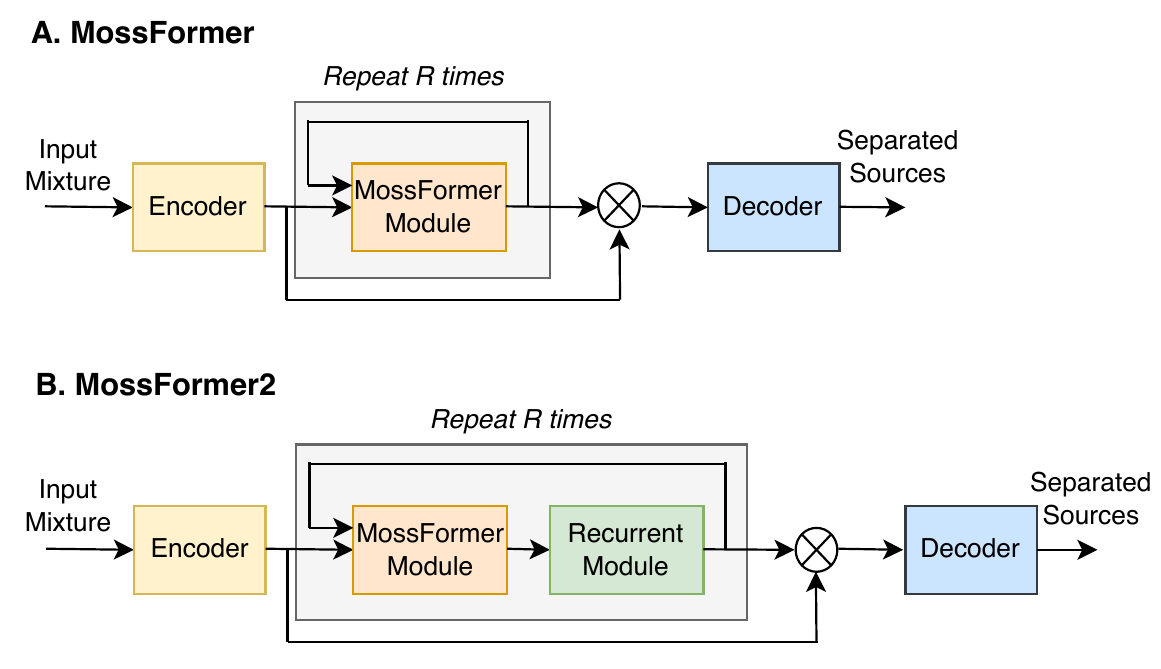
Voice front-end / teknologi sammenligning
FRONTEND FOR TALE
SS 16K estimerer hvem som sa hva. SE 48K estimerer en renere versjon av én taler. SR 48K rekonstruerer båndbredde. Overvåkningen deres og antall utganger er forskjellige.
Utgangene har ingen iboende talerrekkefølge: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS håndterer generell overlapp. TIGER-speech beholdes for støyete, ekkopreget og romklangmettede to-personsopptak.
Talforbedring produserer én renset bølgeform; superoppløsning predikerer manglende informasjon i øvre bånd og kan hallusinere troverdige detaljer. Evaluering må oppgi samplingsfrekvens for inndata og utdata, og lytte separat etter skader fra støyfjerning og oppdiktet høyfrekvent tekstur.
Tale-frontender vokste frem i tre adskilte miljøer: møteseparasjon tar sikte på overlapp, talforbedring på støy og romklang, og superoppløsning på manglende båndbredde. ClearerVoice-Studio samler MossFormer2 SS 16K, SE 48K og båndbredde-restaurering bak ett teknisk inngangspunkt, men målene og utgangskontraktene deres er fortsatt forskjellige.
TIGER-speech bruker båndbevisst sekvensmodellering for å redusere kostnaden ved lange kontekster. Det er en effektivitetssammenligning, ikke en erstatning med nytt versjonsnummer for MossFormer2. I drift starter man med å avgjøre om opptaket inneholder overlappende talere, maskert tale eller manglende båndbredde; feil oppgave gir et polert svar på feil spørsmål.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_Kpermutasjoner av K talereπén tildeling mellom utgang og referanseℓrekonstruksjonstap for ett enkelt signalSeparasjon av to talere har ingen naturlig første taler. PIT velger den tildelingen mellom utgang og referanse som gir lavest tap, slik at kanalnummerering ikke skaper motstridende overvåkning.
SS 16K skiller talere; SE 48K og SR 48K reparerer ett signal. En felles resultatliste ville blandet oppgave, båndbredde og datasett.
Artikkel, kode og vekter kan følges via ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K.
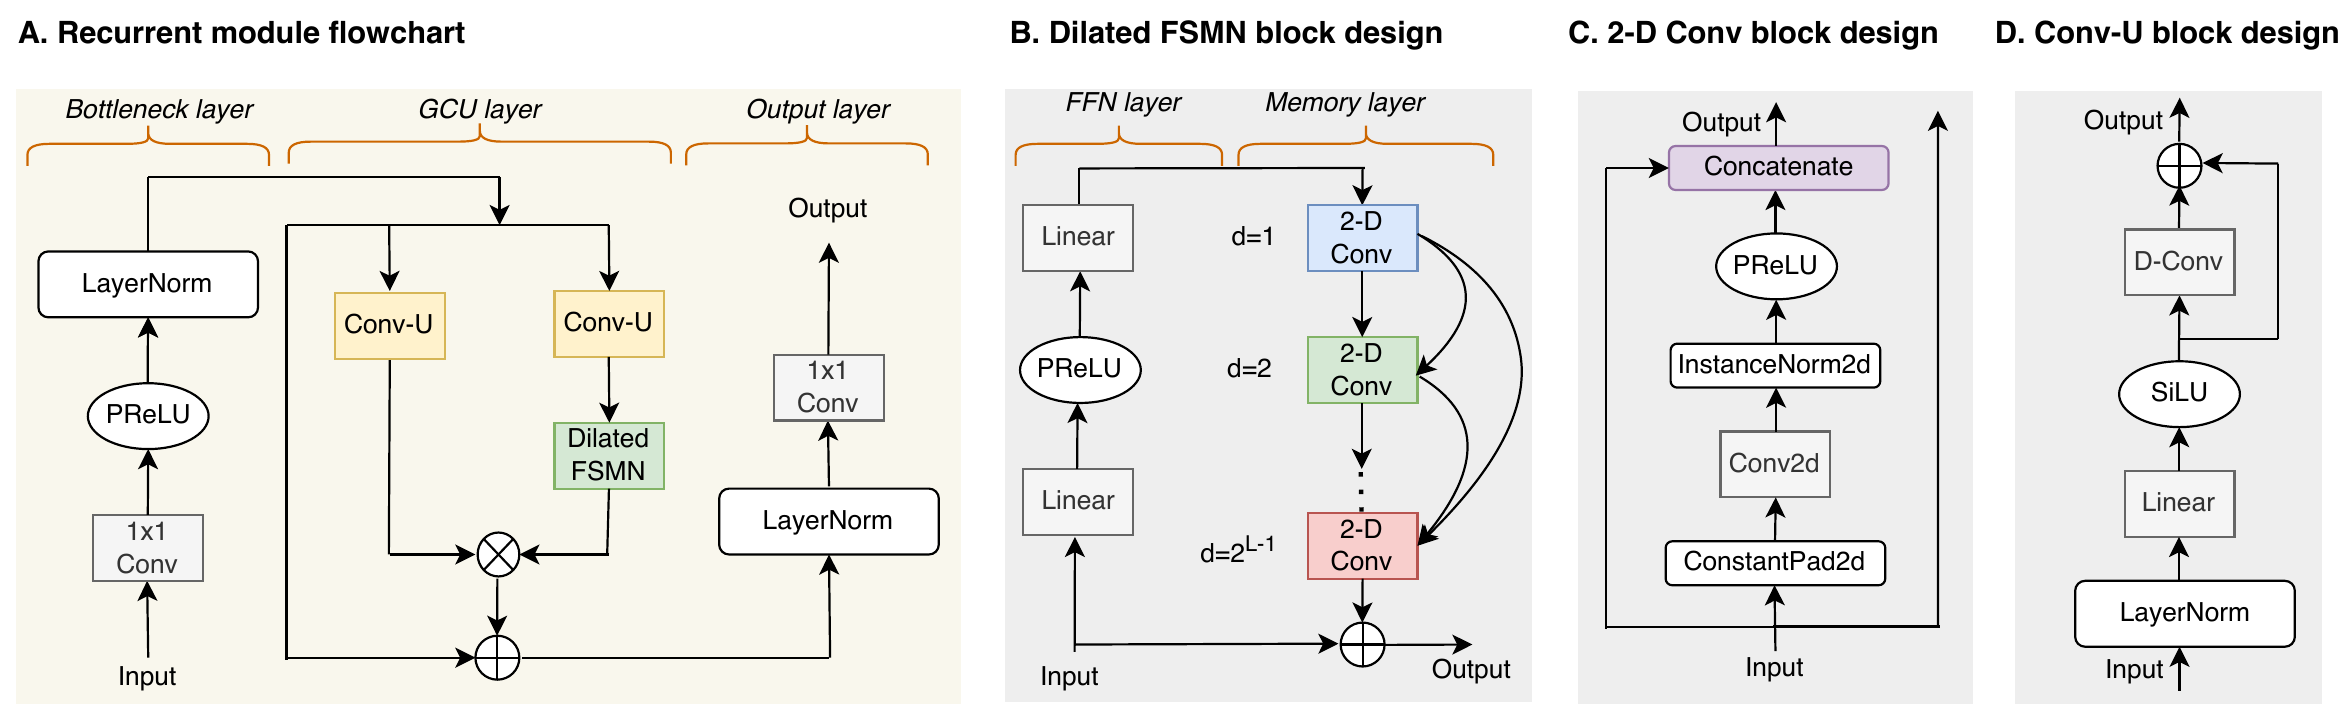
Hver rad beholder sin kildearkitektur, metrikk eller oppgavedefinisjon; resultater uten felles protokoll forblir adskilte.
| Modell | Arkitektur eller evidens | Omfang |
|---|---|---|
| MossFormer2 SS 16K | separasjon av overlappende talere | oversnakk, identitetsbytter, stille partier |
| MossFormer2 SE 48K | bredbåndsstøyfjerning og romklangfjerning | konsonantskader, fjernet musikk, romklanghaler |
| TIGER-speech | effektivitetsorientert båndsekvensmodell | mål latenstid og kvalitet på de samme filene |

Ved separasjon bør man kontrollere identitetsbytter, s-lyder, pust og romklanghaler. Talforbedring kan fjerne konsonanter sammen med tastatur- eller ventilasjonsstøy. Superoppløsning må bedømmes som troverdig båndbreddeutvidelse, ikke som gjenoppretting av hvert eneste opprinnelige høyfrekvenssample.
Permutasjonsinvariant trening fjerner utgangsrekkefølgen fra tapfunksjonen, men garanterer ikke identitetskontinuitet gjennom et langt møte. Noter samplingsfrekvens, omsampling og kanalnedblanding før A/B-kjøringer, og inspiser talerbytter per tidssegment.
En monoblanding kan mangle en entydig løsning når talerne har lignende klang og tonehøyde, og antall kilder kan ikke utledes uten grenser.
Båndbreddeutvidelse syntetiserer troverdig innhold. Ved rettsmedisinsk, biometrisk eller medisinsk bruk er genererte høyfrekvenser ikke opprinnelig bevismateriale.
Modellnavn, tall og begrensninger kan spores til artiklene, kodebasene eller modellkortene nedenfor.