Modell
MossFormer2 und TIGER-Speech: drei Aufgabenteilungen im Sprach-Frontend
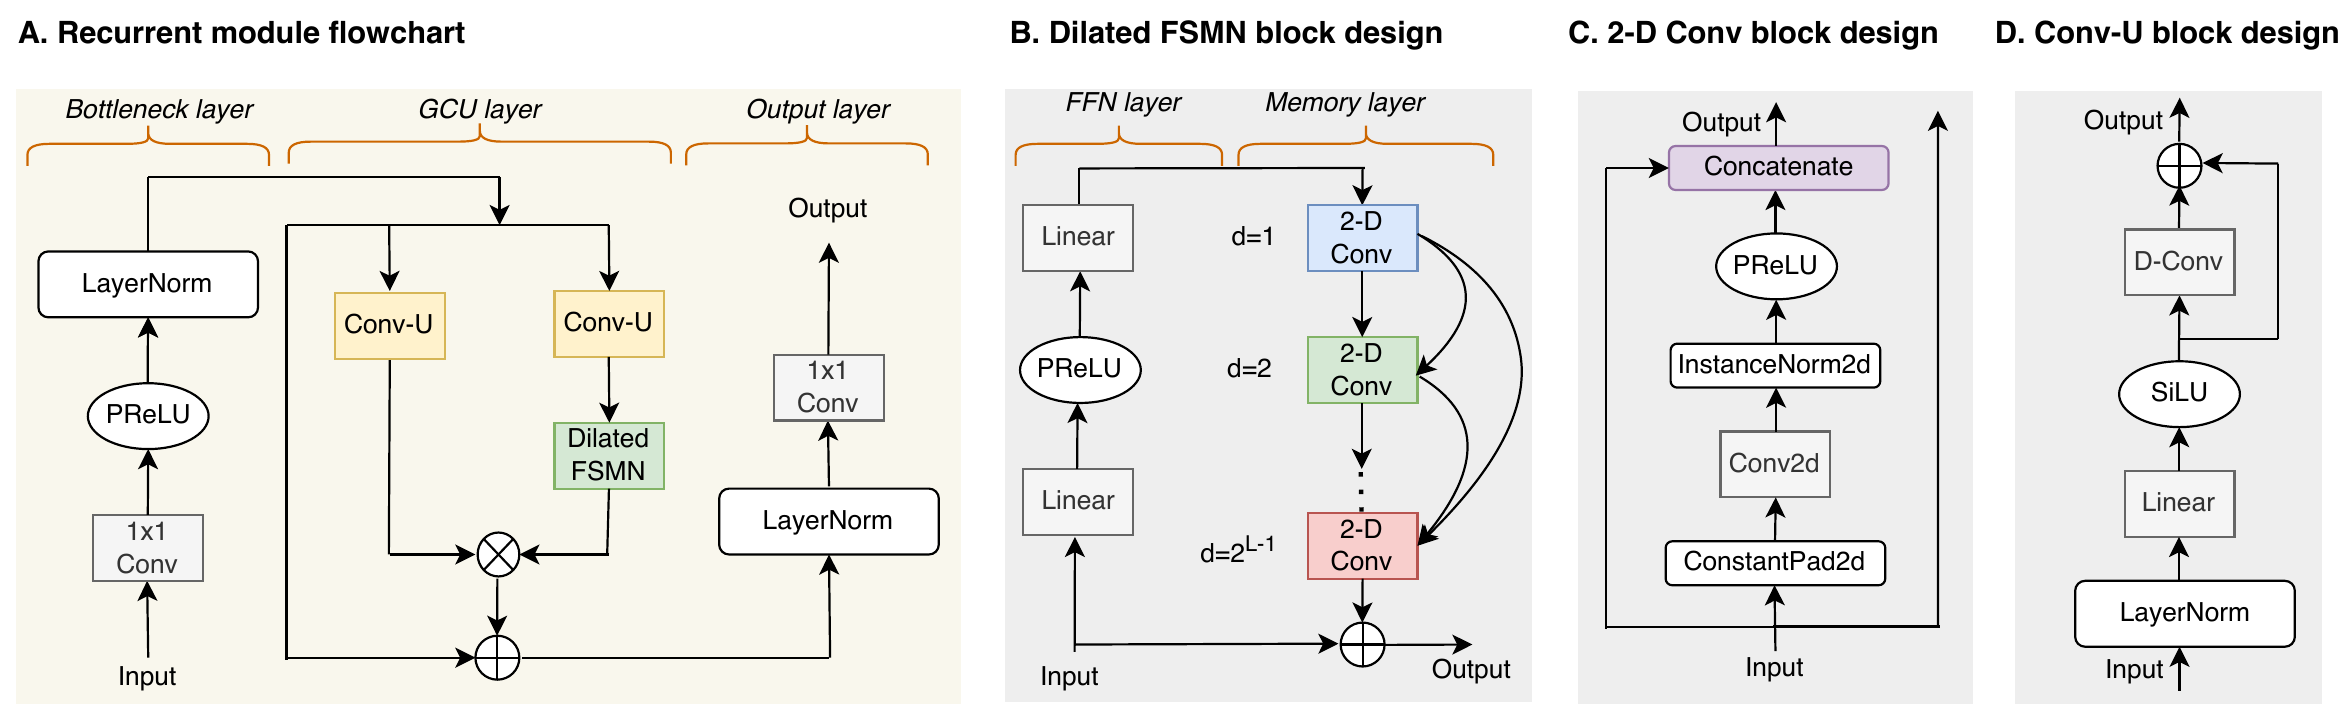
Voice-Frontend-/Technologie-Vergleich Offizielle Details zum Schleifenmodul
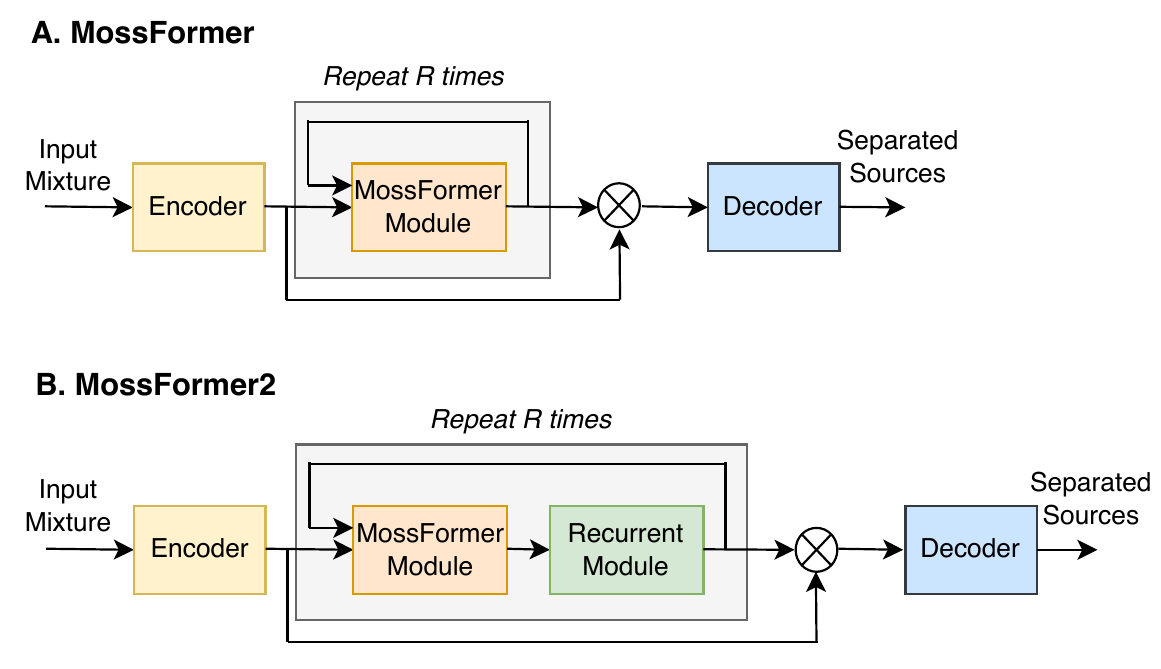
Voice-Frontend-/Technologie-Vergleich Offizielle Details zum Schleifenmodul
© 2026 TelkNet. Alle Rechte vorbehalten.
SPRACH-FRONTEND
SS 16K schätzt, wer was gesagt hat. SE 48K schätzt eine sauberere Version eines einzelnen Sprechers. SR 48K rekonstruiert Bandbreite. Ihre Supervision und die Anzahl ihrer Ausgaben unterscheiden sich grundlegend.
Ausgaben haben keine intrinsische Sprecherreihenfolge: L_PIT=min_{π∈S_K}Σ_k L(ŝ_k,s_{π(k)}). MossFormer2 SS bewältigt allgemeine Überlappung. TIGER-speech bleibt für verrauschte, echo- und hallbehaftete Zweipersonenaufnahmen vorgesehen.
Enhancement erzeugt eine bereinigte Wellenform; Superauflösung sagt fehlende Informationen im oberen Frequenzband voraus und kann plausibel wirkende Details halluzinieren. Eine Bewertung muss Eingangs- und Ausgangsabtastrate angeben und getrennt auf Schäden durch Entrauschung und auf erfundene Hochfrequenztextur hören.
Sprach-Frontends entstanden in drei getrennten Communities: Meeting-Separation zielt auf Überlappung, Enhancement auf Rauschen und Hall, Superauflösung auf fehlende Bandbreite. ClearerVoice-Studio bündelt MossFormer2 SS 16K, SE 48K und Bandbreitenrestauration hinter einem einzigen Engineering-Einstiegspunkt, doch ihre Zielsetzungen und Ausgabeverträge bleiben unterschiedlich.
TIGER-speech nutzt bandbewusste Sequenzmodellierung, um die Kosten langer Kontexte zu senken. Es ist ein Effizienzvergleich, kein Ersatz mit neuer Versionsnummer für MossFormer2. Der Einsatz beginnt mit der Entscheidung, ob die Aufnahme überlappende Sprecher, verdeckte Sprache oder fehlende Bandbreite enthält; die falsche Aufgabe liefert eine polierte Antwort auf die falsche Frage.
L_PIT=min_{π∈S_K} Σ_k ℓ(ŝ_k,s_{π(k)})S_KPermutationen von K Sprechernπeine Ausgabe/Referenz-ZuordnungℓRekonstruktionsverlust eines EinzelsignalsZweisprecher-Separation kennt keinen natürlichen ersten Sprecher. PIT wählt die Ausgabe/Referenz-Zuordnung mit dem geringsten Verlust, damit die Kanalnummerierung keine widersprüchliche Supervision erzeugt.
SS 16K trennt Sprecher; SE 48K und SR 48K reparieren ein einzelnes Signal. Eine gemeinsame Bestenliste würde Aufgabe, Bandbreite und Datensätze vermischen.
Paper, Code und Gewichte lassen sich über ClearerVoice-Studio / MossFormer2 SS 16K / MossFormer2 SE 48K nachverfolgen.
Jede Zeile behält ihre Quellarchitektur, Metrik oder Aufgabendefinition; Ergebnisse ohne gemeinsames Protokoll bleiben getrennt.
| Modell | Architektur oder Evidenz | Geltungsbereich |
|---|---|---|
| MossFormer2 SS 16K | Separation überlappender Sprecher | Übersprechen, Identitätswechsel, stille Bereiche |
| MossFormer2 SE 48K | Breitband-Entrauschung und Enthallung | Konsonantenschäden, Musikentfernung, Raumnachhall |
| TIGER-speech | effizienzorientiertes Band-Sequenzmodell | Latenz und Qualität an denselben Dateien messen |

Bei der Separation Identitätswechsel, Zischlaute, Atem und Hallfahnen prüfen. Enhancement kann Konsonanten zusammen mit Tastatur- oder Lüftungsrauschen entfernen. Superauflösung ist als plausible Bandbreitenerweiterung zu beurteilen, nicht als Wiederherstellung jedes ursprünglichen Hochfrequenzsamples.
Permutationsinvariantes Training entfernt die Ausgabereihenfolge aus dem Verlust, garantiert aber keine Identitätskontinuität über eine lange Sitzung. Abtastrate, Resampling und Kanal-Fold-down vor A/B-Läufen dokumentieren und Sprecherwechsel zeitsegmentweise untersuchen.
Eine Mono-Mischung kann keine eindeutige Lösung haben, wenn Sprecher eine ähnliche Stimmfarbe und Tonhöhe besitzen, und die Quellenzahl lässt sich nicht unbegrenzt ableiten.
Bandbreitenerweiterung synthetisiert plausiblen Inhalt. Für forensische, biometrische oder medizinische Zwecke sind erzeugte Hochfrequenzen kein Originalbeleg.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die untenstehenden Papers, Repositories oder Modellkarten zurückführen.