Google Magenta RealTime 2:即時音樂模型從「生成器」走向「可演奏樂器」
以來源可核對的技術解析方式整理 MRT2 的 40ms 幀級自回歸、低延遲 MIDI/文字/音訊控制、2.4B/230M 雙模型結構、SpectroStream codec 路徑、MusicCoCa 風格嵌入與即時演奏邊界。
技術解析 / Google Magenta
目前許多神經音樂生成系統仍採用「批次算圖」:使用者輸入提示詞,伺服器離線運算數十秒,最後傳回一段已經定型的音訊。這種方式適合快速取得草稿,卻切斷了創作者與模型之間的即時回饋。實際演奏時,按和弦、推動濾波器、改變節奏等動作會連續發生,伴奏也必須跟著手勢轉向。
Magenta RealTime 2(MRT2)正是朝這個方向推進的開放權重模型。Google Magenta 將它定義為面向 on-device streaming generation 的 live music model:它能在低延遲控制下持續生成音樂音訊,並同時接收文字提示、音訊風格範例與 MIDI 輸入。相較前一代,官方發布頁列出的核心改變非常明確:模型影格長度從 2 秒降至 40ms,控制延遲約 200ms,並透過 frame-level autoregression 與 frame-aligned conditioning,讓音樂生成從「區塊級生成」進入「影格級控制」。
這條神經音訊管線可拆解成四個關鍵問題:SpectroStream 如何將 48kHz stereo 音訊壓縮為可預測的 tokens,MusicCoCa 如何把文字與音訊風格放進共同嵌入空間,Decoder-only Transformer 如何在每個 40ms codec frame 中融合歷史音訊、MIDI 狀態與風格條件,以及 causal sliding window attention 如何讓持續生成在記憶體用量與延遲上維持可控。
1. 從批次算圖走向即時神經樂器
MRT2 承接兩條已經成形的路線:研究端的 Magenta RealTime,以及雲端互動產品 Lyria RealTime API。前一代已證明音樂模型可以持續生成並接受風格控制,但仍以約 2 秒的音訊區塊進行 chunk-wise autoregression。模型先累積完整區塊的上下文,再輸出下一段聲音;當演奏者按下 MIDI 鍵、改變風格提示,或換入新的音訊參考時,控制訊號必須等到目前區塊結束後才能被聽見。
MRT2 沒有推翻 SpectroStream 與 MusicCoCa 的基礎,改變主要集中在生成主幹與控制粒度。Decoder-only Transformer 改採 frame-wise autoregression,每個 SpectroStream frame 只有 40ms;模型生成每個影格時,都會重新讀取 MIDI、風格 embedding 與歷史音訊 tokens。控制延遲從前一代約 3 秒縮短至約 200ms,並非單靠一句「模型更快」就能概括;關鍵在於控制訊號從每兩秒才進入系統一次,變成每 40ms 都有機會改變下一個影格。
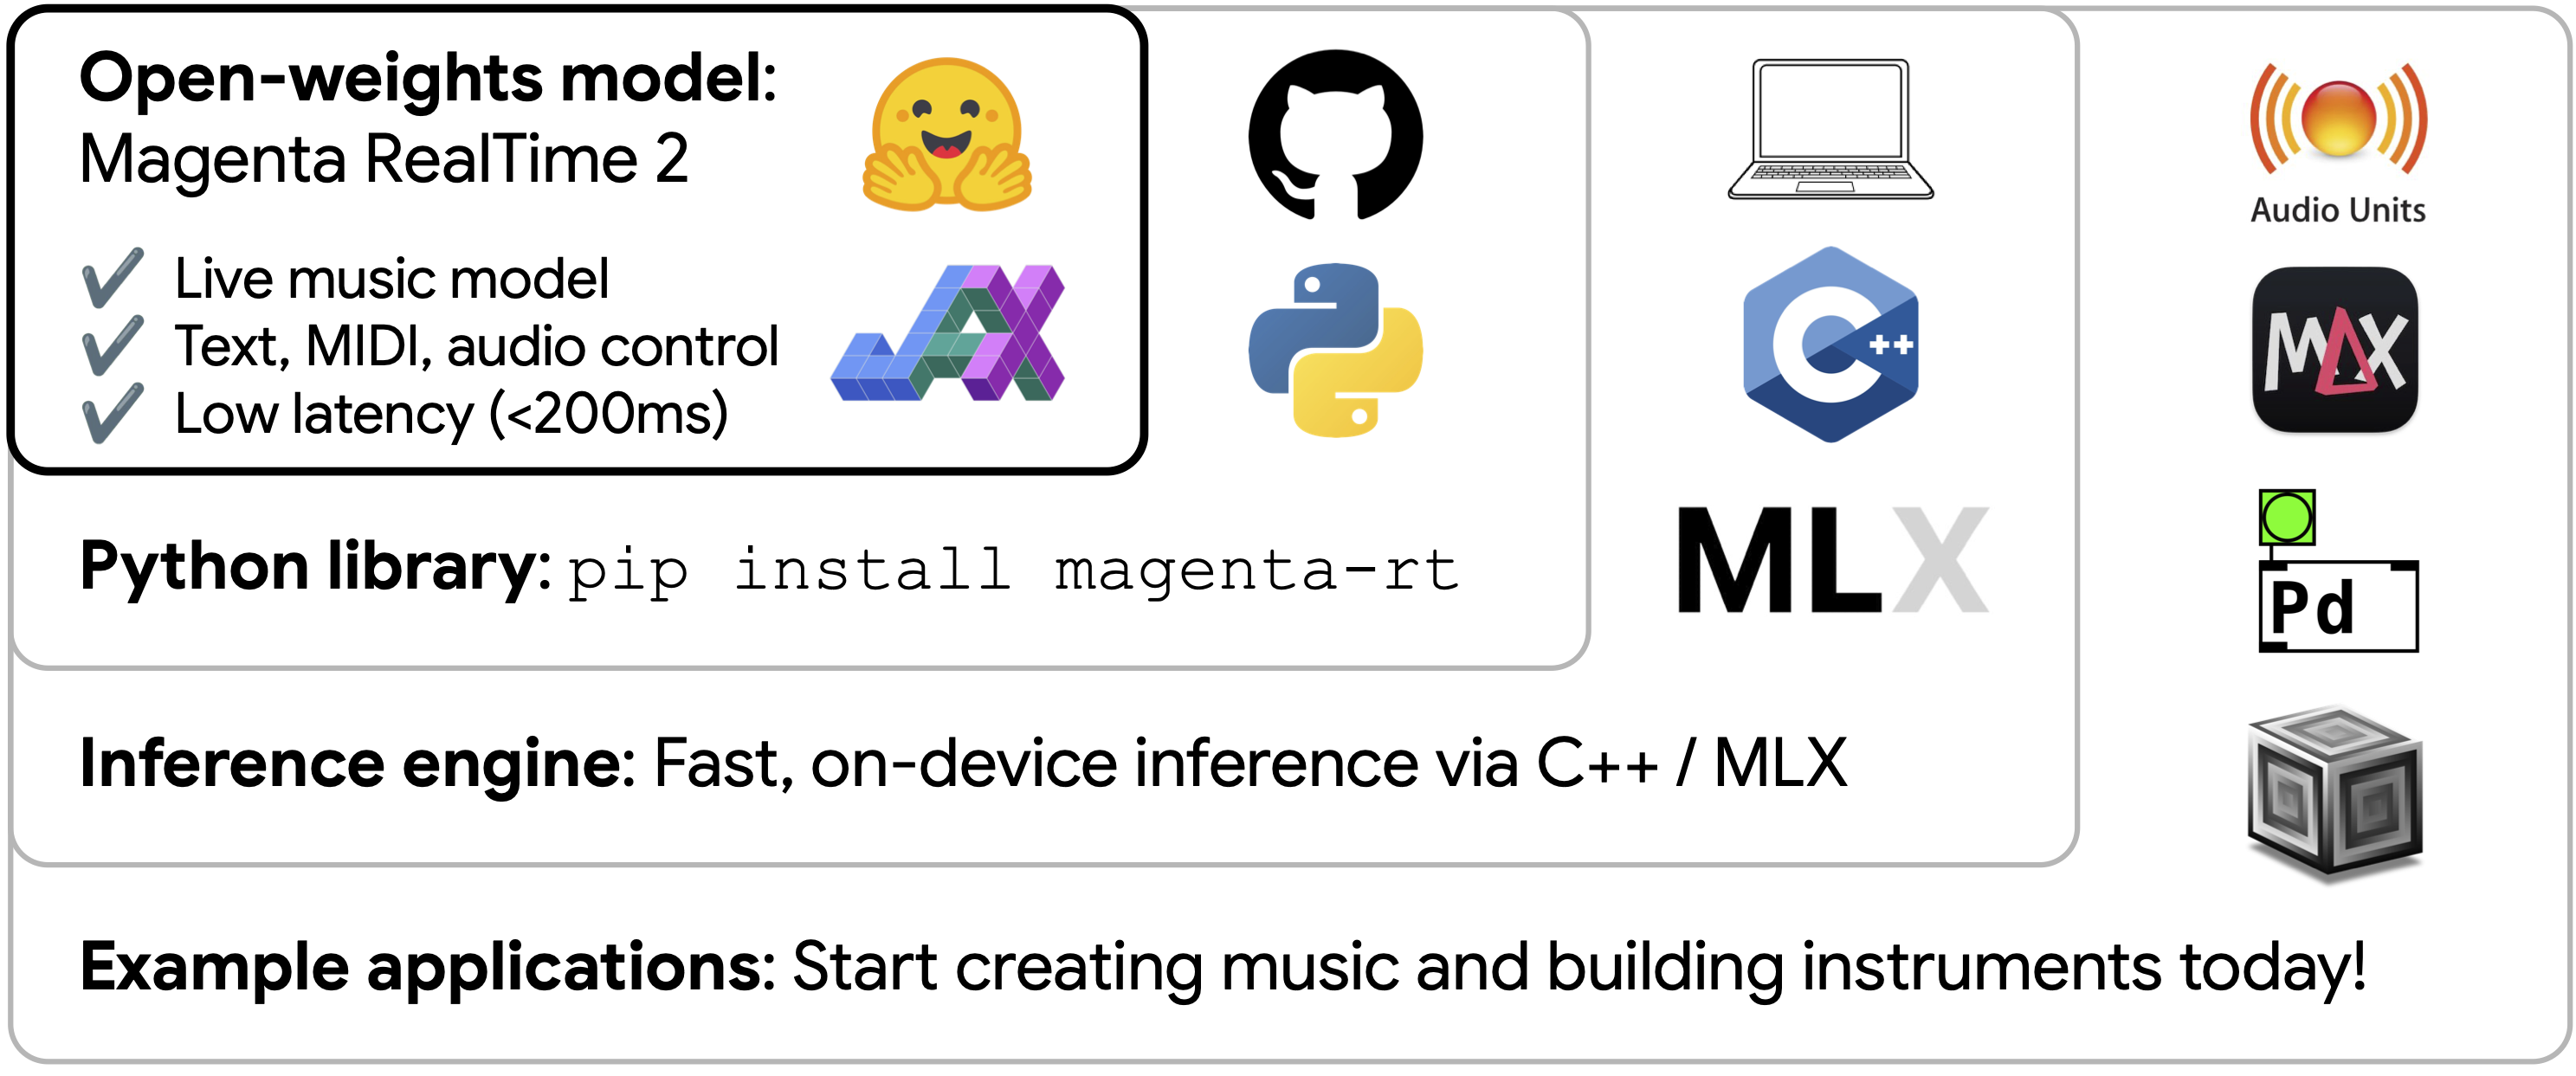
這次世代更新也把雲端展示與本機工具分開。Lyria RealTime API 展示託管式即時生成,MRT2 則公開權重、Python 推論函式庫、MLX C++ 引擎、DAW 外掛與獨立應用程式範例。音樂人面對的不再只是一個持續輸出音訊的服務介面,還能將模型嵌入自己的宿主程式、控制器與現場系統。
2. 時頻基礎:三者協作的神經音訊管線
MRT2 由三個核心元件組成:SpectroStream、MusicCoCa 與 Decoder-only Transformer LLM。SpectroStream 負責將高傳真音樂音訊轉成離散 tokens;MusicCoCa 負責把文字描述與音訊範例映射到共同的風格空間;LLM 則依據歷史音訊 tokens、MusicCoCa 風格 tokens 與 MIDI tokens,生成下一個影格的音訊 tokens。這套組合讓 MRT2 能同時接收文字、音訊與 MIDI,而不是只圍繞單一 prompt 運作。
2.1 SpectroStream:高傳真離散音訊編解碼器
SpectroStream 是 MRT2 的聲學基礎。官方模型卡指出,它將 48kHz stereo 音樂音訊轉成離散 tokens:25Hz frame rate、64 RVQ depth、10 bit codes、16kbps。這種壓縮表示法把原始波形中龐大的連續取樣點,轉成結構化的 token 序列,讓 Transformer 面對的是「音樂語言」,而不是直接預測每個取樣點。
2.2 MusicCoCa:文字與音訊風格的共同潛在空間
MusicCoCa 是透過對比學習訓練的風格表徵模型。它可以接收 16kHz mono 音樂音訊,也能接收「heavy metal」「disco funk」這類文字風格描述,並輸出 768 維 embedding;這個 embedding 會被量化為 12 層 RVQ、10 bit codes,作為全域風格條件輸入生成主幹。換句話說,MRT2 的風格不只來自文字,也可以取自一段參考音訊。
2.3 Decoder-only Transformer 主網路
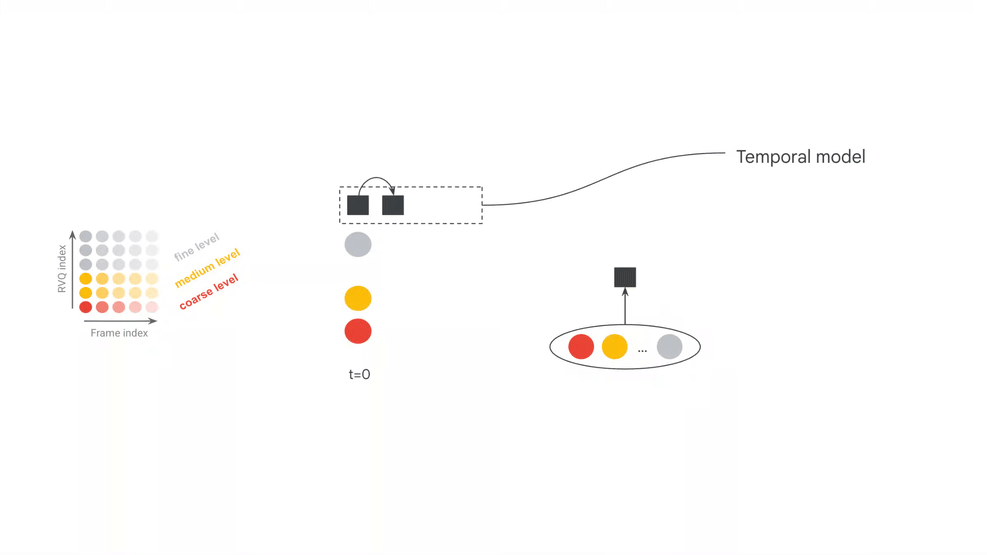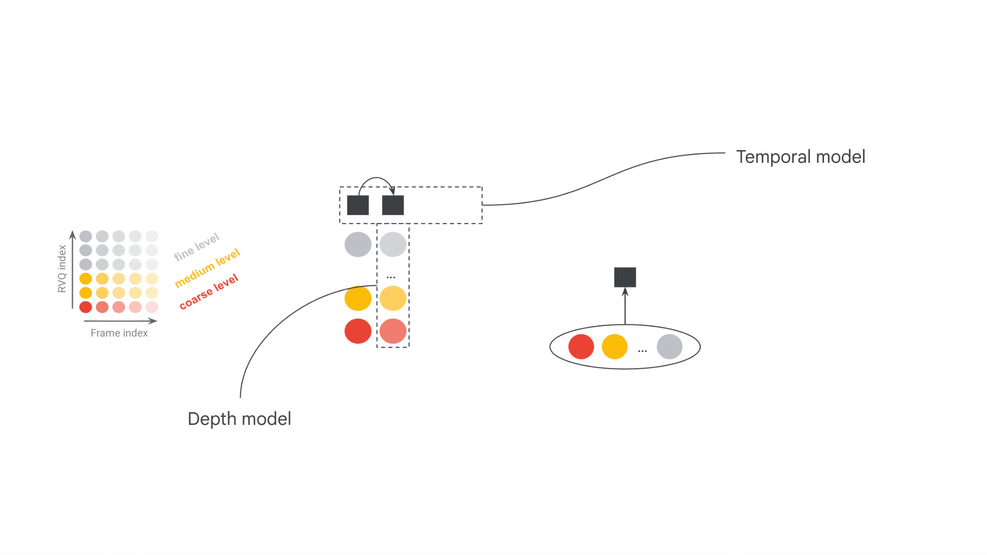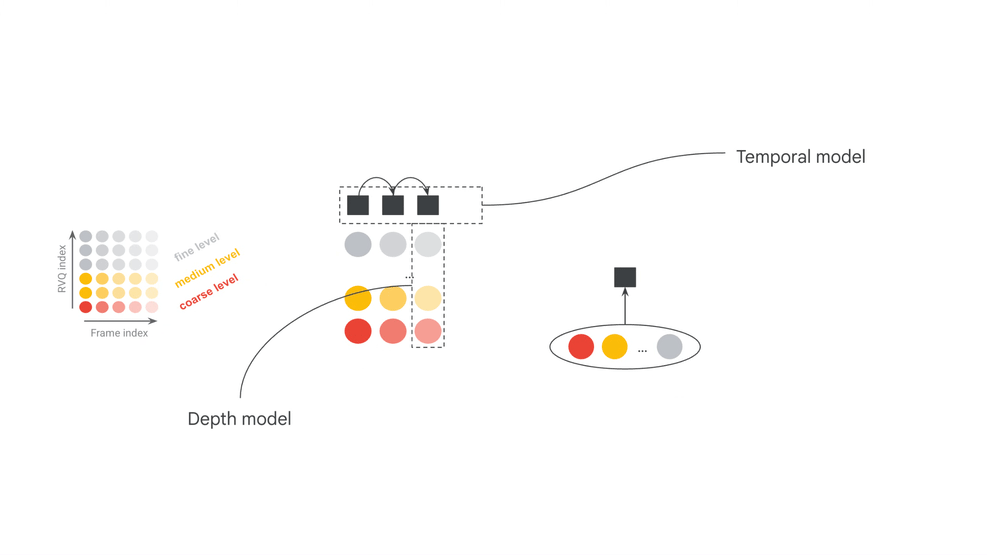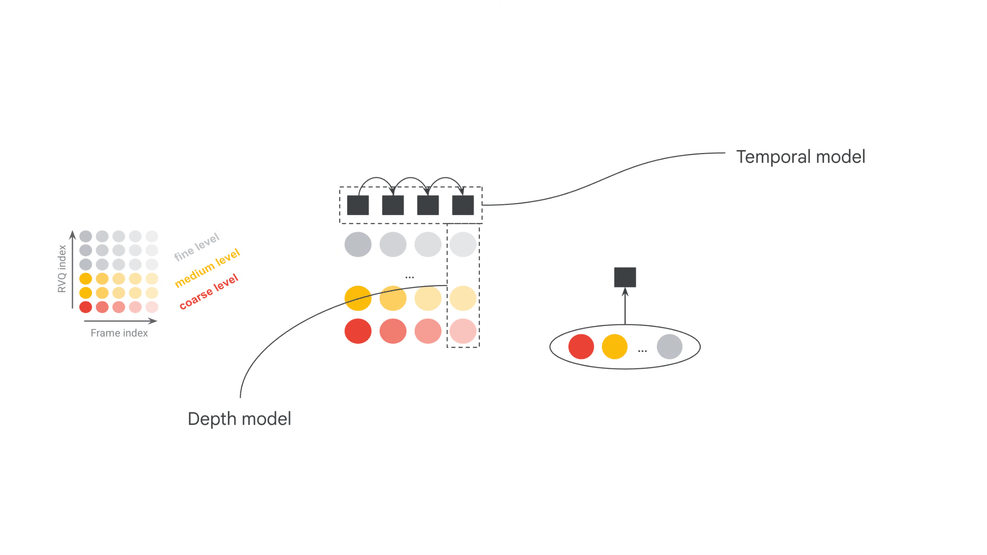
MRT2 的主要生成器是 Decoder-only Transformer。官方模型卡列出兩種設定:Base 版為 2.4B 參數、20 層;Small 版為 230M 參數、12 層。Base 偏向追求品質上限,Small 則偏向降低執行門檻。相較第一代 chunk-wise 路線,MRT2 的關鍵改變是 frame-wise autoregression:每一步只生成一個 codec frame 的 12 個 RVQ tokens。
3. 核心機制:影格級自迴歸與多模態條件對齊
MRT2 降低延遲的核心數學結構,是影格對齊條件注入(Frame-Aligned Conditioning)。在每個時間步 t也就是一個 40ms 的 codec frame 內,Decoder-only Transformer 會在同一套統一注意力機制下,讀取目前影格的 MIDI 條件、MusicCoCa 風格標記與歷史音訊上下文,接著生成目前影格的 RVQ tokens。
其自迴歸條件機率分布可抽象表示為:
其中,A_t 代表目前正在生成的音訊 token 影格,M_t 是目前影格擷取到的 MIDI 條件向量,S 是 MusicCoCa 匯出的風格標記,A_context 代表歷史音訊上下文。MRT2 每生成一個影格,都會重新讀取目前的演奏狀態,因此 MIDI、文字風格與音訊上下文會持續參與發聲。
3.1 128 維 Multihot MIDI 狀態矩陣
為了讓模型即時理解演奏者按下的琴鍵,MRT2 在每個影格中動態注入一個 128 維 multihot 音高向量。針對每個 MIDI pitch 的生命週期,官方模型卡提供四種狀態編碼:
| 0 | Off(音符關閉) |
| 1 | Sustain(持續保持) |
| 2 | Onset(音符剛按下時的瞬態觸發) |
| 3 | Sustain or onset(複雜延音混合,由模型決定) |
模型在每一步前向傳播時,都會讀取目前的 M_t 狀態,演奏者在鍵盤上的細微音符變化也能進入下一個 40ms frame。離線 prompt-to-track 工具通常只在生成前讀取一次條件;MRT2 則讓 MIDI 在整段生成期間維持為連續控制訊號。
4. 長時間生成:因果滑動視窗與注意力彙整
音樂串流生成在理論上可以無限延長。如果自注意力不斷往回擴展,運算複雜度與 KV cache 的顯示記憶體占用會持續增加,演奏幾分鐘後,系統就會被歷史上下文拖垮。MRT2 透過 causal sliding window attention 限制每一層的局部上下文:Base 使用 25 frame(1s)windowed attention,Small 使用 41 frame(約 1.6s)windowed attention;兩者透過多層堆疊取得 20s effective receptive field。
這項設計保留了足夠的局部音樂上下文,同時控制單步運算成本。模型不必記住整場演出的每一個 token,仍能維持短期節奏、音色與和聲關係。對即時系統而言,這種「有限視窗 + 分層感受野」的取捨,比無限上下文更實際。
官方模型卡也提到 learnable attention embeddings,用來改善任意長度生成,以及 context eviction artifacts 的泛化表現。發布頁將這類問題描述為長上下文生成中的 ringing、feedback 等偽影。當滑動視窗持續丟棄舊上下文時,模型需要額外的穩定錨點,避免聲音突然漂移、出現回授尖嘯,或尾音失控。
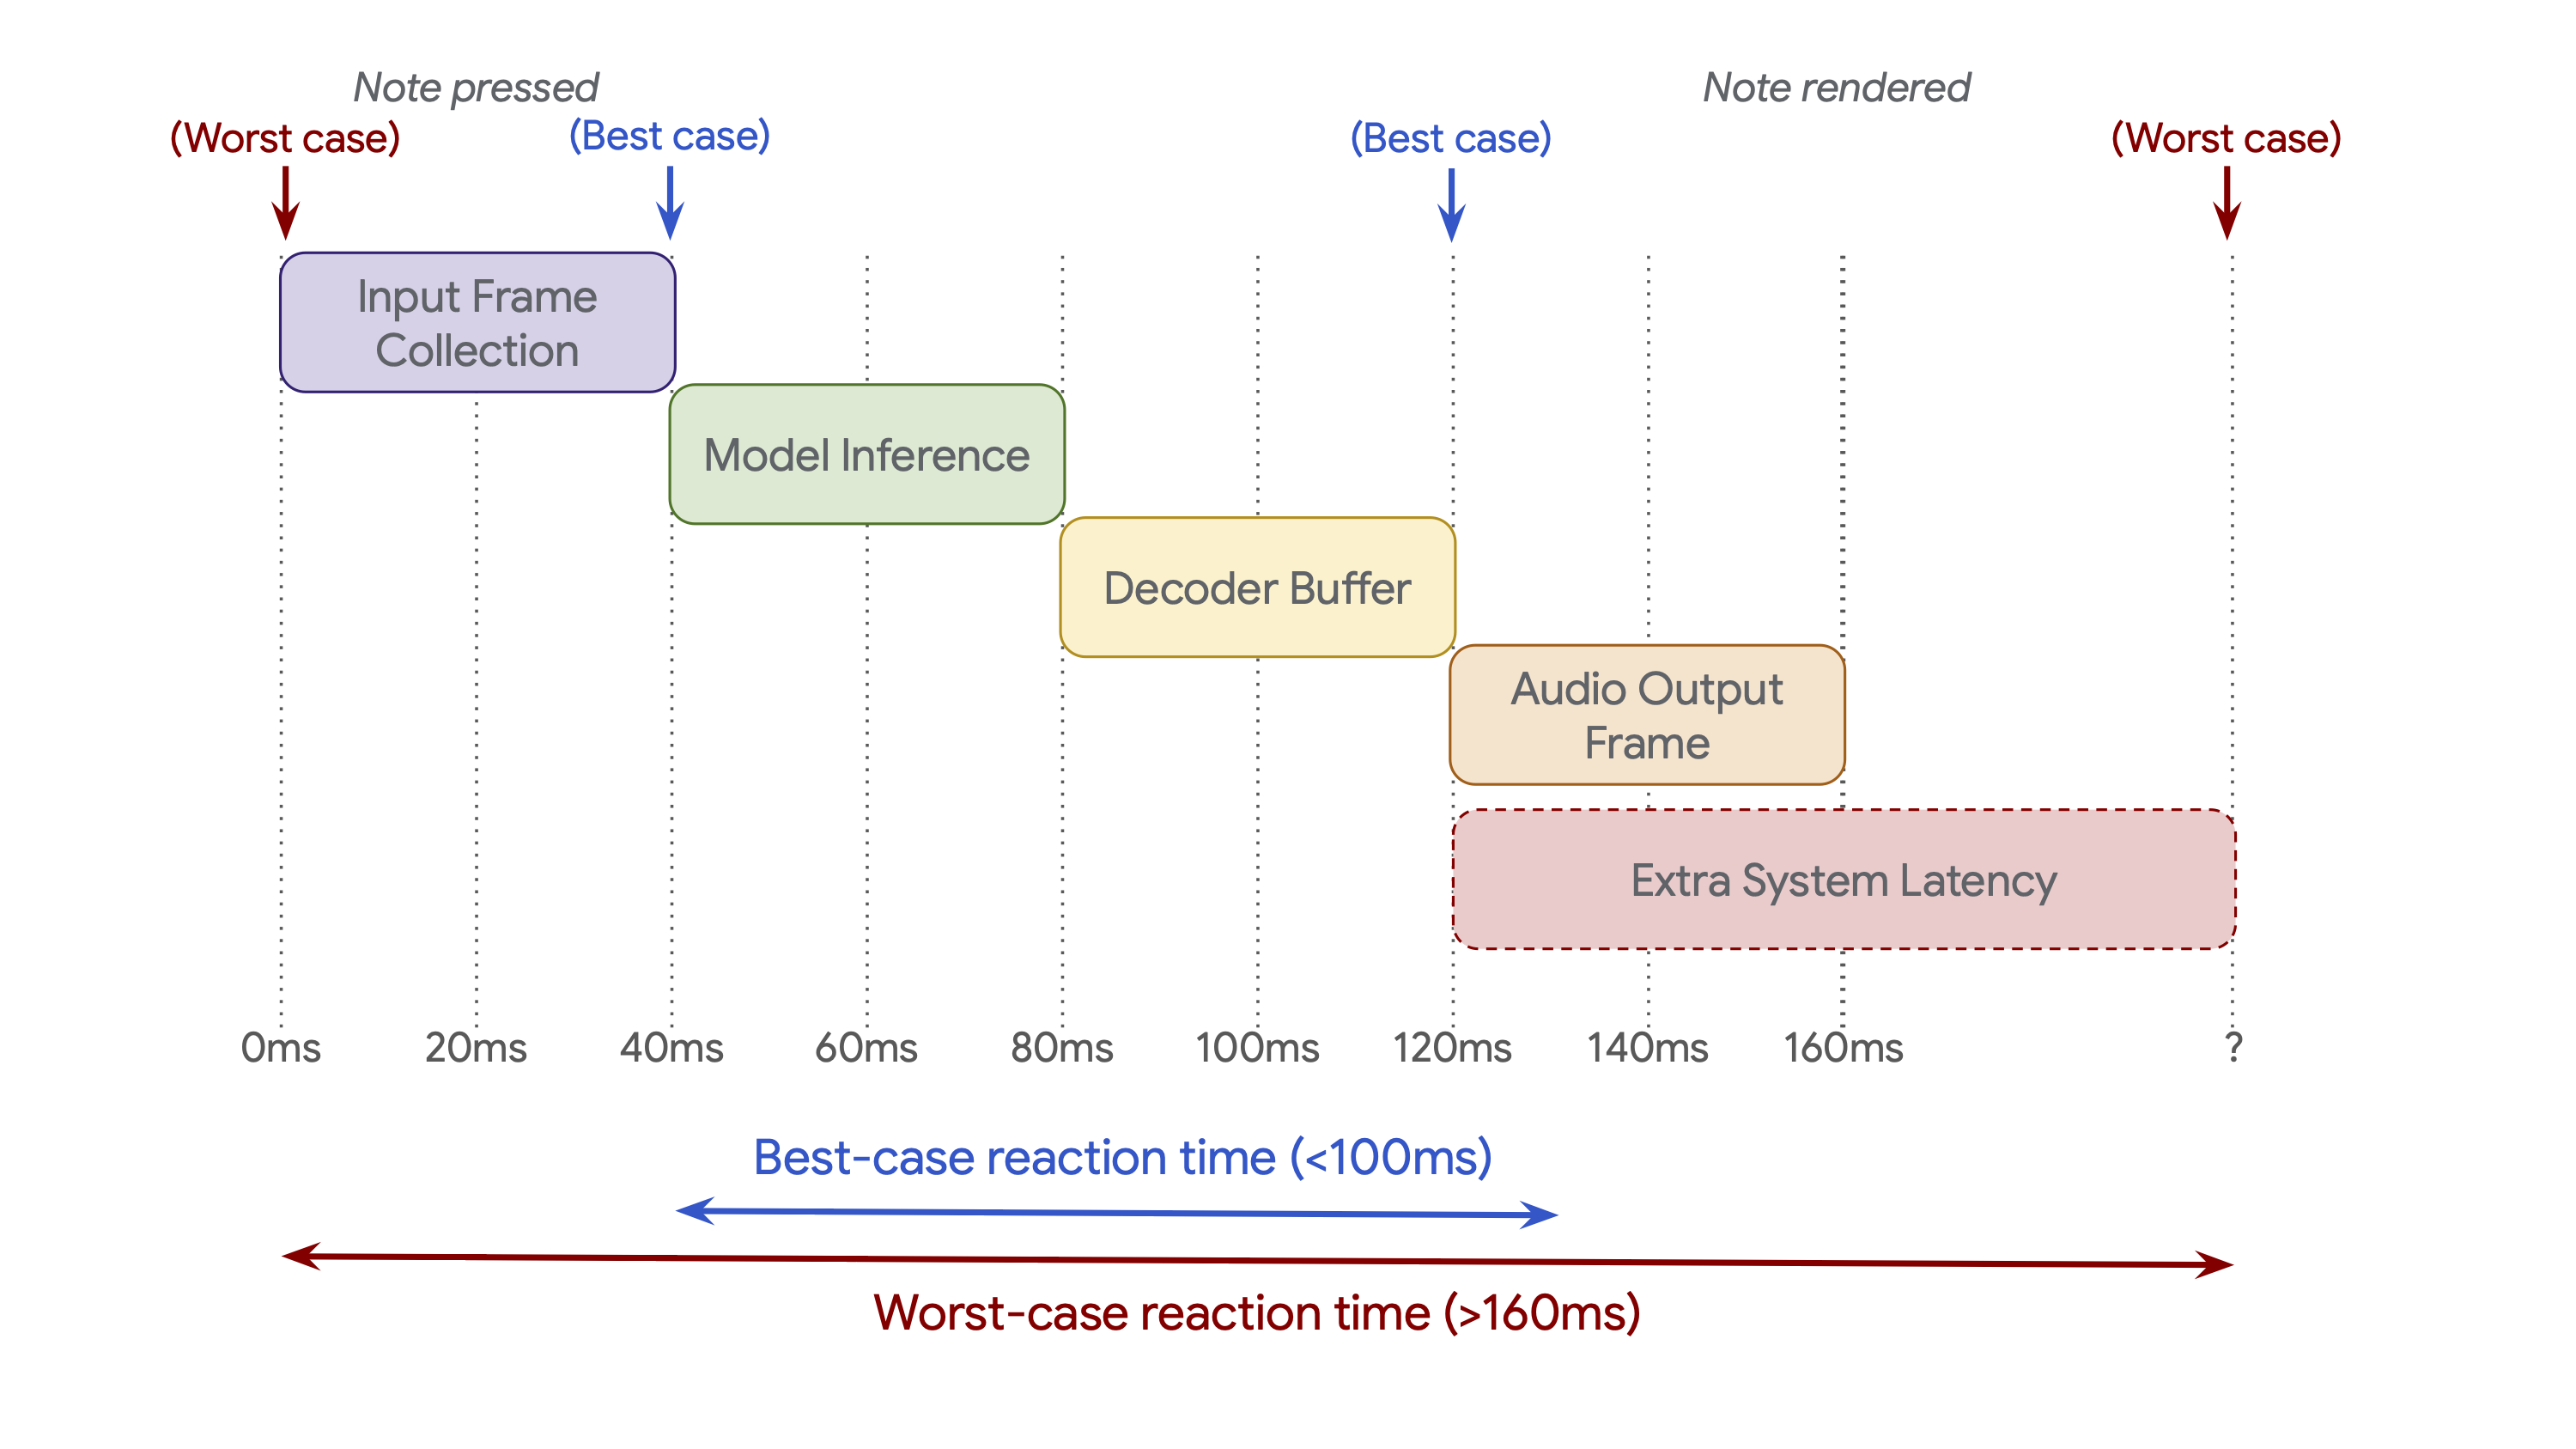
5. 工程實作:MLX C++ 推論引擎與 Apple Silicon 音樂工作流程
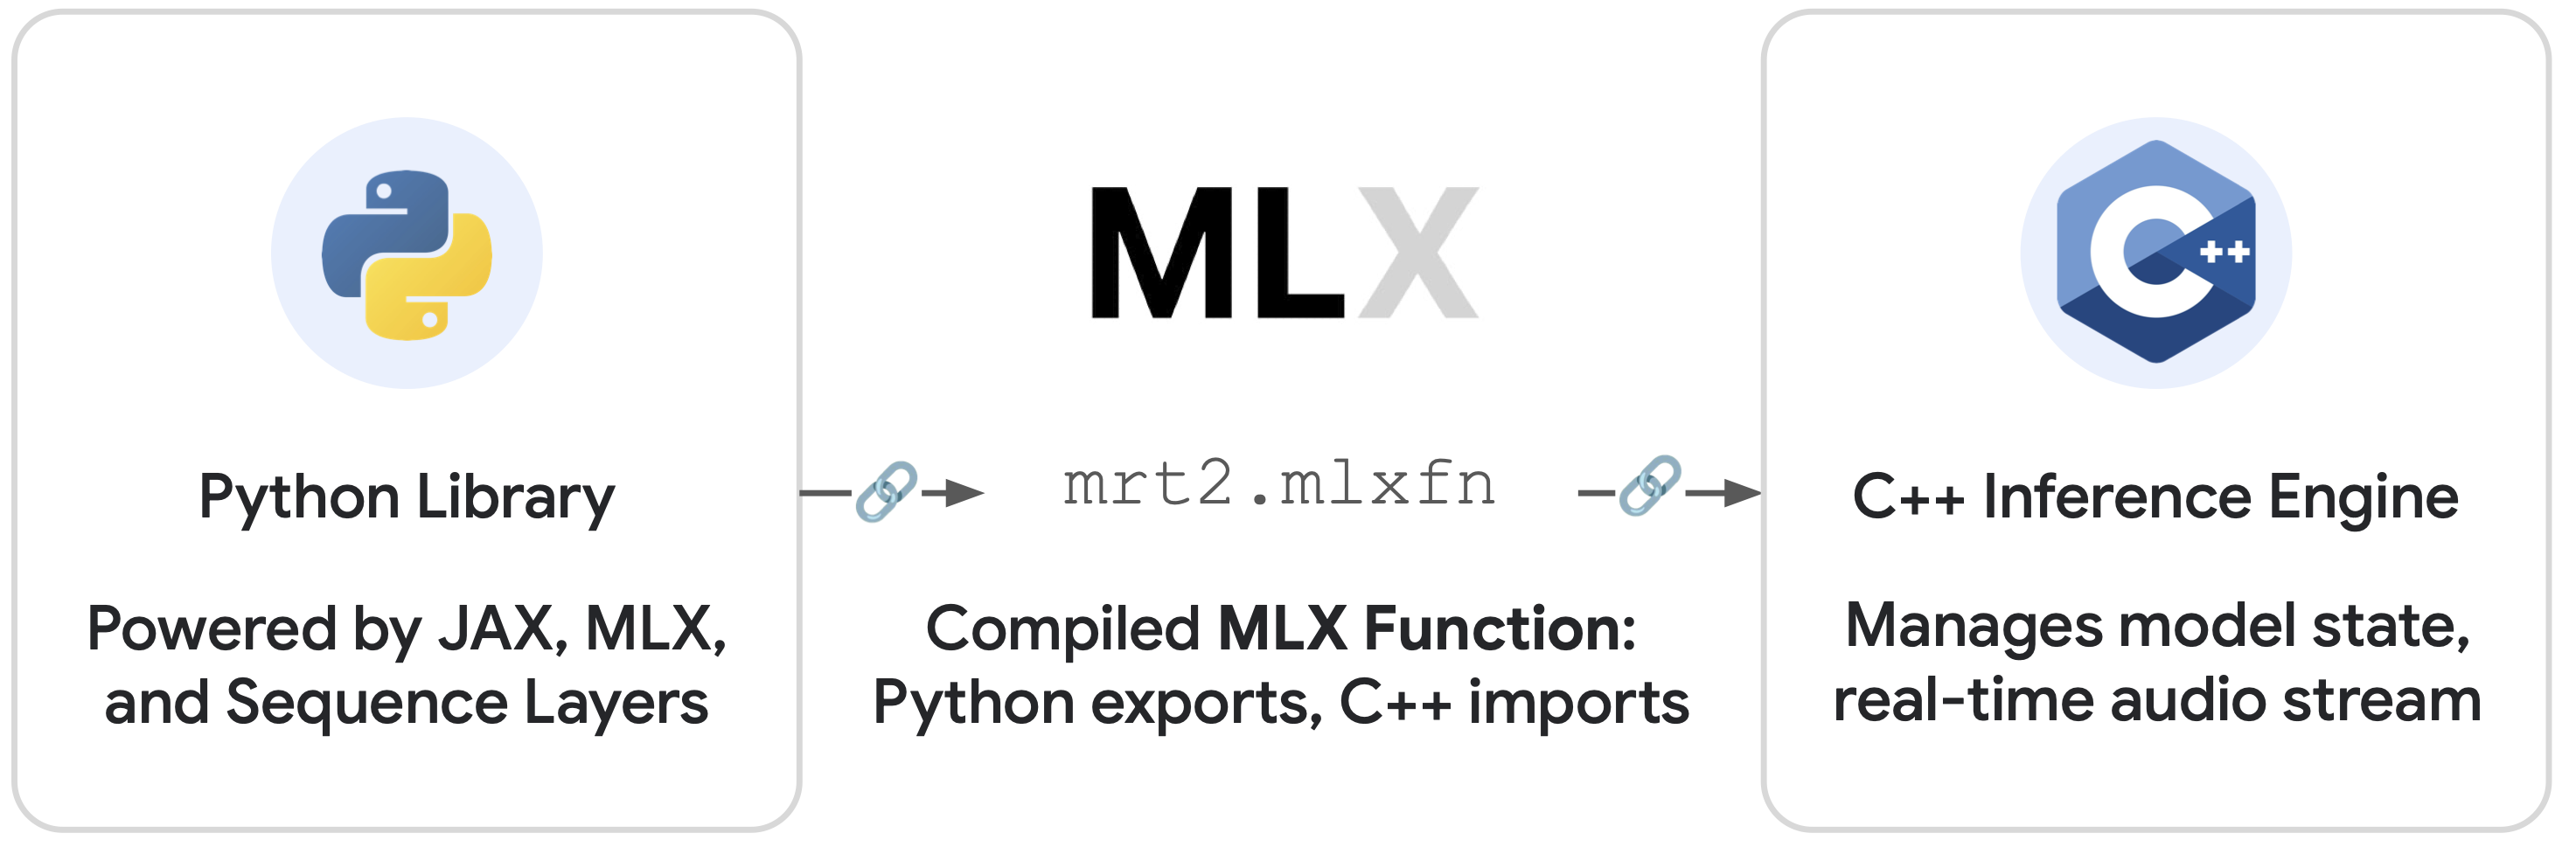
MRT2 的工程部分同樣重要。官方 GitHub 儲存庫提供 Python 推論函式庫 magenta-rt支援 JAX 與 MLX backends;同時提供 C++ inference engine magentart::core用於 Apple Silicon MacBook 上的高效率串流音訊生成。發布頁說明,團隊使用 MLX,將以 SequenceLayers 實作的模型編譯成 .mlxfn 容器檔案,其中包含權重與靜態運算圖;C++ 引擎載入該檔案後,負責模型狀態、音訊緩衝/重新取樣與 MIDI 輸入。
硬體界線必須依官方執行條件準確描述。Small(230M)支援在任何 Apple Silicon Mac 上即時串流執行,包括 Air 機型;Base(2.4B)若要即時執行,則需要效能更強的 Pro/Max 級晶片。兩種模型都能透過 Python library,在 Apple Silicon Mac 或 NVIDIA GPU 上進行 offline non-real-time inference。一般 Mac 能即時執行的是 Small,不能因此推論 Base 也能在所有電腦上即時執行。
這種工程取捨讓 MRT2 不只是一個研究 checkpoint。GitHub 儲存庫列出 AUv3 DAW 外掛、standalone macOS app、note control app 與 prompt-space exploration app 等範例。對音樂軟體開發者而言,這些範例比單張模型卡更重要:它們展示如何把模型放進宿主程式、外掛、控制器與現場系統,而不是只停留在 notebook 裡生成一段 wav。
6. 公開指標與主流神經音樂模型比較
MRT2 目前公開資料的強項,集中在架構參數、延遲定義、輸出入能力、訓練資料與執行界線。官方模型卡說明,技術報告與完整評測結果將於日後發布;因此這張比較表聚焦已公開且能交叉驗證的工程面向,而不是把尚未發布的主觀音質分數,提前寫成排行榜。
| 指標面向 | Magenta RealTime 2 Base | Magenta RealTime 2 Small | 前一代 Magenta RealTime / Lyria RealTime 路線 | 常見離線 prompt-to-track 模型 |
|---|---|---|---|---|
| 單步處理粒度 | 40ms frame-level autoregression | 40ms frame-level autoregression | 前一代 frame size 約 2s | 通常以完整片段或長區塊離線生成 |
| 控制延遲 | 官方發布頁約 200ms | 官方發布頁約 200ms | 約 3s 等級,MRT2 官方稱降低約 15 倍 | 取決於雲端排程與生成長度,通常不以即時演奏為目標 |
| 控制輸入 | 文字、音訊範例、MIDI | 文字、音訊範例、MIDI | 以文字與音訊風格控制為主 | 多半以文字 prompt 與少量結構參數為主 |
| 音訊表示 | SpectroStream,48kHz stereo,25Hz tokens,64 RVQ depth | SpectroStream,48kHz stereo,25Hz tokens,64 RVQ depth | 同屬 codec language model 路線 | 各家不同,通常不公開完整 codec 細節 |
| 模型規模 | 2.4B 參數,20 層 | 230M 參數,12 層 | 前一代公開資訊的定義不同 | 多為閉源,或只公開部分規格 |
| 執行位置 | Apple Silicon Pro/Max 級晶片可即時執行;也能進行離線推論 | 任何 Apple Silicon Mac 都可即時執行 | 前一代需要較高運算能力 | 多半依賴雲端服務 |
| 創作定位 | 即時演奏、風格引導、DAW/應用程式整合 | 較輕量的即時實驗與本機應用 | live music model 的早期路線 | 單次產生完整歌曲或片段 |
7. 界線:器樂、非詞彙化人聲與負責任使用
MRT2 的用途界線同樣清楚。模型卡明確指出,它面向 real-time generation and steering of instrumental music;訓練資料約 7.1 萬小時,主要是 stock music,且 mostly instrumental。在特定提示下,模型可能生成一些 vocal sounds and effects,但這些聲音通常是 non-lexical,也就是非詞彙化的人聲效果,而不是穩定的歌詞演唱。
因此,MRT2 更適合器樂、音色紋理、伴奏、互動音樂、遊戲配樂、裝置藝術、live coding 與音樂教育探索。自動生成完整歌曲、穩定演唱歌詞、商業母帶等級混音,或可直接發行的成品製作,都不是它目前公開資料中的核心承諾。Google 的模型卡也明確強調負責任使用:不得生成侵害他人權利或著作權的內容,輸出的後續使用由使用者自行負責。
MRT2 的關鍵詞是 continuous generation 與 low-latency control。它適合被演奏和引導,而不是只接受提示詞命令。
官方模型卡強調 instrumental music。人聲效果有其界線,更接近非詞彙化的聲音與音效,而不是穩定的歌詞演唱。
開放權重與 MLX/C++ 引擎讓外掛和本機創作軟體整合更可行,但硬體、音訊介面與緩衝區仍會影響使用體驗。
程式碼與權重開放,不代表可以生成侵權內容。模型卡對著作權與輸出責任有明確約束。
結語:讓音樂生成回到演奏者手中
AI 音樂生成的上半場,核心是讓模型理解文字、風格與長篇結構;Magenta RealTime 2 所代表的方向,則是把神經音樂模型重新放回時間軸。40ms 影格級自迴歸、MIDI 影格對齊條件注入、SpectroStream 離散音訊 tokens、MusicCoCa 風格空間、causal sliding window attention 與 MLX C++ 推論引擎,共同把一個大型生成模型收進可即時控制的音樂系統。
MRT2 把模型做成一件可持續操控的神經樂器:它不斷發聲,接收 MIDI 手勢與風格條件,也能進入 DAW、外掛與現場應用。開放權重與本機推論工具,將神經音樂生成從雲端批次處理帶進演奏時間軸,每一次按鍵都可能改變接下來的聲音。