模型
SoulX-Singer 與 YingMusic-Singer-Plus:樂譜驅動與旋律參考,兩首歌聲合成路線
唱出合成 / 路線比較
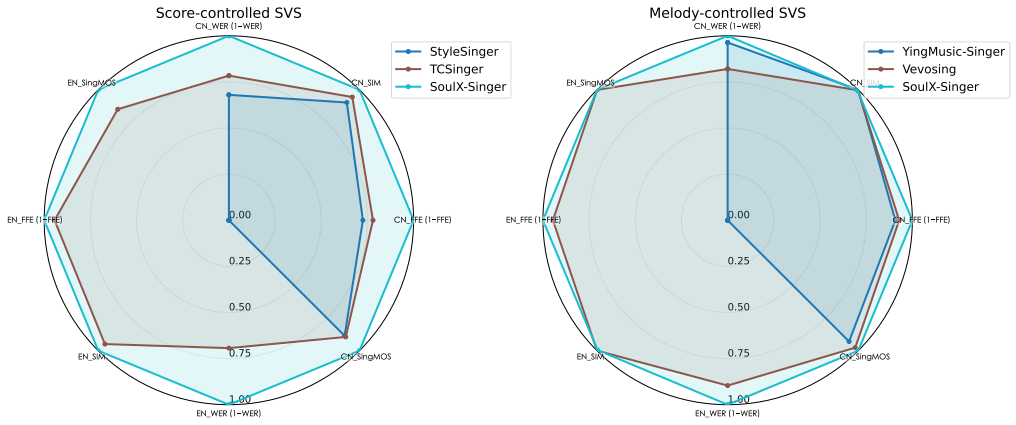
唱出合成 / 路線比較
歌聲合成
SoulX 的樂譜模式讀取由 MIDI 衍生的中繼資料。YingMusic-Singer-Plus 則接收一段提供旋律的歌聲片段,再配合目標歌詞。前者需要音符與歌詞對齊;後者從音訊中編碼旋律。
生成路徑遵循 dx_t/dt = v_θ(x_t,t | l,m,r),速度場以歌詞、旋律與音色參考為條件。若對齊有誤,這條積分路徑便會偏向在發音、節奏與聲音身分之間折衷,結果難以兼顧三者。
SoulX 會把 MIDI 轉換為分段中繼資料;音節必須與音符起點一致。YingMusic 不需要明確的 MIDI,卻需要乾淨的旋律人聲,因為伴奏滲漏會污染其旋律表徵。
SoulX-Singer 的核心輸入是 MIDI、歌詞與音色提示。YingMusic-Singer-Plus 另外著重靈活的歌詞操作,以及不必逐音符標註的旋律引導。比較時必須分開檢視音高、時值、發音細節與參考音色,不能把兩套系統簡化成同一個歌聲開關。
輸入規格決定歌聲系統能做什麼。SoulX-Singer 著重零樣本音色與歌聲生成;YingMusic-Singer-Plus 將歌詞與旋律或樂譜條件結合。兩者都會輸出歌聲,但一方較依賴參考音訊,另一方較依賴結構化音樂資訊。
歌聲合成從拼接與聲學模型,逐步發展至神經聲碼器、編解碼器 token 與大型生成器。音素、音符時值、顫音、換氣與音色之間的對齊始終是核心難題。一段流暢的副歌,仍可能藏著錯誤歌詞,並在小節之間逐漸偏移。

ŝ=G(lyrics, pitch, duration, e_timbre, c_style)pitch音高或旋律輪廓duration音符時值e_timbre從已獲授權的提示中取得的音色SoulX-Singer 使用歌詞、MIDI/中繼資料與音色提示;YingMusic-Singer-Plus 接受更靈活的旋律引導。音高與時值是可以編輯的樂譜條件,而旋律參考還帶有額外的演唱資訊。
音高準確度、時值、歌詞清晰度、音色相似度與換氣必須分開檢查。只挑選一段高音樣本,無法證明整首歌的穩定性。
論文、程式碼與權重可循 SoulX-Singer/SoulX-Singer 論文/YingMusic-Singer-Plus 查閱。

每一列保留原始來源中的架構、指標或任務定義;未採用共同規格的結果仍分開呈現。
| 模型 | 架構或證據 | 範圍 |
|---|---|---|
| SoulX-Singer | 參考驅動的零樣本歌聲 | 聲音身分、歌詞與長篇穩定性 |
| YingMusic-Singer-Plus | 歌詞加旋律/樂譜 | 對齊、音域與速度 |
| 傳統歌聲合成流程 | 明確聲學特徵加聲碼器 | 控制清楚,但跨領域自然度有限 |

逐字比對是否有遺漏、子音遭吞沒、重複或子音時序錯誤,再檢查起音音高、滑音與顫音。自然度不能取代內容準確度。
比較時應固定調性、BPM、拍號與參考片段。參考音訊中的伴奏與殘響可能一併複製到輸出。
複製歌手聲音必須取得明確許可,也不得用於冒充、欺騙或規避權利。
模型無法取代編曲或聲樂指導。音域、咬字、情緒與語言習慣仍需人工處理。
模型名稱、數字與限制均可追溯至下列論文、儲存庫或模型卡。