SFC-Locoformer:11.8 dB DnR 的自適應頻譜壓縮與對白邊界
論文精讀 / 影視聲音分離
論文研讀 / 影視分離
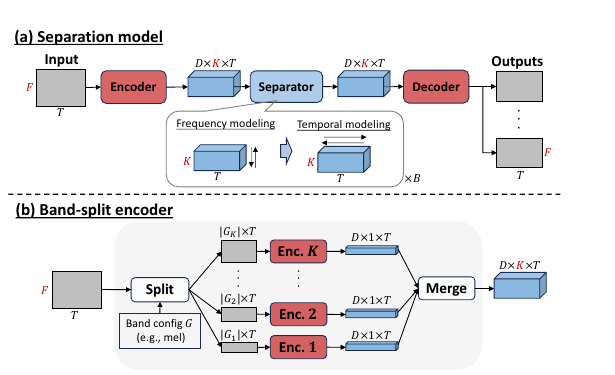
DnR 把節目混音拆成對白、音樂與音效。這三類聲源在時間與頻率上彼此重疊,問題無法簡化成語音活動偵測。SFC-Locoformer、BandIt 與 TIGER-DnR 面對同一項任務,採用的壓縮方式、序列成本與公開證據各不相同。
頻譜壓縮
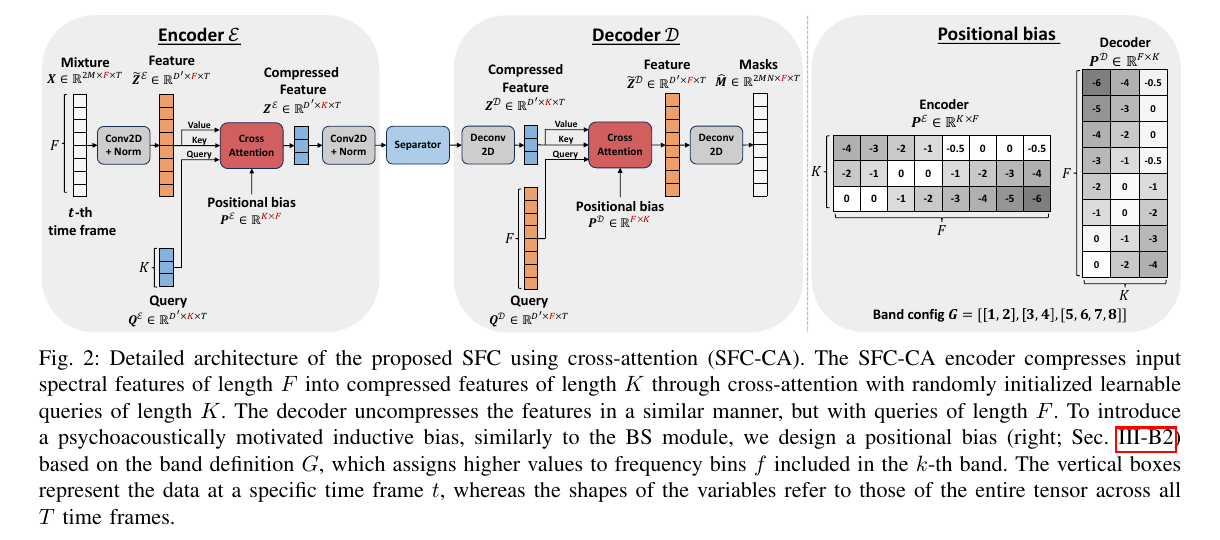
STFT 產生複數頻譜 X(t,f)。讓每個相鄰頻段都分到相同的通道預算,等於把算力花在高度相關的特徵上。SFC 學習一組投影,把頻譜壓進一條更緊湊的頻譜軸:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
解碼器透過交叉注意力,把壓縮後的表示還原回目標頻段。這一步並未砍掉高頻:子音瞬態、持續泛音與寬頻音效,分離器仍然都拿得到。
局部與長程上下文
局部區塊負責刻畫撞擊聲、爆破音與鼓點起音;跨視窗的交流則承載音樂鋪底、整句話與環境氛圍。若只用一片稠密注意力場,記憶體會隨時長急遽膨脹。Locoformer 把局部混合與節省的長程交換結合起來,讓釋出的 medium checkpoint 維持在實用的規模。
正確解讀 11.8 dB
Table II 在同一套 DnR 測試協定下,記錄 SFC-Locoformer medium 為 11.8 dB、BandIt 為 10.9 dB。所用的尺度不變目標為:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
它支援同一協定內的排名,無法用來對照 MUSDB、另一版 DnR 或精挑的片段。領先 0.9 dB 也不保證每一段電影片段都勝出;摩擦音、環境聲的寬度與音效瞬態,仍需要盲聽檢驗。
已釋出的程式碼與權重
作者公開了 SFC-CA、SFC-Mamba 與 BandIt 編碼器、TF-Locoformer 分離器,以及 MUSDB18-HQ 與 DnR 的預訓練權重。論文架構、儲存庫實作與模型卡檔案因此可以互相核對;11.8 dB 仍然只屬於 Table II 的 DnR v2 協定。
從 DnR 基準到壓縮頻譜
對白、音樂與音效分離在 2021 年 DnR Challenge 之後,有了相對穩定的目標定義。BandIt 隨後把建模容量集中在非均勻頻帶上,TIGER 則嘗試更省算力的序列模型。SFC-Locoformer 提出的是另一個工程問題:既然相鄰頻段彼此冗餘,能否先壓縮,再把模型預算花在更長的對白與配樂結構上?
正因為有這段脈絡,這三個已釋出的模型才適合放在同一個任務頁面上,又不該被描述成單純的舊換新。BandIt 是強悍的頻帶切分基線,TIGER 提供了以算力為考量的另一種選擇,而釋出的 SFC medium checkpoint 在 Table II 所用的同一套 DnR v2 協定下繳出 11.8 dB。架構、權重與評測協定,三者都不能忽略。
頻譜壓縮是一種自適應算子
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)複數輸入頻譜A(k,f|X)隨輸入調整的頻帶聚合Z(t,k)壓縮後的序列表示
A 並非固定的頻率修剪規則。它是一組隨輸入變化的聚合權重,因此較短的 k 軸能為對白、配樂與環境聲騰出更多沿時間軸的序列容量。
解碼器仍以未壓縮的特徵進行查詢,把每個輸出頻段還原回來。這條公式是資訊流向的抽象;儲存庫中的 CrossAttnEncoder、CrossAttnDecoder 與自適應查詢,才是可供稽核的實作。
論文、程式碼與權重可以沿著 SFC-Locoformer 原始碼 / 已釋出 DnR checkpoint / SFC 論文與 DnR 表格逐一追查。
同一張表能說到哪裡
此處只排名同一公開協定下驗證過的列;TIGER-DnR 在缺乏對應結果時,不會被塞進 Table II。
| 模型 | 公開成績 | 解讀方式 |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | 此協定公開值最高;對白邊緣仍要稽核 |
| BandIt | 10.9 dB SI-SDR | 同協定的頻帶切分基線 |
| TIGER-DnR | 效率證據另行呈現 | 不混入空缺的表列 |
平均分之外的三項試聽檢查
對白方面,留意齒音、氣音與遠處的說話聲。SI-SDR 在比較中排除了整體增益,卻可能漏掉金屬感毛邊與受損的房間殘響。音樂方面,檢查是否殘留語音鬼影;音效方面,留意門聲、腳步聲與環境聲的連續性是否保住。
廣播混音還會出現限制器、對白閃避與聲道下混。DnR 論文協定不會自動代表每一條交付母帶;比較 SFC、BandIt 與 TIGER 時應使用相同片段,並分別稽核對白邊緣、音樂洩漏與環境聲連續性。
模型認不出場景中的每個物件
音效軌是一個寬鬆的大容器。雨聲、車流、掌聲與擬音仍然混在一起,DnR 的輸出算不上物件級的聲音分解。
即使任務形式不再用模型授權的說教打斷工作流程,上游授權條款依舊規範著部署與再散布。
SFC-Locoformer 原始碼的論文與公開檔案
模型名稱、數字與限制,均可追溯到下列論文、儲存庫或模型卡。