模型
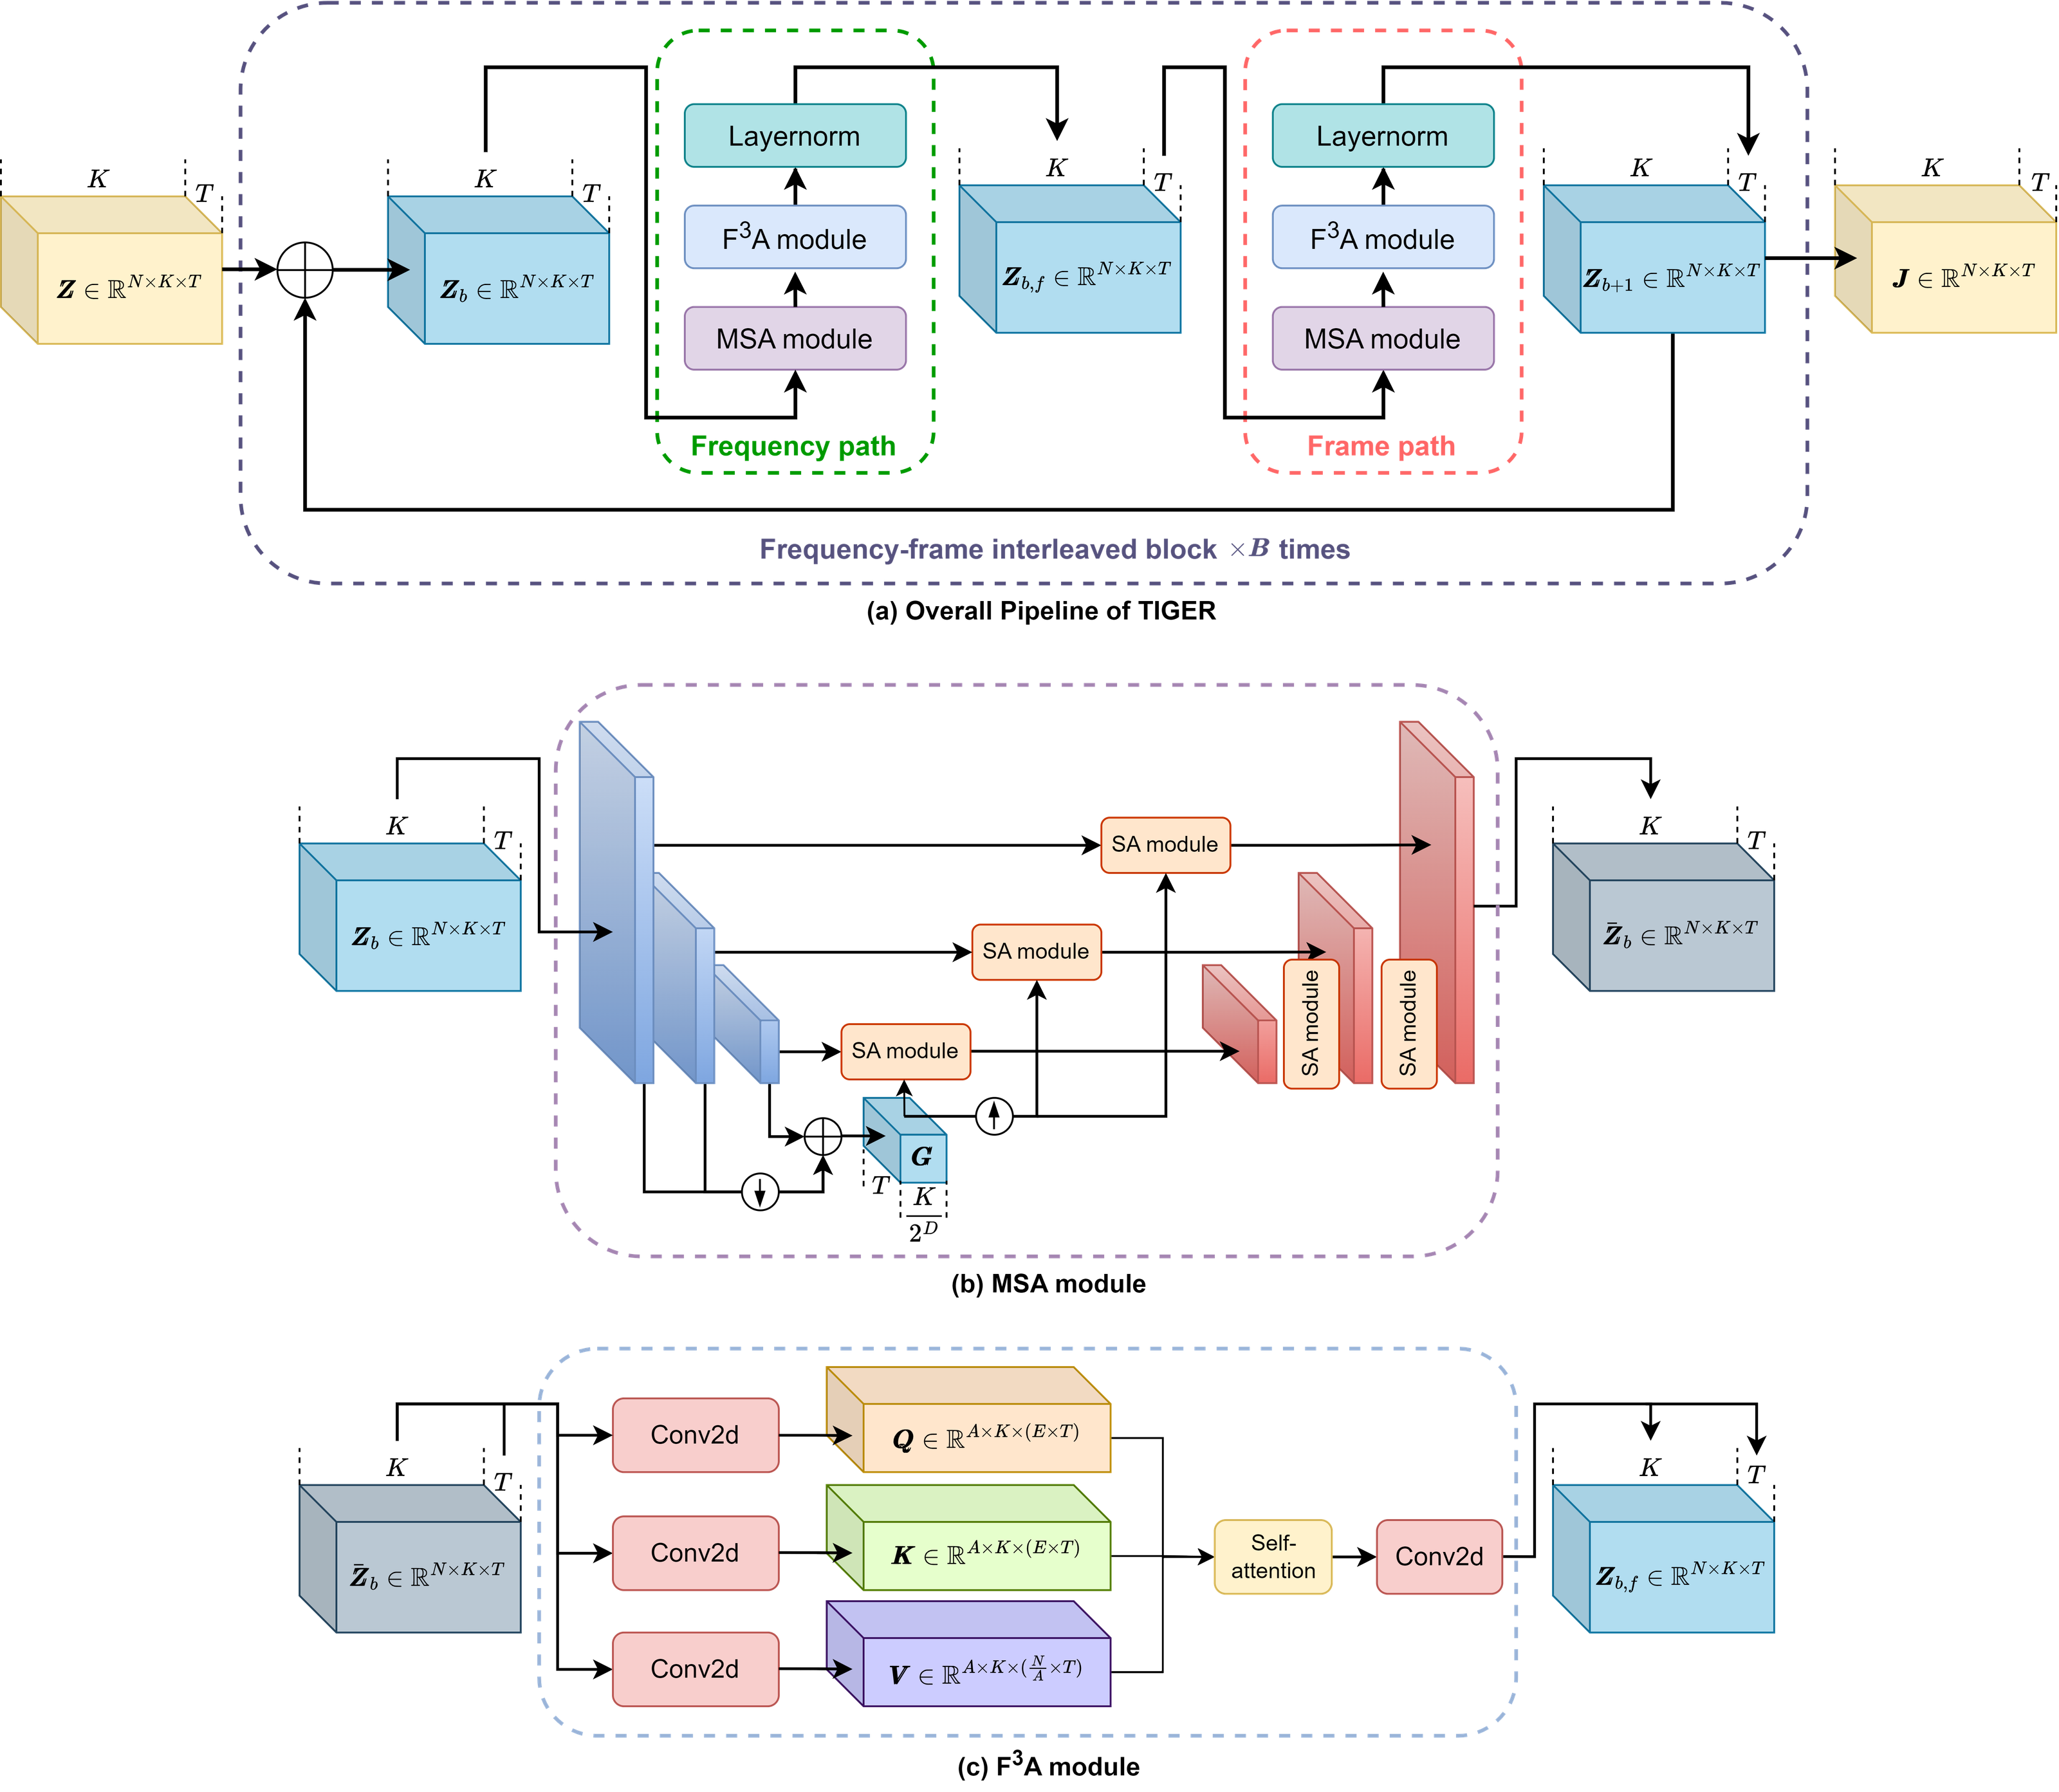
BandIt 與 TIGER-DnR:影視三軌分離的計算分配之爭
影視音 / DnR
影視音 / DnR
電影音訊 / DnR
電影級分離必須在三類寬泛聲源長時間共存的情況下,各自保住完整性。BandIt 把容量花在非均勻頻帶上,TIGER 則追求更高效的序列模型。
先把估計值投影到參考訊號上,s_target=<ŝ,s>s/||s||²,再計算 SI-SNR=10log10(||s_target||²/||ŝ-s_target||²)。增益因素被排除了,但瞬態塗抹與空間受損仍需實際聆聽檢驗。
BandIt 以非均勻頻帶刻畫資訊密集的區域,並在頻帶之間交換資訊。同協議比較中它取得 10.9 dB,低於已發布的 SFC-Locoformer medium 檢查點的 11.8 dB。因此 BandIt 的定位是架構對照,而非預設選項。
TIGER-DnR 在對應的 DnR 情境下回報約 9.8 dB,設計上強調高效的時頻互動。這個數字只有在它標明的協議下才有意義;速度、授權與分離品質仍是各自獨立的軸線。
DnR 把對白、音樂與音效確立為共同的電影分離目標。BandIt 對非均勻頻帶建模,TIGER 則壓低長序列的成本;兩者回答的是不同的工程問題,彼此並非取代關係。
在 BandIt 回報 10.9 dB 的同一張 DnR v2 表格裡,SFC-Locoformer 後來取得 11.8 dB。TIGER 公開的證據著重於效率與獨立實驗。缺少可對照的一列,它就只是一個可選用的模型,而非憑空編造的榜單名次。

h_b=Enc_b(X[F_b,:]), Ŝ=Dec({h_b}_{b=1}^B)F_b頻帶 b 內的頻率點Enc_b頻帶內編碼Dec跨頻帶重建BandIt 先把複數頻譜切成非均勻頻帶,再在頻帶內與頻帶間交換資訊。TIGER 強調更省成本的序列表示。兩者都輸出 DnR 音軌,差別在於算力怎麼花。
只有資料切分、取樣率、音軌定義與指標實作全部對得上,數字才能放在一起比。在沒有對應協議時讓 TIGER 留空,比借用別張表格更嚴謹。
論文、程式碼與權重可循 BandIt / TIGER / DnR 的比較脈絡查閱。

每一列都保留各自的來源架構、指標或任務定義;沒有共同協議的結果維持分列。
| 模型 | 架構或證據 | 適用範圍 |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | 同一張 DnR v2 表格中目前的品質基準 |
| BandIt | 10.9 dB SI-SDR | 同協議的頻帶切分基線 |
| TIGER-DnR | 效率證據另行列出 | 缺少對照表格列則不排名次 |

聽對白時,檢查齒音、呼吸聲與遠處台詞;聽音樂時,留意人聲殘影與受損的打擊樂;聽音效時,確認腳步聲、開關門與環境音的連貫。平均 SI-SDR 做不了這些聆聽檢查。
交付母帶裡有閃避、限制器、聲道下混與響度處理。論文的單聲道協議是可重現的基線,並不等於每一張母帶。檔案與模型的中繼資料讓逐軌 A/B 比對成為可能。
音效仍是一個寬泛的容器,並未細分為腳步聲、雨聲、車流或掌聲這類具體類別。三條音軌不等於物件層級的聲音理解。
已發表的分數取決於資料集版本、取樣率與運算條件。榜單上的每一列都保留指標方向、協議與來源。
模型名稱、數字與限制,都可追溯到下列論文、儲存庫或模型卡。