Modèle
SoulX-Singer et YingMusic-Singer-Plus : partition et référence mélodique, deux voies de synthèse vocale chantée
Synthèse chantée / comparaison d'itinéraires
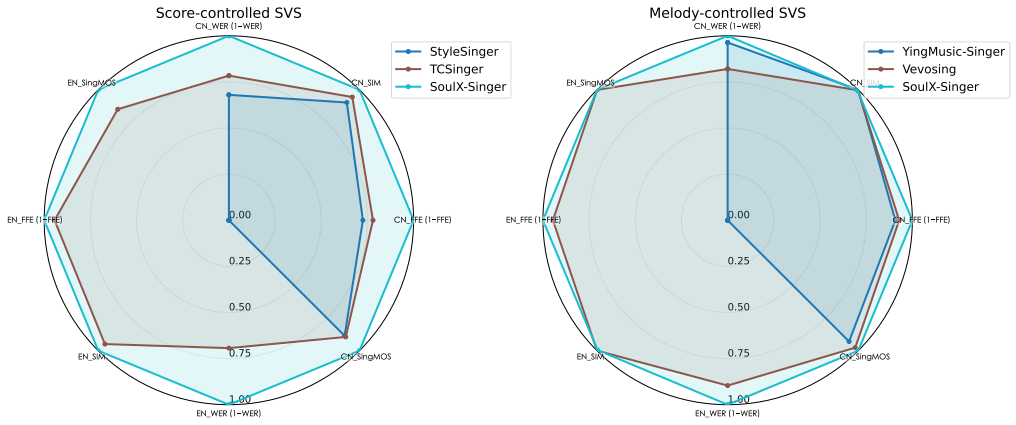
Synthèse chantée / comparaison d'itinéraires
SYNTHÈSE VOCALE CHANTÉE
Le mode partition de SoulX exploite des métadonnées dérivées du MIDI. YingMusic-Singer-Plus exploite un extrait chanté qui fournit la mélodie, accompagné des paroles cibles. Le premier exige un alignement entre notes et paroles ; le second encode la mélodie à partir de l’audio.
Le processus de génération suit dx_t/dt = v_θ(x_t,t | l,m,r), avec un champ de vitesse conditionné par les paroles, la mélodie et une référence de timbre. Un mauvais alignement infléchit cette trajectoire intégrée vers un compromis médiocre entre prononciation, rythme et identité.
SoulX convertit le MIDI en métadonnées segmentées ; les syllabes doivent coïncider avec les attaques des notes. YingMusic évite le MIDI explicite, mais requiert une voix mélodique propre, car les fuites d’accompagnement contaminent sa représentation de la mélodie.
SoulX-Singer s’articule autour du MIDI, des paroles et d’une consigne de timbre. YingMusic-Singer-Plus met aussi l’accent sur la manipulation souple des paroles et le guidage mélodique sans annotation note par note. La comparaison doit distinguer hauteur, durée, articulation et timbre de référence, plutôt que de réduire les deux systèmes à un même interrupteur de chant.
Le contrat d’entrée détermine les possibilités d’un système de chant. SoulX-Singer privilégie le timbre zero-shot et la génération de chant ; YingMusic-Singer-Plus associe les paroles à des conditions mélodiques ou de partition. Les deux produisent du chant, mais l’un dépend davantage d’un audio de référence et l’autre d’une musique structurée.
La synthèse vocale chantée est passée de la concaténation et des modèles acoustiques aux vocodeurs neuronaux, aux tokens de codec et aux grands générateurs. L’alignement entre phonèmes, durée des notes, vibrato, respirations et timbre reste le problème de fond. Un refrain fluide peut masquer des paroles erronées et dériver au fil des mesures.

ŝ=G(lyrics, pitch, duration, e_timbre, c_style)pitchhauteur ou contour mélodiquedurationdurée de la notee_timbretimbre issu d’une consigne autoriséeSoulX-Singer utilise les paroles, le MIDI/les métadonnées et une consigne de timbre ; YingMusic-Singer-Plus accepte un guidage mélodique plus souple. La hauteur et la durée sont des conditions de partition modifiables, tandis qu’une référence mélodique transporte des informations d’interprétation supplémentaires.
La justesse, la durée, l’intelligibilité des paroles, la similitude du timbre et la respiration sont des contrôles distincts. Un seul extrait aigu soigneusement choisi ne permet pas d’établir la stabilité sur toute la durée d’un morceau.
L’article, le code et les poids sont accessibles via SoulX-Singer / l’article SoulX-Singer / YingMusic-Singer-Plus.

Chaque ligne conserve l’architecture, la métrique ou la définition de tâche de sa source ; les résultats dépourvus de protocole commun restent séparés.
| Modèle | Architecture ou élément probant | Périmètre |
|---|---|---|
| SoulX-Singer | chant zero-shot guidé par une référence | identité, paroles et stabilité sur une longue durée |
| YingMusic-Singer-Plus | paroles avec mélodie/partition | alignement, tessiture et tempo |
| chaîne traditionnelle de synthèse vocale chantée | caractéristiques acoustiques explicites et vocodeur | contrôle clair, mais naturel limité d’un domaine à l’autre |

Il faut comparer chaque mot pour repérer les omissions, les consonnes avalées, les répétitions et le calage des consonnes, puis examiner l’attaque de la hauteur, les glissés et le vibrato. Le naturel ne remplace pas l’exactitude du contenu.
La tonalité, le BPM, la mesure et l’extrait de référence doivent rester constants. L’accompagnement et la réverbération présents dans la référence peuvent être reproduits dans la sortie.
Le clonage d’un chanteur exige une autorisation explicite et ne doit faciliter ni l’usurpation d’identité, ni la tromperie, ni le contournement des droits.
Le modèle ne remplace ni l’arrangement ni la direction vocale. La tessiture, la diction, l’émotion et les habitudes linguistiques demandent toujours un travail humain.
Les noms de modèles, les chiffres et les limites renvoient aux articles, dépôts ou fiches de modèle ci-dessous.