Modèle
SFC-Locoformer : compression spectrale adaptative et limites de dialogue pour 11,8 dB DnR
Lecture intensive du journal / Séparation du son du cinéma et de la télévision
Lecture intensive du journal / Séparation du son du cinéma et de la télévision
© 2026 TelkNet. Tous droits réservés.
LECTURE D'ARTICLE / SÉPARATION CINÉMA
DnR sépare le mixage d'un programme en dialogue, musique et effets. Ces sources se chevauchent en temps comme en fréquence : le problème ne se réduit donc pas à une détection d'activité vocale. SFC-Locoformer, BandIt et TIGER-DnR traitent la même tâche avec des schémas de compression, des coûts de séquence et des preuves publiées différents.
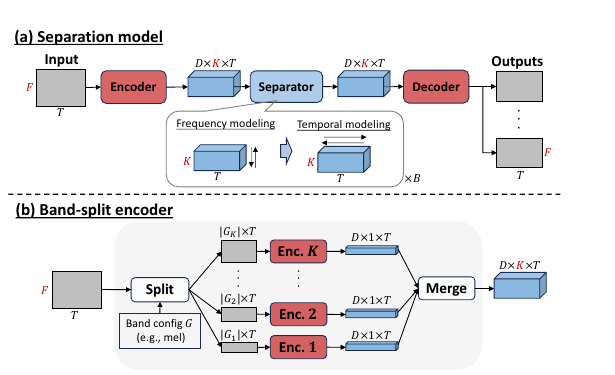
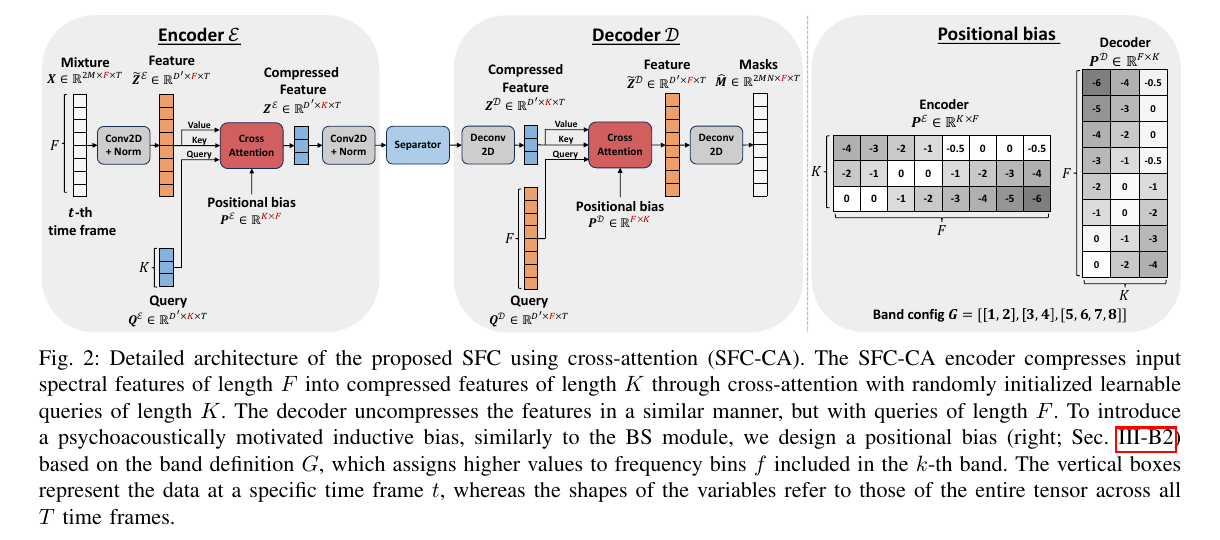
Une STFT produit le spectre complexe X(t,f). Allouer le même budget de canaux à chaque bin adjacent revient à dépenser du calcul sur des caractéristiques fortement corrélées. SFC apprend une projection vers un axe spectral compact :
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
Le décodeur utilise l'attention croisée pour ramener la représentation compressée vers les bins fréquentiels cibles. Il ne s'agit pas d'une coupure de hautes fréquences : les transitoires de consonnes, les harmoniques tenues et les effets à large bande restent à la disposition du séparateur.
Les blocs locaux modélisent les impacts, les plosives et les attaques de batterie ; la communication entre fenêtres porte les nappes musicales, les phrases et l'ambiance. Un champ d'attention dense unique ferait grimper fortement la mémoire avec la durée. Locoformer combine un mélange local et un échange longue portée économe, de sorte que le checkpoint medium publié reste exploitable.
La table II rapporte 11.8 dB pour SFC-Locoformer medium et 10.9 dB pour BandIt sous le même protocole de test DnR. L'objectif invariant d'échelle est :
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Il fonde un classement au sein du protocole, et non des comparaisons avec MUSDB, une autre révision de DnR ou des extraits triés à la main. L'avance de 0.9 dB ne garantit pas non plus la victoire sur chaque extrait de film ; les fricatives, la largeur d'ambiance et les transitoires d'effets exigent toujours une écoute à l'aveugle.
Les auteurs publient les encodeurs SFC-CA, SFC-Mamba et BandIt, le séparateur TF-Locoformer, ainsi que des poids pré-entraînés MUSDB18-HQ et DnR. L'architecture de l'article, l'implémentation du dépôt et les fichiers de fiche modèle peuvent donc être vérifiés les uns contre les autres ; les 11.8 dB ne restent valables que pour le protocole DnR v2 de la table II.
La séparation dialogue, musique et effets a gagné une définition de cible relativement stable après le DnR Challenge 2021. BandIt a ensuite concentré sa capacité de modélisation sur des bandes de fréquences non uniformes, tandis que TIGER explorait un modèle de séquence moins coûteux. SFC-Locoformer pose une question d'ingénierie différente : si les bins fréquentiels voisins sont redondants, peut-on les compresser avant de dépenser le budget du modèle sur des structures de dialogue et de partition plus longues ?
Cet historique explique pourquoi les trois modèles publiés ont leur place sur une même page de tâche sans être décrits comme un simple remplacement de l'ancien par le nouveau. BandIt est une solide référence à découpage en bandes, TIGER offre une alternative orientée calcul, et le checkpoint SFC medium publié annonce 11.8 dB sous le même protocole DnR v2 que celui de la table II. L'architecture, les poids et le protocole d'évaluation comptent tous.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)spectre d'entrée complexeA(k,f|X)agrégation de bandes adaptative à l'entréeZ(t,k)représentation de séquence compresséeA n'est pas une règle fixe d'élagage fréquentiel. C'est un poids d'agrégation dépendant de l'entrée : l'axe k raccourci laisse donc davantage de capacité de séquence au dialogue, à la partition et à l'ambiance dans le temps.
Le décodeur interroge toujours les caractéristiques non compressées pour restaurer chaque bin de sortie. L'équation est une abstraction du flux d'information ; CrossAttnEncoder, CrossAttnDecoder et la requête adaptative du dépôt en sont l'implémentation auditable.
L'article, le code et les poids se suivent via Source SFC-Locoformer / Checkpoint DnR publié / Article SFC et table DnR.
Seules les lignes vérifiées sous le même protocole publié sont classées ici ; TIGER-DnR n'est pas inséré dans la table II faute de résultat correspondant.
| Modèle | Résultat publié | Comment le lire |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | valeur publiée la plus élevée de ce protocole ; auditer toujours les bords de dialogue |
| BandIt | 10.9 dB SI-SDR | référence à découpage en bandes sous le même protocole |
| TIGER-DnR | preuves d'efficacité présentées à part | non mélangé à une ligne de table absente |
Sur le dialogue, écoutez les sibilantes, les respirations et la parole lointaine. SI-SDR retire le gain global de la comparaison, mais il peut manquer les bords métalliques et les queues de salle abîmées. Sur la musique, vérifiez l'absence de fantômes de parole ; sur les effets, préservez la continuité des portes, des pas et de l'ambiance.
Les mixages broadcast contiennent aussi du limiting, du ducking de dialogue et des fold-down de canaux. Un protocole d'article DnR ne représente pas automatiquement chaque master de livraison ; les comparaisons entre SFC, BandIt et TIGER devraient utiliser les mêmes extraits et auditer séparément les bords de dialogue, les fuites de musique et la continuité de l'ambiance.
La piste d'effets est un conteneur large. Pluie, trafic, applaudissements et foley restent combinés : la sortie DnR n'est donc pas une décomposition sonore au niveau des objets.
Les conditions de licence en amont régissent toujours le déploiement et la redistribution, même si le formulaire de tâche n'interrompt plus le flux de travail avec un rappel sur les licences de modèles.
Les noms de modèles, les chiffres et les limites se rattachent aux articles, dépôts ou fiches modèles ci-dessous.