Modell
SFC-Locoformer: Adaptive Spektralkomprimierung und Dialoggrenzen für 11,8 dB DnR
Intensive Lektüre der Abschlussarbeit / Film- und Fernsehtontrennung
Intensive Lektüre der Abschlussarbeit / Film- und Fernsehtontrennung
© 2026 TelkNet. Alle Rechte vorbehalten.
PAPER-LEKTÜRE / FILMISCHE TONSEPARATION
DnR zerlegt eine Programmmischung in Dialog, Musik und Effekte. Diese Quellen überlappen sich sowohl zeitlich als auch spektral, sodass sich das Problem nicht auf reine Sprachaktivitätserkennung reduzieren lässt. SFC-Locoformer, BandIt und TIGER-DnR greifen dieselbe Aufgabe mit unterschiedlichen Kompressionsschemata, Sequenzkosten und publizierten Belegen auf.
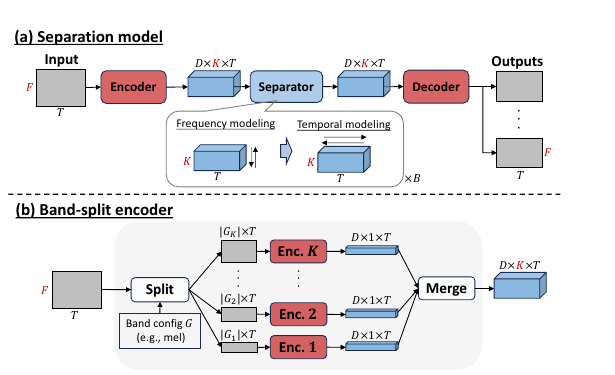
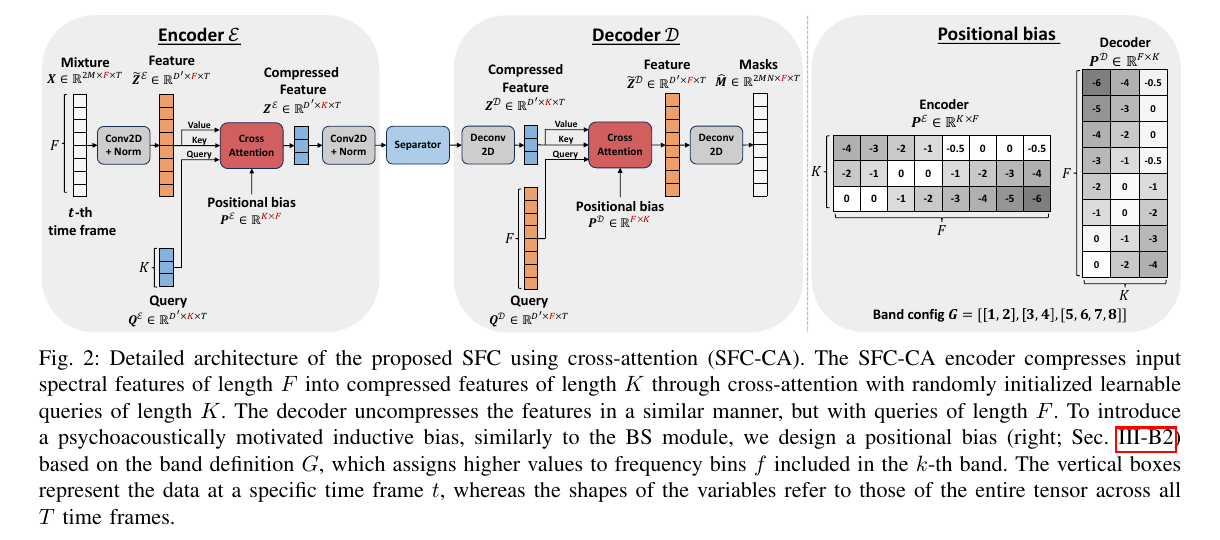
Eine STFT liefert das komplexe Spektrum X(t,f). Vergibt man an jedes benachbarte Bin dasselbe Kanalbudget, fließt Rechenleistung in hochgradig korrelierte Merkmale. SFC lernt stattdessen eine Projektion auf eine kompakte Spektralachse:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
Der Decoder bildet die komprimierte Darstellung per Cross-Attention zurück auf die Ziel-Frequenzbins. Das ist kein Hochfrequenzschnitt: Konsonantentransienten, ausgehaltene Obertöne und breitbandige Effekte bleiben dem Separator verfügbar.
Lokale Blöcke modellieren Schläge, Plosive und Drum-Attacks; die Kommunikation über Fenstergrenzen hinweg trägt Musikteppiche, Sätze und Atmosphären. Ein einzelnes dichtes Attention-Feld ließe den Speicherbedarf mit der Dauer steil anwachsen. Locoformer verbindet lokale Mischung mit sparsamem Fernaustausch, sodass der veröffentlichte Medium-Checkpoint praktikabel bleibt.
Tabelle II berichtet 11.8 dB für SFC-Locoformer medium und 10.9 dB für BandIt unter demselben DnR-Testprotokoll. Das skaleninvariante Zielkriterium lautet:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Es stützt ein Ranking innerhalb des Protokolls, nicht jedoch Vergleiche mit MUSDB, einer anderen DnR-Revision oder handverlesenen Clips. Der Vorsprung von 0.9 dB garantiert ebenfalls nicht, dass jeder Filmausschnitt gewonnen wird; Frikative, Atmosphärenbreite und Effekttransienten verlangen weiterhin Blindhören.
Die Autoren veröffentlichen die Encoder SFC-CA, SFC-Mamba und BandIt, den TF-Locoformer-Separator sowie vortrainierte Gewichte für MUSDB18-HQ und DnR. Paper-Architektur, Repository-Implementierung und Model-Card-Dateien lassen sich damit gegeneinander prüfen; die 11.8 dB gelten weiterhin nur für das DnR-v2-Protokoll aus Tabelle II.
Die Separation von Dialog, Musik und Effekten erhielt nach der DnR Challenge 2021 eine vergleichsweise stabile Zieldefinition. BandIt konzentrierte später Modellierungskapazität auf nicht gleichmäßige Frequenzbänder, während TIGER ein günstigeres Sequenzmodell erkundete. SFC-Locoformer stellt eine andere Ingenieursfrage: Wenn benachbarte Frequenzbins redundant sind, lassen sie sich komprimieren, bevor das Modellbudget auf längere Dialog- und Partiturstrukturen verwendet wird?
Vor diesem Hintergrund gehören die drei veröffentlichten Modelle auf eine gemeinsame Aufgabenseite, ohne als schlichter Austausch von alt gegen neu beschrieben zu werden. BandIt ist eine starke Band-Split-Baseline, TIGER bietet eine rechenorientierte Alternative, und der veröffentlichte SFC-Medium-Checkpoint berichtet 11.8 dB unter demselben DnR-v2-Protokoll wie Tabelle II. Architektur, Gewichte und Evaluationsprotokoll spielen alle eine Rolle.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)komplexes EingangsspektrumA(k,f|X)eingabeadaptive BandaggregationZ(t,k)komprimierte SequenzdarstellungA ist keine feste Regel zum Beschneiden von Frequenzen. Es handelt sich um ein eingabeabhängiges Aggregationsgewicht, sodass die kürzere k-Achse mehr Sequenzkapazität für Dialog, Musik und Atmosphäre über die Zeit freigibt.
Der Decoder fragt weiterhin mit nicht komprimierten Merkmalen ab, um jedes Ausgabe-Bin wiederherzustellen. Die Gleichung ist eine Abstraktion des Informationsflusses; die prüfbare Implementierung bilden CrossAttnEncoder, CrossAttnDecoder und die adaptive Abfrage im Repository.
Paper, Code und Gewichte lassen sich über SFC-Locoformer source / Released DnR checkpoint / SFC paper and DnR table nachverfolgen.
Eingeordnet werden nur Zeilen, die unter demselben publizierten Protokoll verifiziert wurden; TIGER-DnR wird ohne passendes Ergebnis nicht in Tabelle II eingefügt.
| Modell | Publiziertes Ergebnis | Wie es zu lesen ist |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | höchster publizierter Wert in diesem Protokoll; Dialogkanten dennoch prüfen |
| BandIt | 10.9 dB SI-SDR | Band-Split-Baseline im selben Protokoll |
| TIGER-DnR | Effizienzbelege separat ausgewiesen | wird nicht in eine fehlende Tabellenzeile gemischt |
Beim Dialog auf Zischlaute, Atem und entfernte Sprache achten. SI-SDR nimmt die globale Verstärkung aus dem Vergleich, kann aber metallische Kanten und beschädigte Raumausklänge übersehen. Bei Musik auf Sprachgeister prüfen; bei Effekten die Kontinuität von Türen, Schritten und Atmosphäre bewahren.
Broadcast-Mischungen enthalten außerdem Limiting, Dialog-Ducking und Kanal-Fold-Downs. Ein DnR-Paper-Protokoll bildet nicht automatisch jeden Auslieferungsmaster ab; Vergleiche zwischen SFC, BandIt und TIGER sollten dieselben Ausschnitte verwenden und Dialogkanten, Musik-Leakage und Atmosphärenkontinuität getrennt beurteilen.
Die Effektspur ist ein breiter Sammelbehälter. Regen, Verkehr, Applaus und Foley bleiben vermischt; die DnR-Ausgabe ist daher keine Zerlegung auf Objektebene.
Vorgelagerte Lizenzbedingungen regeln weiterhin Einsatz und Weitergabe, auch wenn die Aufgabenform den Arbeitsablauf nicht mehr mit einem Lizenzvortrag unterbricht.
Modellnamen, Zahlen und Einschränkungen lassen sich auf die folgenden Papers, Repositories oder Model Cards zurückführen.