모델
SFC-Locoformer: 11.8dB DnR에 대한 적응형 스펙트럼 압축 및 대화 경계
논문 집중 독해 / 영화와 TV 소리 분리
논문 집중 독해 / 영화와 TV 소리 분리
© 2026 텔크넷. 판권 소유.
논문 읽기 / 시네마틱 분리
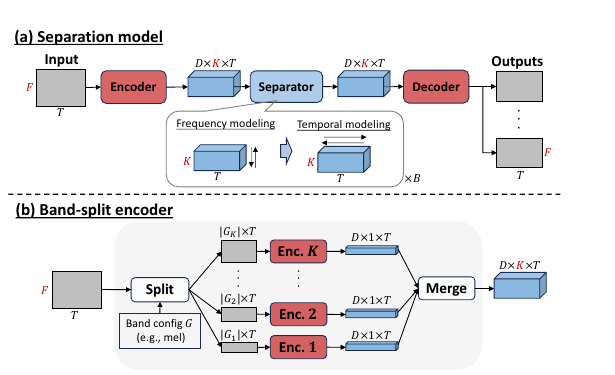
DnR은 프로그램 믹스를 대사, 음악, 효과음으로 나누는 작업입니다. 이 소스들은 시간과 주파수 양쪽에서 겹치기 때문에 단순한 음성 활동 감지 문제로 축소할 수 없습니다. SFC-Locoformer, BandIt, TIGER-DnR은 같은 과제를 서로 다른 압축 방식과 시퀀스 비용, 공개된 근거로 풀어 갑니다.
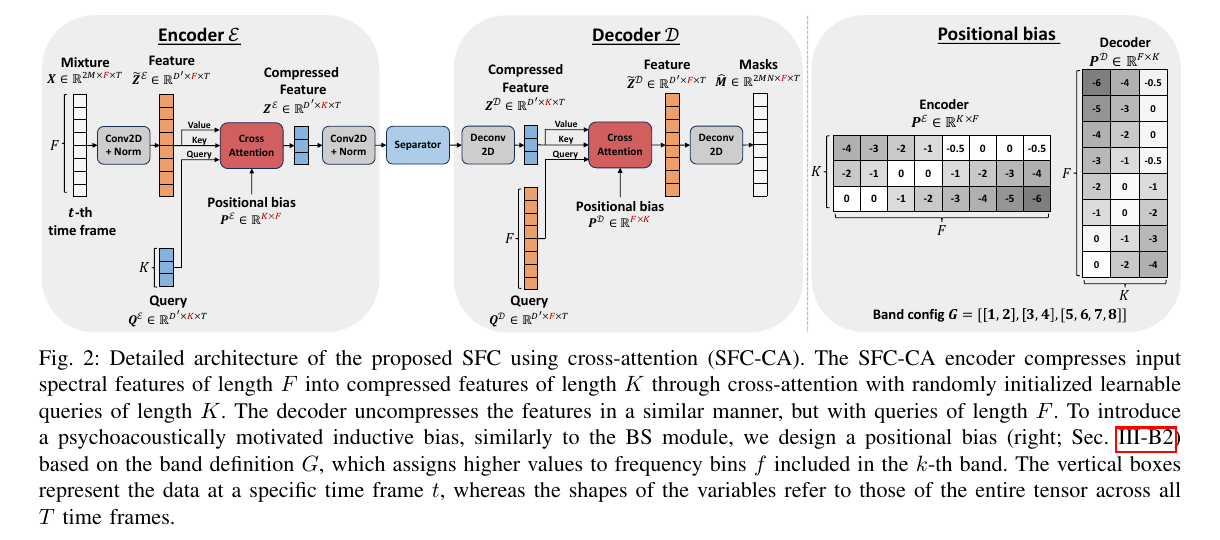
STFT는 복소 스펙트럼 X(t,f)를 만듭니다. 인접한 모든 빈에 같은 채널 예산을 할당하면 상관관계가 높은 특징에 연산을 낭비하게 됩니다. SFC는 이를 조밀한 스펙트럴 축으로 사영하는 방법을 학습합니다:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
디코더는 크로스 어텐션으로 압축된 표현을 목표 주파수 빈으로 되돌립니다. 고주파를 잘라 내는 방식이 아니므로 자음의 트랜션트, 지속되는 고조파, 광대역 효과음이 분리기에 그대로 남습니다.
국소 블록은 타격음, 파열음, 드럼 어택을 모델링하고, 윈도 사이의 정보 교환이 배경 음악, 문장, 앰비언스를 운합니다. 하나의 조밀한 어텐션 필드만 쓰면 길이에 따라 메모리가 급격히 늘어납니다. Locoformer는 국소 믹싱과 절약된 장거리 교환을 결합해 공개된 medium 체크포인트가 실용 수준에 머물게 했습니다.
Table II는 같은 DnR 테스트 프로토콜에서 SFC-Locoformer medium 11.8 dB, BandIt 10.9 dB를 보고합니다. 스케일 불변 목적 함수는 다음과 같습니다:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
이 수치가 뒷받침하는 것은 동일 프로토콜 안의 순위이지, MUSDB나 다른 DnR 리비전, 직접 고른 클립과의 비교가 아닙니다. 0.9 dB의 우세가 모든 영화 구간에서의 승리를 보장하지도 않습니다. 마찰음, 앰비언스의 폭, 효과음 트랜션트는 여전히 블라인드 청취가 필요합니다.
저자들은 SFC-CA, SFC-Mamba, BandIt 인코더와 TF-Locoformer 분리기, 사전 학습된 MUSDB18-HQ 및 DnR 가중치를 공개했습니다. 논문의 아키텍처, 저장소 구현, 모델 카드 파일을 서로 대조해 확인할 수 있습니다. 다만 11.8 dB는 여전히 Table II의 DnR v2 프로토콜에만 속하는 수치입니다.
대사·음악·효과음 분리는 2021년 DnR Challenge 이후 비교적 안정된 목표 정의를 얻었습니다. 이후 BandIt은 모델링 역량을 비균일 주파수 대역에 집중했고, TIGER는 더 저렴한 시퀀스 모델을 탐구했습니다. SFC-Locoformer가 던지는 공학적 질문은 다릅니다. 인접 주파수 빈이 중복된다면, 더 긴 대사와 악보 구조에 모델 예산을 쓰기 전에 먼저 압축할 수 있지 않을까?
이런 흐름 때문에 공개된 세 모델은 단순한 구형 대 신형의 교체 관계가 아니라 한 과제 페이지에 함께 놓여야 합니다. BandIt은 강력한 대역 분할 기준선이고, TIGER는 연산량 중심의 대안이며, 공개된 SFC medium 체크포인트는 Table II가 사용한 것과 같은 DnR v2 프로토콜에서 11.8 dB를 보고합니다. 아키텍처, 가중치, 평가 프로토콜 모두가 중요합니다.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)복소 입력 스펙트럼A(k,f|X)입력 적응형 대역 집계Z(t,k)압축된 시퀀스 표현A는 고정된 주파수 가지치기 규칙이 아닙니다. 입력에 따라 달라지는 집계 가중치이므로, 짧아진 k 축 덕분에 시간축을 따라 대사, 악보, 앰비언스에 더 많은 시퀀스 용량을 쓸 수 있습니다.
디코더는 여전히 압축되지 않은 특징으로 쿼리해 모든 출력 빈을 복원합니다. 이 수식은 정보 흐름의 추상화이며, 저장소의 CrossAttnEncoder, CrossAttnDecoder와 적응형 쿼리가 검증 가능한 실제 구현입니다.
논문, 코드, 가중치는 SFC-Locoformer 소스 / 공개된 DnR 체크포인트 / SFC 논문과 DnR 표를 통해 따라갈 수 있습니다.
여기서 순위를 매기는 것은 같은 공개 프로토콜로 검증된 행뿐이며, 대응하는 결과 없이 TIGER-DnR을 Table II에 끼워 넣지 않습니다.
| 모델 | 공개된 결과 | 읽는 법 |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | 이 프로토콜에서 공개된 최고치, 대사 가장자리는 여전히 청취 확인 필요 |
| BandIt | 10.9 dB SI-SDR | 동일 프로토콜의 대역 분할 기준선 |
| TIGER-DnR | 효율 근거는 별도로 제시 | 없는 표 행에 섞지 않음 |
대사에서는 치찰음, 숨소리, 멀리서 오는 발화를 들어 보세요. SI-SDR은 비교에서 전체 게인을 제거하지만 금속성 가장자리나 손상된 잔향 꼬리는 놓칠 수 있습니다. 음악에서는 대사 잔상을 확인하고, 효과음에서는 문 소리, 발소리, 앰비언스의 연속성을 지켜야 합니다.
방송용 믹스에는 리미팅, 대사 덕킹, 채널 폴드다울도 섞여 있습니다. DnR 논문 프로토콜이 모든 납품 마스터를 자동으로 대표하지는 않습니다. SFC, BandIt, TIGER의 비교는 같은 구간을 쓰고, 대사 가장자리, 음악 누출, 앰비언스 연속성을 각각 따로 확인해야 합니다.
효과음 스템은 폭넓은 그릇입니다. 빗소리, 교통 소음, 박수, 폴리가 한데 섞여 남기 때문에 DnR 출력은 사물 단위의 소리 분해가 아닙니다.
작업 형태가 더 이상 모델 라이선스 설교로 워크플로를 끊지는 않지만, 배포와 재배포는 여전히 상위 라이선스 조건의 지배를 받습니다.
모델 이름, 수치, 한계는 아래 논문, 저장소, 모델 카드로 거슬러 확인할 수 있습니다.