Modello
SFC-Locoformer: compressione spettrale adattiva e limiti del dialogo per DnR a 11,8 dB
Lettura intensiva di tesi/separazione del suono cinematografico e televisivo
Lettura intensiva di tesi/separazione del suono cinematografico e televisivo
© 2026 TelkNet. Tutti i diritti riservati.
LETTURA DI UN PAPER / SEPARAZIONE CINEMATOGRAFICA
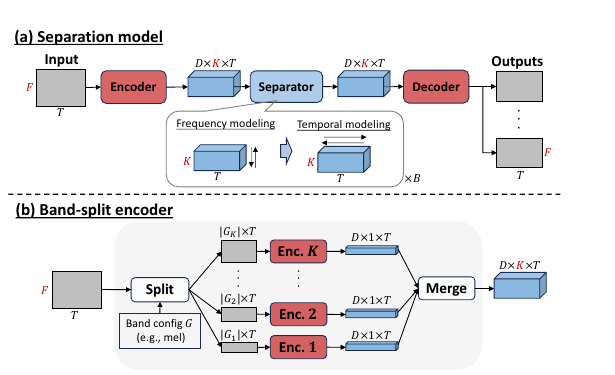
DnR separa il mix di un programma in dialoghi, musica ed effetti. Queste sorgenti si sovrappongono sia nel tempo sia in frequenza, quindi il problema non si riduce al rilevamento dell'attività vocale. SFC-Locoformer, BandIt e TIGER-DnR affrontano lo stesso compito con schemi di compressione, costi di sequenza ed evidenze pubblicate diversi.
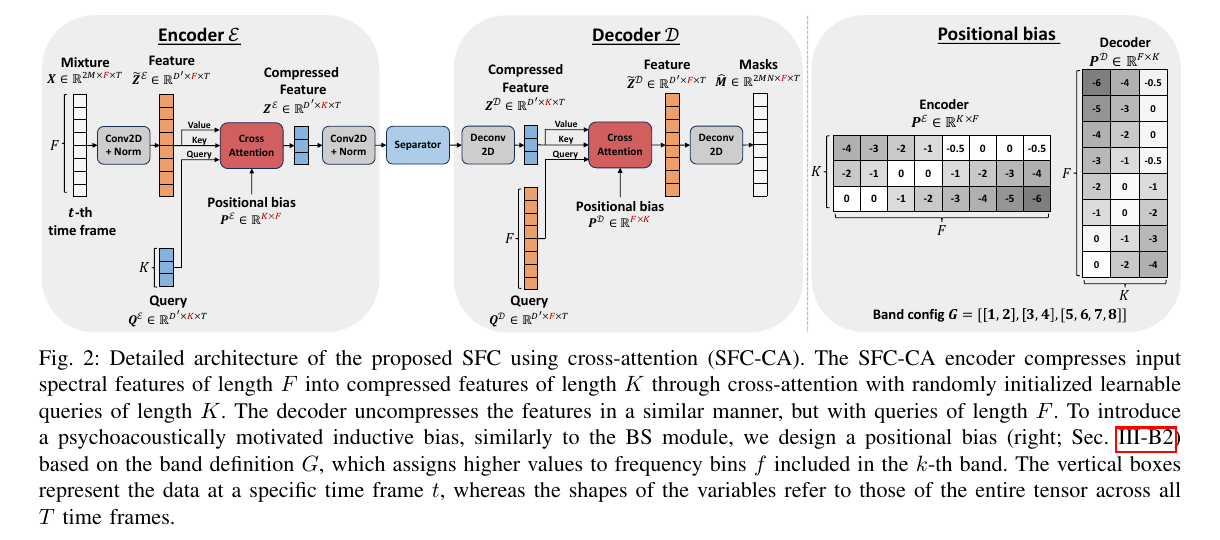
Una STFT produce lo spettro complesso X(t,f). Assegnare a ogni bin adiacente lo stesso budget di canali significa spendere calcolo su caratteristiche fortemente correlate. SFC impara una proiezione verso un asse spettrale compatto:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
Il decoder usa la cross-attention per riportare la rappresentazione compressa sui bin di frequenza target. Non si tratta di un taglio delle alte frequenze: transienti consonantici, armoniche sostenute ed effetti a banda larga restano a disposizione del separatore.
I blocchi locali modellano impatti, occlusive e attacchi di batteria; la comunicazione tra finestre trasporta tappeti musicali, frasi e ambiente. Un unico campo di attenzione densa farebbe crescere bruscamente la memoria con la durata. Locoformer combina il mixing locale con uno scambio a lungo raggio economico, così il checkpoint medium rilasciato resta pratico.
La Tabella II riporta 11.8 dB per SFC-Locoformer medium e 10.9 dB per BandIt con lo stesso protocollo di test DnR. L'obiettivo invariante di scala è:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Sostiene una classifica interna al protocollo, non confronti con MUSDB, con un'altra revisione di DnR o con clip scelte a mano. Il vantaggio di 0.9 dB non garantisce nemmeno la vittoria su ogni estratto di film: fricative, ampiezza dell'ambiente e transienti degli effetti richiedono ancora l'ascolto alla cieca.
Gli autori pubblicano gli encoder SFC-CA, SFC-Mamba e BandIt, il separatore TF-Locoformer e i pesi pre-addestrati MUSDB18-HQ e DnR. Architettura del paper, implementazione nel repository e file della model card possono quindi essere controllati l'uno contro l'altro; gli 11.8 dB restano validi solo per il protocollo DnR v2 della Tabella II.
La separazione di dialoghi, musica ed effetti ha ottenuto una definizione di obiettivo relativamente stabile dopo la DnR Challenge 2021. BandIt ha poi concentrato la capacità di modellazione su bande di frequenza non uniformi, mentre TIGER ha esplorato un modello di sequenza più economico. SFC-Locoformer pone una domanda ingegneristica diversa: se i bin di frequenza vicini sono ridondanti, si possono comprimere prima di spendere il budget del modello su strutture di dialogo e partitura più lunghe?
È questa storia a spiegare perché i tre modelli rilasciati convivono su una stessa pagina di task senza essere presentati come una semplice sostituzione dal vecchio al nuovo. BandIt è una solida baseline di band-split, TIGER offre un'alternativa orientata al calcolo, e il checkpoint SFC medium rilasciato riporta 11.8 dB con lo stesso protocollo DnR v2 usato dalla Tabella II. Architettura, pesi e protocollo di valutazione contano tutti.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)spettro complesso in ingressoA(k,f|X)aggregazione di bande adattiva all'ingressoZ(t,k)rappresentazione di sequenza compressaA non è una regola fissa di potatura delle frequenze. È un peso di aggregazione dipendente dall'ingresso, quindi l'asse k più corto lascia più capacità di sequenza a dialoghi, partitura e ambiente nel tempo.
Il decoder interroga comunque con caratteristiche non compresse per ripristinare ogni bin di uscita. L'equazione è un'astrazione del flusso informativo; CrossAttnEncoder, CrossAttnDecoder e la query adattiva nel repository sono l'implementazione verificabile.
Paper, codice e pesi si possono seguire tramite Sorgente di SFC-Locoformer / Checkpoint DnR rilasciato / Paper SFC e tabella DnR.
Sono classificate solo le righe verificate con lo stesso protocollo pubblicato; TIGER-DnR non viene inserito nella Tabella II senza un risultato corrispondente.
| Modello | Risultato pubblicato | Come leggerlo |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | valore pubblicato più alto in questo protocollo; i bordi dei dialoghi vanno comunque controllati |
| BandIt | 10.9 dB SI-SDR | baseline band-split con lo stesso protocollo |
| TIGER-DnR | evidenze di efficienza mostrate a parte | non mescolato in una riga di tabella mancante |
Sui dialoghi, ascoltare sibilanti, respiri e parlato lontano. SI-SDR elimina il guadagno globale dal confronto, ma può non cogliere bordi metallici e code ambientali danneggiate. Sulla musica, controllare la presenza di fantasmi di parlato; sugli effetti, preservare la continuità di porte, passi e ambiente.
I mix broadcast contengono anche limiting, ducking dei dialoghi e fold-down di canale. Un protocollo da paper DnR non rappresenta automaticamente ogni master di consegna; i confronti tra SFC, BandIt e TIGER dovrebbero usare gli stessi estratti e controllare separatamente bordi dei dialoghi, residui di musica e continuità dell'ambiente.
Lo stem degli effetti è un contenitore ampio. Pioggia, traffico, applausi e foley restano combinati, quindi l'uscita DnR non è una scomposizione sonora a livello di oggetto.
Le condizioni di licenza a monte continuano a regolare impiego e ridistribuzione, anche se la scheda del task non interrompe più il flusso di lavoro con una lezione sulla licenza del modello.
Nomi dei modelli, numeri e limitazioni rimandano ai paper, ai repository o alle model card elencati sotto.