モデル
SFC-Locoformer: 11.8 dB DnR の適応スペクトル圧縮と対話境界
論文の集中的な読書 / 映画とテレビの音の分離
論文の集中的な読書 / 映画とテレビの音の分離
© 2026 TelkNet。無断転載を禁じます。
論文精読 / 映画音響の分離
DnR は番組のミックスを対話、音楽、効果音に分離する。これらの音源は時間と周波数の両方で重なり合うため、この問題は音声区間の検出へと還元できない。SFC-Locoformer、BandIt、TIGER-DnR は同じ課題に、それぞれ異なる圧縮方式、系列コスト、公開された証拠で取り組んでいる。
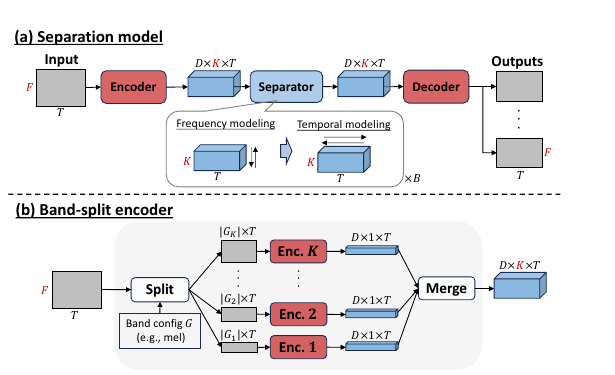
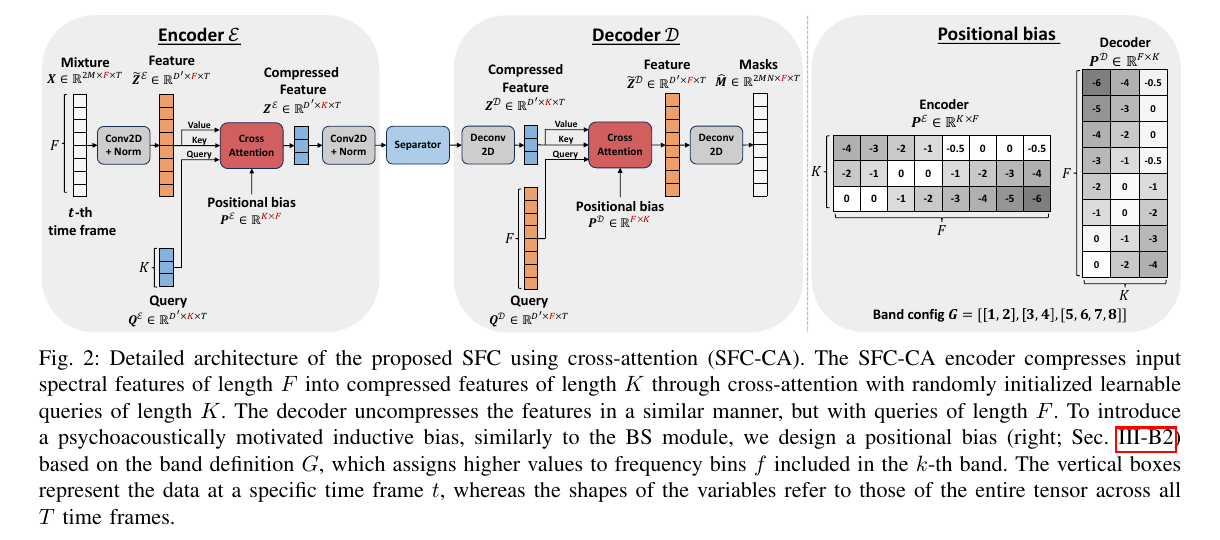
STFT は複素スペクトル X(t,f) を生成する。隣接するすべてのビンに同じチャネル予算を与えると、相関の高い特徴に計算資源を費やすことになる。SFC はコンパクトなスペクトル軸への射影を学習する。
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
デコーダはクロスアテンションを使い、圧縮された表現を目的の周波数ビンへ戻す。これは高域のカットではない。子音の立ち上がり、持続する倍音、広帯域の効果音は、分離器から引き続き利用できる。
局所ブロックは衝撃音、破裂音、ドラムのアタックをモデル化し、ウィンドウをまたぐ通信が音楽のベッド、セリフ、環境音を運ぶ。単一の密なアテンション場では、メモリは時間長に応じて急増する。Locoformer は局所的な混合と経済的な長距離交換を組み合わせ、公開されている medium チェックポイントを実用的な規模に保っている。
Table II は、同一の DnR テストプロトコルのもとで SFC-Locoformer medium が 11.8 dB、BandIt が 10.9 dB と報告している。スケール不変の目的関数は次の通りだ。
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
この値が支持するのは同一プロトコル内での順位付けであり、MUSDB、別版の DnR、恣意的に選んだクリップとの比較ではない。0.9 dB のリードがあっても、あらゆる映画の抜粋で勝つことは保証されない。摩擦音、環境音の広がり、効果音の立ち上がりは、依然としてブラインド試聴を要する。
著者らは SFC-CA、SFC-Mamba、BandIt の各エンコーダ、TF-Locoformer 分離器、そして MUSDB18-HQ と DnR の事前学習済み重みを公開している。したがって、論文のアーキテクチャ、リポジトリの実装、モデルカードのファイルは相互に照合できる。それでも 11.8 dB は、あくまで Table II の DnR v2 プロトコルにのみ属する値だ。
対話、音楽、効果音の分離は、2021 年の DnR Challenge 以降、比較的安定した課題定義を得た。その後 BandIt はモデリング能力を非一様な周波数帯へ集中させ、TIGER はより安価な系列モデルを探った。SFC-Locoformer が問うのは別の工学的な問題だ。隣接する周波数ビンが冗長であるなら、より長い対話やスコアの構造にモデルの予算を費やす前に、それらを圧縮できるのではないか。
こうした経緯があるからこそ、公開済みの 3 モデルは、単純な新旧の置き換えと説明せずに 1 つの課題として並べるのが妥当だ。BandIt は強力な帯域分割のベースラインであり、TIGER は計算量重視の代替案を提供し、公開済みの SFC medium チェックポイントは Table II と同じ DnR v2 プロトコルで 11.8 dB を報告している。アーキテクチャ、重み、評価プロトコルのどれもが結果を左右する。
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)入力の複素スペクトルA(k,f|X)入力に適応する帯域集約Z(t,k)圧縮された系列表現A は固定的な周波数の刈り込み規則ではない。入力に依存する集約の重みであり、短くなった k 軸のぶん、時間軸に沿った対話、スコア、環境音により多くの系列容量を残せる。
デコーダは圧縮されていない特徴でクエリを行い、すべての出力ビンを復元する。この式は情報の流れを抽象化したものであり、リポジトリ内の CrossAttnEncoder、CrossAttnDecoder、適応クエリが検証可能な実装である。
論文、コード、重みは SFC-Locoformer ソースリポジトリ / 公開済み DnR チェックポイント / SFC 論文と DnR テーブルからたどれる。
ここで順位付けするのは、同一の公開プロトコルで検証された行のみだ。対応する結果がない TIGER-DnR を Table II に挿入することはしない。
| モデル | 公開された結果 | 読み方 |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | このプロトコルで公開済みの最高値。対話のエッジはなお検証が必要 |
| BandIt | 10.9 dB SI-SDR | 同一プロトコルの帯域分割ベースライン |
| TIGER-DnR | 効率性の証拠は別途掲示 | 欠けている表の行に混ぜ込まない |
対話では、歯擦音、ブレス、遠くの会話に耳を澄ます。SI-SDR は比較から全体的なゲインを取り除くが、金属的なエッジや損なわれた残響の尻尾を見落とすことがある。音楽では音声のゴーストを確認し、効果音ではドア、足音、環境音の連続性が保たれているかを確かめる。
放送用ミックスには、リミッティング、対話のダッキング、チャネルのフォールドダウンも含まれる。DnR の論文プロトコルがあらゆる納品マスターを自動的に代表するわけではない。SFC、BandIt、TIGER の比較では同じ抜粋を使い、対話のエッジ、音楽の漏れ、環境音の連続性を個別に検証すべきだ。
効果音ステムは広い入れ物だ。雨、交通音、拍手、フォーリーは一つにまとめられたままなので、DnR の出力は物体レベルの音の分解ではない。
タスクの形としては、モデルライセンスの説明でワークフローが妨げられることはなくなった。それでも、上流のライセンス条件がデプロイと再配布を左右することに変わりはない。
モデル名、数値、限界は、以下の論文、リポジトリ、モデルカードにまで遡れる。