โมเดล
SFC-Locoformer: การบีบอัดสเปกตรัมแบบปรับได้และขอบเขตการสนทนาสำหรับ 11.8 dB DnR
การอ่านกระดาษ / การแยกเสียงภาพยนตร์และโทรทัศน์อย่างเข้มข้น
การอ่านกระดาษ / การแยกเสียงภาพยนตร์และโทรทัศน์อย่างเข้มข้น
© 2026 TelkNet สงวนลิขสิทธิ์.
อ่านเปเปอร์ / การแยกเสียงเชิงภาพยนตร์
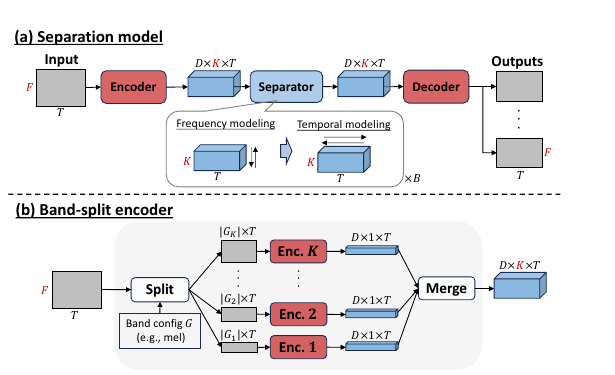
DnR แยกมิกซ์ของรายการออกเป็นเสียงพูด ดนตรี และเอฟเฟกต์ แหล่งเสียงเหล่านั้นซ้อนทับกันทั้งในแกนเวลาและความถี่ ปัญหาจึงลดทอนไปเป็นแค่การตรวจจับกิจกรรมเสียงพูดไม่ได้ SFC-Locoformer, BandIt และ TIGER-DnR รับมืองานเดียวกันด้วยรูปแบบการบีบอัด ต้นทุนด้านลำดับ และหลักฐานที่เผยแพร่ต่างกันออกไป
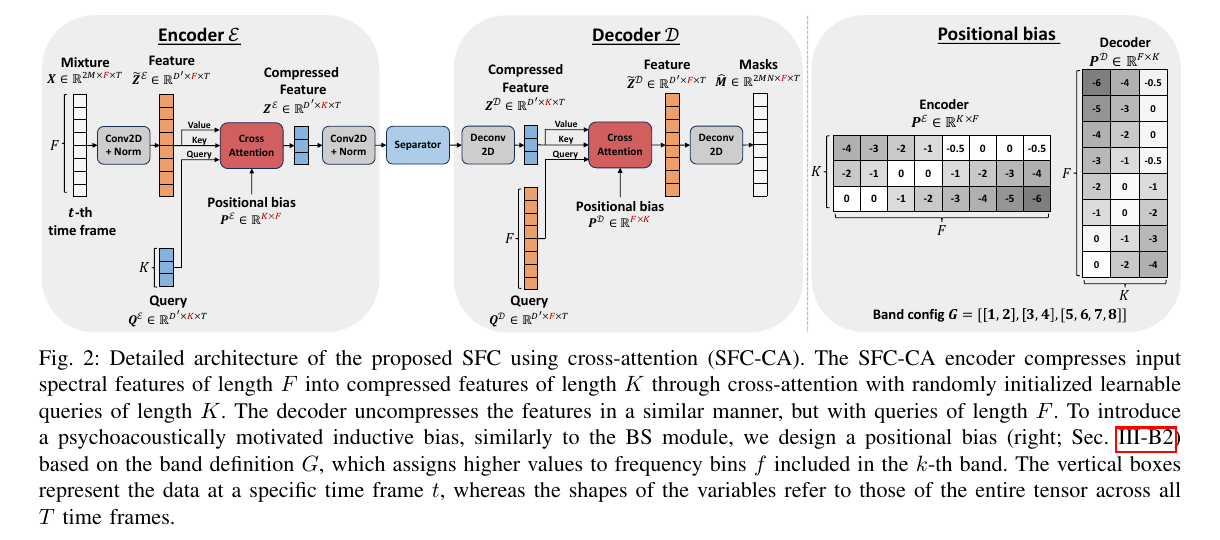
STFT ให้สเปกตรัมเชิงซ้อน X(t,f) การจัดงบช่องให้ทุก bin ที่อยู่ติดกันเท่ากันหมด คือการเผางานคำนวณไปกับฟีเจอร์ที่สัมพันธ์กันสูง SFC เรียนรู้การฉายลงบนแกนสเปกตรัมที่กะทัดรัด:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
ดีโคดเดอร์ใช้ cross-attention ส่งตัวแทนที่ถูกบีบอัดกลับไปยัง bin ความถี่เป้าหมาย นี่ไม่ใช่การตัดย่านความถี่สูงทิ้ง: ทรานเซียนต์ของพยัญชนะ ฮาร์มอนิกที่ค้างยาว และเอฟเฟกต์แถบกว้างยังพร้อมให้ตัวแยกเสียงใช้งาน
บล็อกเฉพาะที่จับแรงกระแทก เสียงพ่น และจังหวะเปิดของกลอง ส่วนการสื่อสารข้ามหน้าต่างพาแทร็กดนตรีพื้น ประโยคสนทนา และบรรยากาศเสียงไปด้วย หากใช้สนาม attention หนาแน่นเพียงอันเดียว หน่วยความจำจะพุ่งตามความยาวของสัญญาณ Locoformer ผสานการผสมเฉพาะที่เข้ากับการแลกเปลี่ยนระยะไกลแบบประหยัด จน checkpoint ขนาด medium ที่เผยแพร่ยังใช้งานได้จริง
Table II รายงาน 11.8 dB สำหรับ SFC-Locoformer medium และ 10.9 dB สำหรับ BandIt ภายใต้โปรโตคอลทดสอบ DnR เดียวกัน ฟังก์ชันเป้าหมายแบบไม่ขึ้นกับมาตราส่วนคือ:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
ค่านี้ใช้จัดอันดับภายในโปรโตคอลเดียวกันเท่านั้น ไม่ใช่ฐานเปรียบเทียบกับ MUSDB, DnR รุ่นอื่น หรือคลิปที่คัดมาเอง ส่วนแต้มนำ 0.9 dB ก็ไม่ได้การันตีว่าจะชนะทุกฉากภาพยนตร์ เสียงเสียดแทรก ความกว้างของบรรยากาศ และทรานเซียนต์ของเอฟเฟกต์ยังต้องอาศัยการฟังแบบปิดตาเสมอ
ผู้เขียนเผยแพร่เอนโคเดอร์ SFC-CA, SFC-Mamba และ BandIt ตัวแยก TF-Locoformer พร้อมน้ำหนักที่ฝึกไว้ล่วงหน้าบน MUSDB18-HQ และ DnR สถาปัตยกรรมในเปเปอร์ โค้ดในรีพอซิทอรี และไฟล์ในโมเดลการ์ดจึงตรวจสอบไขว้กันได้ ส่วนตัวเลข 11.8 dB ยังเป็นของโปรโตคอล DnR v2 ใน Table II เท่านั้น
งานแยกเสียงพูด ดนตรี และเอฟเฟกต์มีนิยามเป้าหมายที่ค่อนข้างมั่นคงหลัง DnR Challenge ปี 2021 ต่อมา BandIt มุ่งกำลังการสร้างแบบจำลองไปที่ย่านความถี่แบบไม่สม่ำเสมอ ขณะที่ TIGER ทดลองแบบจำลองลำดับที่ถูกกว่า SFC-Locoformer ตั้งคำถามวิศวกรรมคนละข้อ: ถ้า bin ความถี่ที่อยู่ใกล้กันซ้ำซ้อน จะบีบอัดมันก่อน แล้วค่อยใช้งบแบบจำลองไปกับโครงสร้างบทสนทนาและทำนองที่ยาวขึ้นได้หรือไม่
ประวัตินี้เองที่ทำให้โมเดลทั้งสามที่เผยแพร่ควรอยู่บนหน้างานเดียวกัน โดยไม่เล่าเป็นการแทนที่จากเก่าไปใหม่แบบเส้นตรง BandIt คือเส้นฐานแบบแบ่งย่านที่แข็งแกร่ง TIGER เป็นทางเลือกที่เน้นต้นทุนการคำนวณ และ checkpoint ขนาด medium ของ SFC ที่เผยแพร่รายงาน 11.8 dB ภายใต้โปรโตคอล DnR v2 เดียวกับที่ Table II ใช้ ทั้งสถาปัตยกรรม น้ำหนัก และโปรโตคอลประเมินล้วนสำคัญ
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)สเปกตรัมเชิงซ้อนของอินพุตA(k,f|X)การรวมย่านแบบปรับตามอินพุตZ(t,k)ตัวแทนลำดับที่ถูกบีบอัดA ไม่ใช่กฎตัดความถี่แบบตายตัว แต่เป็นน้ำหนักรวมที่ขึ้นกับอินพุต แกน k ที่สั้นลงจึงเหลือกำลังด้านลำดับให้เสียงพูด ทำนองเพลง และบรรยากาศตลอดแกนเวลามากขึ้น
ดีโคดเดอร์ยังคิวรีด้วยฟีเจอร์ที่ไม่ได้บีบอัดเพื่อคืนค่าทุก bin ของเอาต์พุต สมการนี้เป็นเพียงนามธรรมของกระแสข้อมูล ส่วน CrossAttnEncoder, CrossAttnDecoder และ adaptive query ในรีพอซิทอรีคือการติดตั้งจริงที่ตรวจสอบได้
ไล่ดูเปเปอร์ โค้ด และน้ำหนักได้ผ่านซอร์สของ SFC-Locoformer / checkpoint DnR ที่เผยแพร่ / เปเปอร์ SFC และตาราง DnR
ที่นี่จัดอันดับเฉพาะแถวที่ยืนยันภายใต้โปรโตคอลเดียวกันที่เผยแพร่แล้ว TIGER-DnR จึงไม่ถูกแทรกเข้า Table II เมื่อไม่มีผลที่ตรงกัน
| โมเดล | ผลที่เผยแพร่ | วิธีอ่าน |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | ค่าสูงสุดที่เผยแพร่ในโปรโตคอลนี้ ขอบเสียงพูดยังต้องตรวจด้วยหู |
| BandIt | 10.9 dB SI-SDR | เส้นฐานแบบแบ่งย่านในโปรโตคอลเดียวกัน |
| TIGER-DnR | หลักฐานด้านประสิทธิภาพแสดงแยกต่างหาก | ไม่ผสมเข้าแถวที่ไม่มีผล |
ฝั่งเสียงพูด ให้ฟังเสียงหวีดหวิว เสียงลมหายใจ และเสียงพูดไกลๆ SI-SDR ตัดเกนภาพรวมออกจากการเปรียบเทียบ แต่อาจมองข้ามขอบเสียงแหลมคมและหางเสียงห้องที่เสียหาย ฝั่งดนตรีให้ตรวจรอยเสียงพูดหลงเหลือ ส่วนฝั่งเอฟเฟกต์ต้องรักษาความต่อเนื่องของเสียงประตู เสียงฝีเท้า และบรรยากาศ
มิกซ์สำหรับงานแพร่ภาพยังมีลิมิตเตอร์ การ duck เสียงพูด และการ fold-down ช่องสัญญาณ โปรโตคอลในเปเปอร์ DnR ไม่ได้แทนมาสเตอร์ส่งมอบทุกชุดโดยอัตโนมัติ การเปรียบเทียบระหว่าง SFC, BandIt และ TIGER จึงควรใช้ช่วงเสียงชุดเดียวกัน และตรวจขอบเสียงพูด เสียงดนตรีรั่ว และความต่อเนื่องของบรรยากาศแยกกัน
สเต็มเอฟเฟกต์คือภาชนะกว้าง เสียงฝน จราจร เสียงปรบมือ และโฟลีย์ยังรวมกันอยู่ เอาต์พุตของ DnR จึงไม่ใช่การแยกเสียงระดับวัตถุ
เงื่อนไขสัญญาอนุญาตจากต้นทางยังคุมการนำไปใช้และเผยแพร่ต่อ แม้รูปแบบงานในปัจจุบันจะไม่ขัดจังหวะการทำงานด้วยคำเตือนเรื่องสัญญาอนุญาตโมเดลอีกแล้ว
ชื่อโมเดล ตัวเลข และข้อจำกัดทั้งหมดย้อนไปถึงเปเปอร์ รีพอซิทอรี หรือโมเดลการ์ดด้านล่าง