Модель
SFC-Locoformer: адаптивное спектральное сжатие и границы диалога для 11,8 дБ DnR
Интенсивное чтение дипломной работы/разделение звука кино и телевидения
Интенсивное чтение дипломной работы/разделение звука кино и телевидения
РАЗБОР СТАТЬИ / КИНЕМАТОГРАФИЧЕСКОЕ РАЗДЕЛЕНИЕ
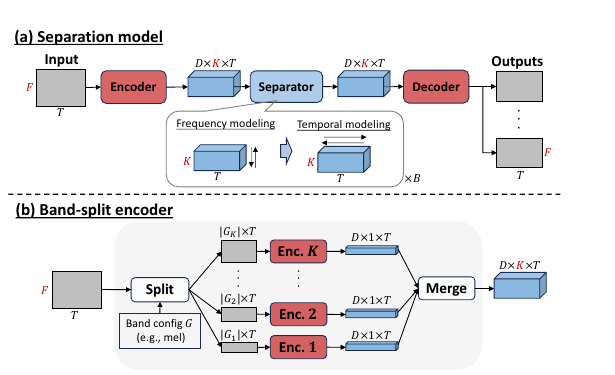
DnR раскладывает программный микс на диалоги, музыку и эффекты. Эти источники пересекаются и по времени, и по частоте, поэтому задача не сводится к детекции речевой активности. SFC-Locoformer, BandIt и TIGER-DnR решают одну и ту же задачу, но с разными схемами сжатия, затратами на последовательность и опубликованными доказательствами.
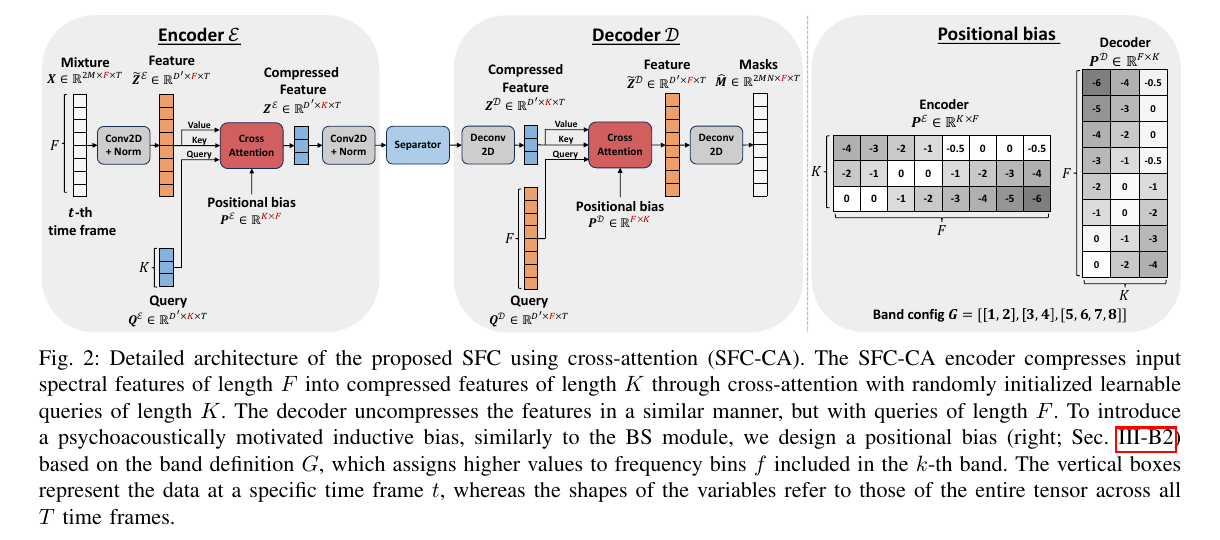
STFT даёт комплексный спектр X(t,f). Если выделять каждому соседнему бину одинаковый канальный бюджет, вычисления уходят на сильно коррелированные признаки. SFC обучает проекцию на компактную спектральную ось:
Z(t,k)=Σ_f C(k,f)·[Re X(t,f), Im X(t,f)]
Декодер с помощью перекрёстного внимания возвращает сжатое представление к целевым частотным бинам. Это не срез высоких частот: транзиенты согласных, протяжные гармоники и широкополосные эффекты остаются доступны сепаратору.
Локальные блоки моделируют удары, взрывные согласные и атаки барабанов; обмен между окнами переносит музыкальные подклады, фразы и атмосферу. Единое плотное поле внимания заставило бы память резко расти с длительностью. Locoformer сочетает локальное перемешивание с экономичным дальнодействующим обменом, поэтому опубликованный чекпоинт medium остаётся практичным.
В Table II приведены 11.8 dB для SFC-Locoformer medium и 10.9 dB для BandIt по одному и тому же тестовому протоколу DnR. Масштабно-инвариантная целевая функция:
SI-SDR=10 log10(||s_target||² / ||e_noise||²)
Она поддерживает ранжирование внутри протокола, а не сравнения с MUSDB, другой ревизией DnR или отобранными вручную клипами. Отрыв в 0.9 dB также не гарантирует победу на каждом кинофрагменте: фрикативные, ширина атмосферы и транзиенты эффектов по-прежнему требуют слепого прослушивания.
Авторы публикуют энкодеры SFC-CA, SFC-Mamba и BandIt, сепаратор TF-Locoformer и предобученные веса MUSDB18-HQ и DnR. Архитектуру из статьи, реализацию в репозитории и файлы модельных карточек можно сверить друг с другом; при этом 11.8 dB по-прежнему относится только к протоколу DnR v2 из Table II.
Разделение на диалоги, музыку и эффекты получило относительно устойчивое определение цели после DnR Challenge 2021 года. Позже BandIt сосредоточил модельную ёмкость на неравномерных частотных полосах, а TIGER исследовал более дешёвую модель последовательности. SFC-Locoformer ставит другой инженерный вопрос: если соседние частотные бины избыточны, можно ли сжать их до того, как модельный бюджет будет потрачен на протяжённую структуру диалогов и партитуры?
Именно поэтому три опубликованные модели уместны на одной странице задачи, но не должны описываться как простая замена старого новым. BandIt — сильный базовый вариант с разбиением на полосы, TIGER предлагает ориентированную на вычислительную экономию альтернативу, а опубликованный чекпоинт SFC medium показывает 11.8 dB по тому же протоколу DnR v2, что и в Table II. Важны и архитектура, и веса, и протокол оценки.
Z(t,k)=Σ_f A(k,f|X)·W_f·X(t,f)X(t,f)комплексный входной спектрA(k,f|X)адаптивная к входу агрегация полосZ(t,k)сжатое представление последовательностиA — не фиксированное правило отсечения частот. Это зависящий от входа вес агрегации, поэтому более короткая ось k оставляет больше последовательной ёмкости для диалогов, партитуры и атмосферы во времени.
Декодер по-прежнему выполняет запросы несжатыми признаками, чтобы восстановить каждый выходной бин. Уравнение — абстракция потока информации; CrossAttnEncoder, CrossAttnDecoder и адаптивный запрос в репозитории — проверяемая реализация.
Статью, код и веса можно отследить по ссылкам: исходный код SFC-Locoformer / опубликованный чекпоинт DnR / статья SFC и таблица DnR.
Здесь ранжируются только строки, проверенные по одному опубликованному протоколу; TIGER-DnR не вставляется в Table II без соответствующего результата.
| Модель | Опубликованный результат | Как это читать |
|---|---|---|
| SFC-Locoformer medium | 11.8 dB SI-SDR | наивысшее опубликованное значение в этом протоколе; края диалогов всё равно стоит проверять на слух |
| BandIt | 10.9 dB SI-SDR | база с разбиением на полосы по тому же протоколу |
| TIGER-DnR | данные об эффективности приведены отдельно | не подмешивается в отсутствующую строку таблицы |
На диалогах слушайте сибилянты, вздохи и далёкую речь. SI-SDR убирает глобальное усиление из сравнения, но может пропустить металлические края и повреждённые хвосты помещения. На музыке проверяйте речевые призвуки; на эффектах сохраняйте непрерывность дверей, шагов и атмосферы.
Вещательные миксы содержат также лимитирование, приглушение диалогов и сведение каналов. Протокол статьи DnR не представляет автоматически каждый мастер на выдачу; сравнения SFC, BandIt и TIGER должны использовать одни и те же фрагменты и отдельно проверять края диалогов, утечки музыки и непрерывность атмосферы.
Стем эффектов — широкий контейнер. Дождь, уличное движение, аплодисменты и foley остаются объединёнными, поэтому выход DnR — не декомпозиция звука на уровне объектов.
Условия апстрим-лицензий по-прежнему регулируют развёртывание и распространение, даже если форма задачи больше не прерывает рабочий процесс лекцией о лицензии на модель.
Названия моделей, числа и ограничения восходят к статьям, репозиториям или модельным карточкам ниже.